はじめに
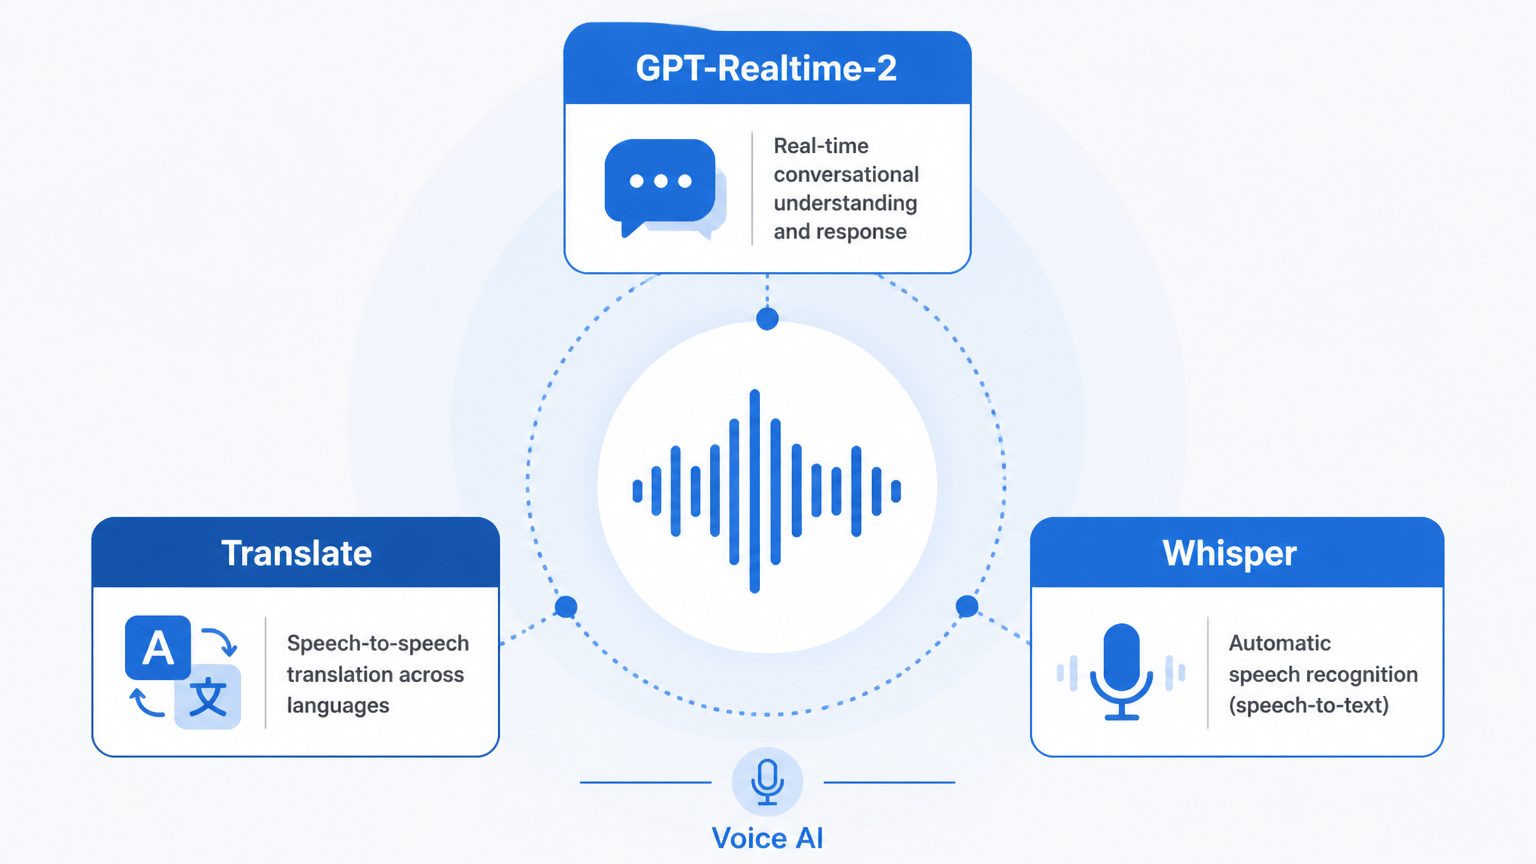
OpenAIが2026年5月7日、Realtime APIに3つの新しい音声モデルを追加しました。GPT-5クラスの推論能力を持つ「GPT-Realtime-2」、70以上の言語を13の出力言語にリアルタイム翻訳する「GPT-Realtime-Translate」、そして低遅延のストリーミング文字起こし「GPT-Realtime-Whisper」です。本稿では各モデルの特徴・性能・価格を解説します。
参考記事
- タイトル: Advancing voice intelligence with new models in the API
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年5月7日
- URL: https://openai.com/index/advancing-voice-intelligence-with-new-models-in-the-api/
関連記事

要点
- GPT-Realtime-2はGPT-5クラスの推論を搭載した音声モデルで、コンテキストウィンドウが32Kから128Kに拡大され、5段階の推論レベル調整が可能である
- Big Bench Audioで96.6%(前世代比15.2ポイント増)、Audio MultiChallengeで48.5%(同13.8ポイント増)を記録し、前世代モデルを大きく上回った
- GPT-Realtime-Translateは70以上の入力言語・13の出力言語に対応したリアルタイム音声翻訳モデルである
- GPT-Realtime-Whisperは話者の発話と同時にテキストへ変換するストリーミング文字起こしモデルである
- 3モデルはRealtime APIで提供され、Zillow・Deutsche Telekom・Vimeoなど複数企業がすでに活用テストを進めている
詳細解説
音声AIが担う3つのパターン
OpenAIによれば、音声AIの活用は現在3つのパターンに整理されています。まず「Voice-to-action(音声から操作)」は、ユーザーが話した内容をもとにシステムが推論・ツール呼び出し・タスク実行を行うパターンです。Zillowはこの形式で、物件検索から内覧予約まで音声で完結するアシスタントを構築中とのことです。
次に「Systems-to-voice(システムから音声案内)」は、カレンダーやCRMなどのデータをもとにAIが能動的に音声で通知・案内するパターンです。フライト遅延に合わせてゲート変更や乗り継ぎルートを即座に音声で伝えるようなシナリオが想定されています。
3つ目の「Voice-to-voice(音声間翻訳・対話)」は、異なる言語を話す人同士をリアルタイムで橋渡しするパターンです。Deutsche Telekomのカスタマーサポートやグローバル向けコンテンツ配信がその代表例として挙げられています。これらは単独でも組み合わせても使用でき、Pricelineはすべてのパターンを統合した旅行体験の構築を進めているとのことです。
2025年8月に公開された初代GPT-Realtimeモデルでは画像入力や電話連携が追加されましたが、今回の発表はそこからさらに推論能力・多言語対応・文字起こしの各領域を独立したモデルとして強化した位置づけと言えます。
GPT-Realtime-2:推論力と制御性の向上
GPT-Realtime-2は前世代の「GPT-Realtime-1.5」と比べて複数の点で改善されています。
コンテキストウィンドウが32Kトークンから128Kトークンへ拡大され、より長い会話や複雑なエージェントワークフローへの対応力が高まりました。ツール呼び出しについては複数ツールの並列実行が可能になり、処理中に「カレンダーを確認しています」といった音声フィードバックをユーザーに返せるようになっています。
推論レベルはminimal・low・medium・high・xhighの5段階から選択でき、デフォルトはlowです。シンプルな対話では低遅延を優先し、複雑なリクエストでは高い推論精度を発揮する設計で、開発者が用途に合わせて調整できます。
また応答前に「少しお待ちください」のような短いフレーズ(Preamble)を挿入する機能や、エラー発生時に会話を途切らせずに「現在対応が難しい状況です」と返す回復動作の改善も追加されています。医療・不動産など専門用語が多い分野での語彙保持精度も向上しているとのことです。
ベンチマーク面では、GPT-Realtime-2(high)がBig Bench Audio(音声入力に対する推論能力評価)で96.6%を記録し、GPT-Realtime-1.5の81.4%から15.2ポイント向上しました。多ターン会話での指示追従・文脈統合を評価するAudio MultiChallengeでは、GPT-Realtime-2(xhigh)が48.5%に対しGPT-Realtime-1.5は34.7%で、13.8ポイントの改善となっています。
Zillowの社内評価では、プロンプト最適化後の難易度の高い通話ベンチマークで成功率が69%から95%へ26ポイント向上したと報告されています。住宅公正取引(フェアハウジング)コンプライアンスへの対応強度も改善されており、本番環境での信頼性を高める要因のひとつと考えられます。
GPT-Realtime-Translate:多言語会話をリアルタイムで橋渡し
GPT-Realtime-Translateは70以上の入力言語を13の出力言語にリアルタイム翻訳する音声モデルです。話者の発話に追従しながら翻訳が進む設計で、地域ごとの発音の違いやドメイン固有の専門用語にも対応するとOpenAIは説明しています。
Deutsche Telekomは顧客が母語で話せる多言語音声サポートに向けてテストを実施中です。インドのVoice AI企業BolnaAIによれば、ヒンディー語・タミル語・テルグ語の評価でWord Error Rate(単語誤認識率)が他モデルより12.5%低く、タスク完了率・レイテンシともに優れた結果が得られたとのことです。VimeoはOpenAIがデモとして公開した映像で、製品説明動画をリアルタイムに翻訳してグローバル展開するシナリオを示しています。
リアルタイム翻訳を実用化するうえでのボトルネックはレイテンシと専門語彙の処理にあります。この2点での改善が報告されていることは、業務向けユースケースへの適用可能性を高める要因になると思います。
GPT-Realtime-Whisper:会話と同時に進む文字起こし
GPT-Realtime-Whisperは低遅延のストリーミング音声認識モデルです。話者が発言しながらリアルタイムでテキストへ変換されるため、会議字幕・議事録生成・カスタマーサポートの通話要約など、様々な業務フローへの統合が可能です。
従来の音声認識は発話終了後にまとめて処理するバッチ方式が主流で、リアルタイム性に限界がありました。ストリーミング方式は音声入力と同時に処理が進むため、発話に追従した字幕表示や会話中のメモ生成といった体験が実現できます。医療・採用・営業など口頭情報が重要な業種での活用が想定されています。
価格と安全設計
3モデルはいずれもRealtime APIで提供されています。OpenAIの発表によれば、GPT-Realtime-2は音声入力トークン100万あたり32ドル(キャッシュ入力は0.40ドル)、音声出力トークン100万あたり64ドルです。GPT-Realtime-Translateは1分あたり0.034ドル、GPT-Realtime-Whisperは1分あたり0.017ドルとなっています。
安全設計については、Realtime APIのセッション上で有害コンテンツガイドライン違反が検出された際にセッションを停止するアクティブ分類器がリアルタイムで稼働しています。開発者はAgents SDKを用いて追加のガードレールを実装することも可能で、EUデータ居住地要件にも対応しています。エンドユーザーに対してAIと対話中であることを明示する義務も利用規約に含まれています。
まとめ
OpenAIが公開した3つの音声モデルは、推論・翻訳・文字起こしという異なる機能を用途別に提供することで、リアルタイム音声AIの実装選択肢を広げています。Zillow・Deutsche Telekom・Pricelineといった実装事例も参考に、自社サービスへの適用可能性を検討してみてはいかがでしょうか。音声インターフェース設計の基礎については、Googleの音声AIモデルの解説記事もあわせてご覧いただければと思います。