はじめに
Google Cloudの研究チームが2026年4月21日、エージェントが成功・失敗の両経験から汎化可能な推論パターンを蒸留する新しいメモリフレームワーク「ReasoningBank」を発表しました。ICLR 2026に採択された研究論文とともに、コードをオープンソースで公開しています。本稿では、その仕組みと性能評価の詳細を解説します。
参考記事
- タイトル: ReasoningBank: Enabling agents to learn from experience
- 著者: Jun Yan, Chen-Yu Lee(Google Cloud Research Scientists)
- 発行元: Google Research Blog
- 発行日: 2026年4月21日
- URL: https://research.google/blog/reasoningbank-enabling-agents-to-learn-from-experience/
関連記事
要点
- ReasoningBankは、エージェントが成功・失敗の両経験から「汎化可能な推論パターン」を蒸留し、次のタスクに活かす新しいメモリフレームワークである
- Gemini 2.5 Flashを用いたWebArenaおよびSWE-Bench-Verifiedの評価で、メモリなし手法と比べてそれぞれ成功率が8.3%・4.6%向上した
- SWE-Bench-Verifiedでは1タスク当たり平均約3ステップを削減するなど、実行効率も改善されている
- Memory-Aware Test-Time Scaling(MaTTS)との組み合わせにより、さらに成功率が3%向上・ステップ数が0.4削減できる
- コードはApache-2.0ライセンスでGitHubに公開されており、GPT・Gemini・Claudeの3モデルファミリーに対応している
詳細解説
既存手法の限界と「失敗から学ぶ」メモリ
AIエージェントが現実世界のタスクを担う場面が増えるにつれ、「同じ失敗を繰り返す」という課題が顕在化しています。既存のメモリ手法は大きく2つに分かれます。ひとつは、Synapseのように過去のすべての行動軌跡(トラジェクトリ)を記録するアプローチです。もうひとつは、Agent Workflow Memory(AWM)のように成功した手順だけをワークフローとして保存するアプローチです。
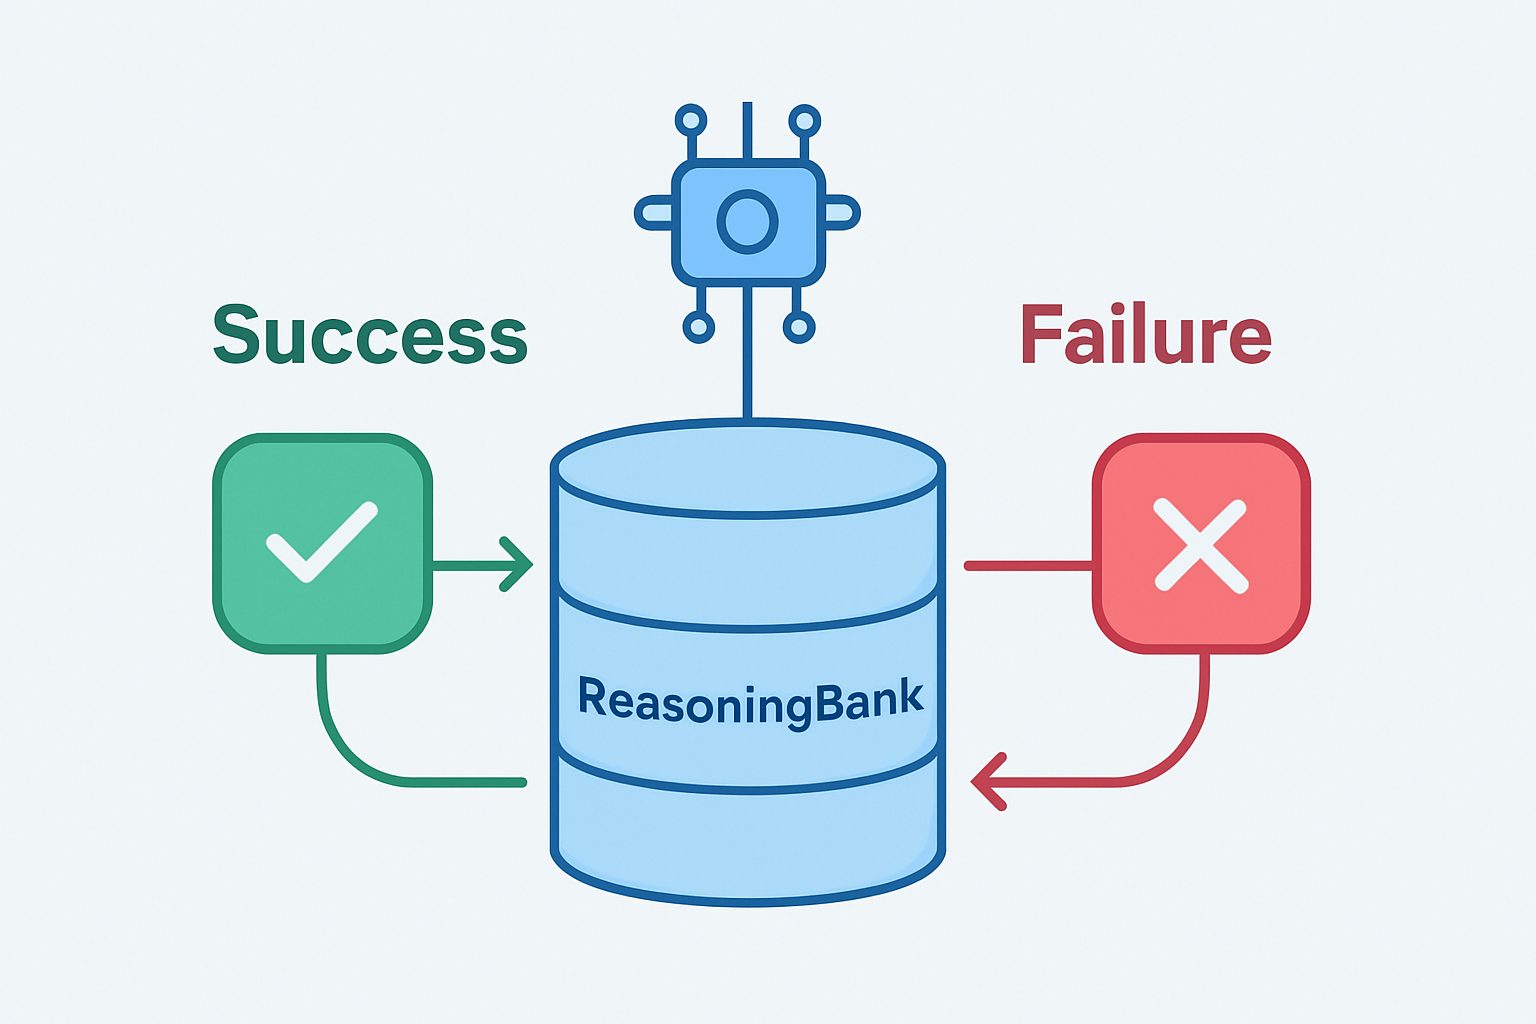
Google Cloudの研究チームによれば、これらには共通の弱点があります。行動の詳細記録は戦略的な洞察を蒸留できず、成功経験のみへの注目は、最も実りある学習源である「失敗」を見落とします。ReasoningBankはこのギャップを埋めるために設計されており、成功・失敗の両方から抽象度の高い推論パターンを引き出すことが特徴です。
メモリの構造と動作ワークフロー
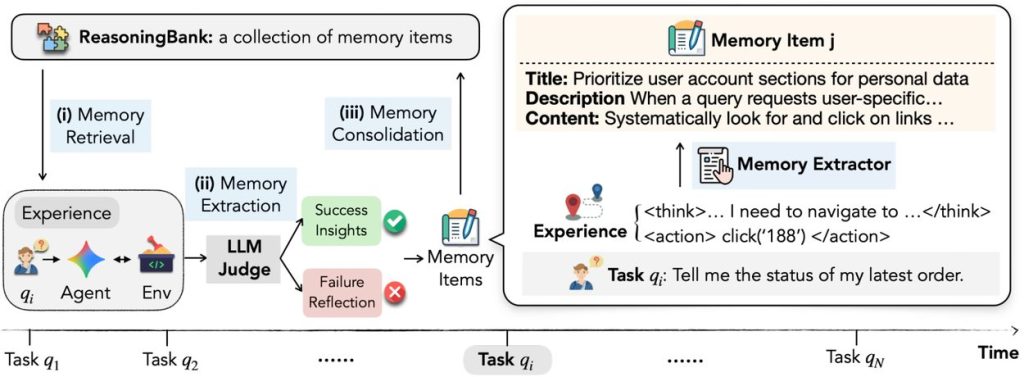
ReasoningBankが保存するメモリは、タイトル(コア戦略の要約)、説明(概要)、内容(蒸留された推論ステップや意思決定の根拠)という3要素で構成された構造化アイテムです。単純な手順チェックリストではなく、「なぜその行動を取るべきか」「何を避けるべきか」という上位の判断指針を保持する点が従来手法との大きな違いです。
動作サイクルは「取得 → 実行 → 評価 → 蒸留」という閉ループで回ります。タスク実行前にReasoningBankから関連メモリを取得してコンテキストに加え、実行後にはLLM-as-a-judgeによって結果を自己評価します。興味深いのは、この自己評価が完璧でなくてもよい点で、研究チームはReasoningBankが評価ノイズに対してかなりロバストであることを確認しています。失敗した経験については反事実的シグナルとして分析され、「ページフィルターが有効な状態でデータセットを取得しようとするとページネーションが切れる」といった予防的な教訓として記憶されます。このように、具体的な操作手順ではなく戦略的ガードレールを形成していく点が、ReasoningBankの核心にあります。
Memory-Aware Test-Time Scaling(MaTTS)
テスト時スケーリング(TTS)とは、推論時に計算リソースを増やすことでモデルの出力品質を高める手法で、数学や競技プログラミングの分野で有効性が示されています。しかし従来のエージェント向けTTSでは、探索過程で生じた豊富な経験が捨てられ、最終的な答えだけが使われていました。
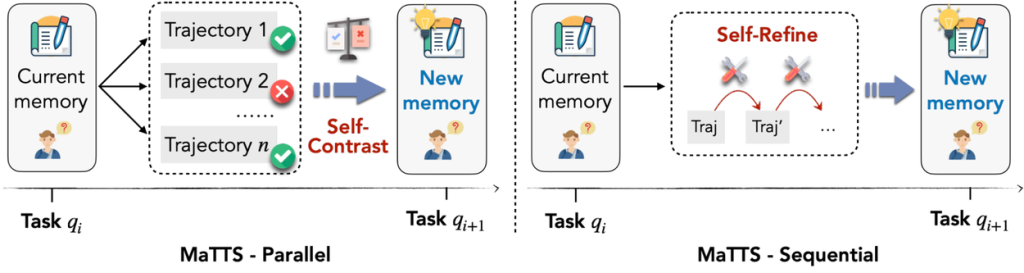
ReasoningBankはこの探索過程を記憶学習のデータ源として活用するMaTTS(Memory-Aware Test-Time Scaling)を提案しています。具体的には2つの形式があります。並列スケーリングでは、同一クエリに対して複数の軌跡を生成し、成功・失敗を対比させることでより頑健な戦略を蒸留します。逐次スケーリングでは、単一の軌跡内で反復的な推論改善を行い、途中の試行錯誤を高品質なメモリとして捉えます。高品質なメモリが探索をより有望な方向へ誘導し、その豊富な探索がさらにメモリの質を高めるという相互強化の構造が、MaTTSの設計思想です。
ベンチマーク評価と「戦略的成熟度」の創発
評価にはウェブブラウジングタスクのWebArenaとソフトウェアエンジニアリングタスクのSWE-Bench-Verifiedという、難易度の異なる2種類のベンチマークが使われました。基盤モデルにはGemini 2.5 Flashを使用し、メモリなし(Vanilla ReAct)、Synapse(軌跡メモリ)、AWM(ワークフローメモリ)の3手法と比較しています。
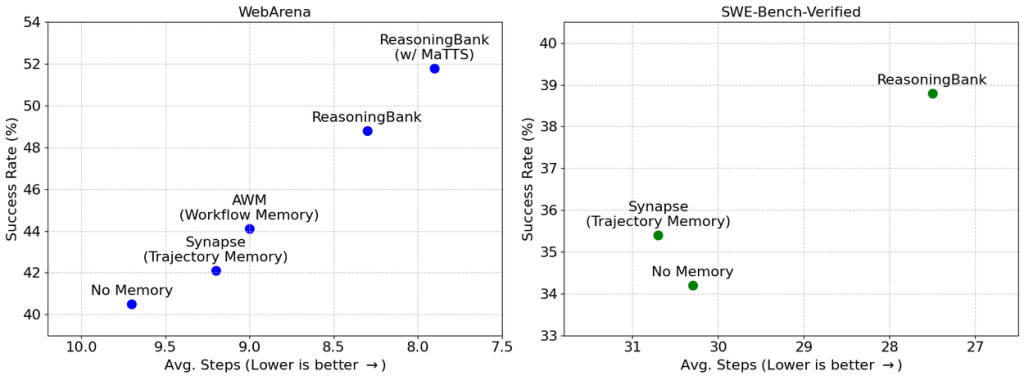
Googleの発表によれば、ReasoningBank単体でメモリなし手法と比較してWebArenaで 8.3%、SWE-Bench-Verifiedで 4.6% の成功率向上を達成しました。効率面でも、SWE-Bench-Verifiedにおいて1タスク当たり約3ステップの削減が確認されています。MaTTS(並列スケーリング、スケーリング係数k=5)を加えると、ReasoningBank単体からさらに 3% の成功率向上と 0.4ステップ の削減が実現しました。
評価中に観察された「戦略的成熟度の創発」も注目に値します。初期のメモリは「ページリンクを探す」といった単純なチェックリストに近いものでしたが、タスクを積み重ねるうちに「アクティブなページフィルターを継続的に照合し、データセットが早期に途切れていないか確認する」といった複合的・予防的なロジック構造へと自律的に進化したことが確認されています。これはエージェントが単純なルール暗記を超え、経験から戦略的知識を自己構築していることを示す興味深い観察だと思います。
実装と対応モデル
GitHubで公開されているコードはWebArenaとSWE-Benchの2環境に対応しており、Apache-2.0ライセンスで利用できます。対応モデルはGPT系(gpt-3.5-turbo、gpt-4、gpt-4o)、Gemini系(gemini-2.5-flash、gemini-2.5-pro)、およびClaude(claude-3-7-sonnet)の3ファミリーで、Vertex AI経由での利用も想定されています。WebArena環境にはBrowserGymとDockerのセットアップが必要であり、実際の実験環境構築には一定の準備が必要だと考えられます。
まとめ
ReasoningBankは、エージェントが失敗経験をも学習源として活用することで継続的に自己進化するという、実用的な課題に正面から取り組んだ研究です。ベンチマーク上の成果に加え、メモリの「戦略的成熟度」が自律的に向上するという現象は、長期稼働型エージェントの設計に新たな視点を与えてくれると思います。エージェントのメモリ設計全般に関心がある方は、直近のエージェント監視・観測の課題を取り上げた記事(https://jobirun.com/observability-agentic-ai-era-ibm-insights/)もあわせてご参照いただければと思います。