はじめに
IBMのシニアプロダクトマーケティングマネージャー Ray Beharry氏が2026年4月16日、企業AIが現実の業務環境で失敗する構造的原因を論じた記事を発表しました。IBMは昨年9月にも同テーマを取り上げており(https://jobirun.com/why-ai-stalls-and-how-to-solve-it/)、今回はその核心にある「コンテキストギャップ」という概念とその解決策について解説します。
参考記事
- タイトル: The context gap: Why AI systems fail in the real world
- 著者: Ray Beharry
- 発行元: IBM Think
- 発行日: 2026年4月16日
- URL: https://www.ibm.com/think/insights/context-gap-why-ai-systems-fail-real-world
関連記事


要点
- 企業AIが失敗する根本原因は、モデルの性能不足ではなく「コンテキストギャップ」、すなわちAIがポリシーや承認状態などのエンタープライズ制約を認識できないことにある
- Gartnerによれば、AIに対応したデータ基盤がない場合、2026年末までに企業AIプロジェクトの60%が放棄されると予測されている
- MIT NANDAイニシアティブの調査では、エンタープライズ生成AIプロジェクトの最大95%がROIを出せていないとされており、その主因はモデルの限界ではなくコンテキスト管理の失敗にあるとされている
- エージェントAIへの移行により、AIが直接ワークフローを実行するようになると、コンテキストギャップに起因するリスクが顕在化しやすくなる
- 解決策として「コンテキストエンジニアリング」が提唱されており、データ・意味・ガバナンスを単一の運用レイヤーに統合する設計アプローチが必要とされている
詳細解説
AIは「出力」できるが「判断」できない
Beharry氏は、グローバル小売企業の価格最適化AIの導入事例から論考を始めます。テスト環境では優れた成果を上げたシステムが、本番運用へ移行した途端に問題を露出しました。地域間で価格が一貫しない、契約上の制約が無視される、すでにプロモーション中の商品に別の推奨が生成される、社内ポリシーと矛盾する提案が行われる——こうした問題が次々と発生したといいます。
ここで重要なのは、これがモデルの欠陥ではないという点です。企業AI失敗の典型的な対応として、より高性能なモデルの導入、プロンプトの改善、より高度な検索基盤の整備が挙げられますが、Beharry氏はこれらがいずれも本質的な問題に対処できていないと指摘します。「問われているのはモデルの能力ではなく、実際の環境の中で動作できるかどうかだ」という視点は、多くのエンタープライズAI導入の現場が感じている実感に近いかもしれません。
「コンテキストギャップ」とは何か
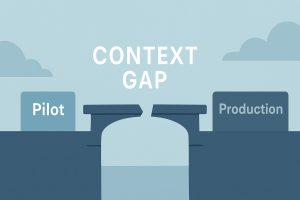
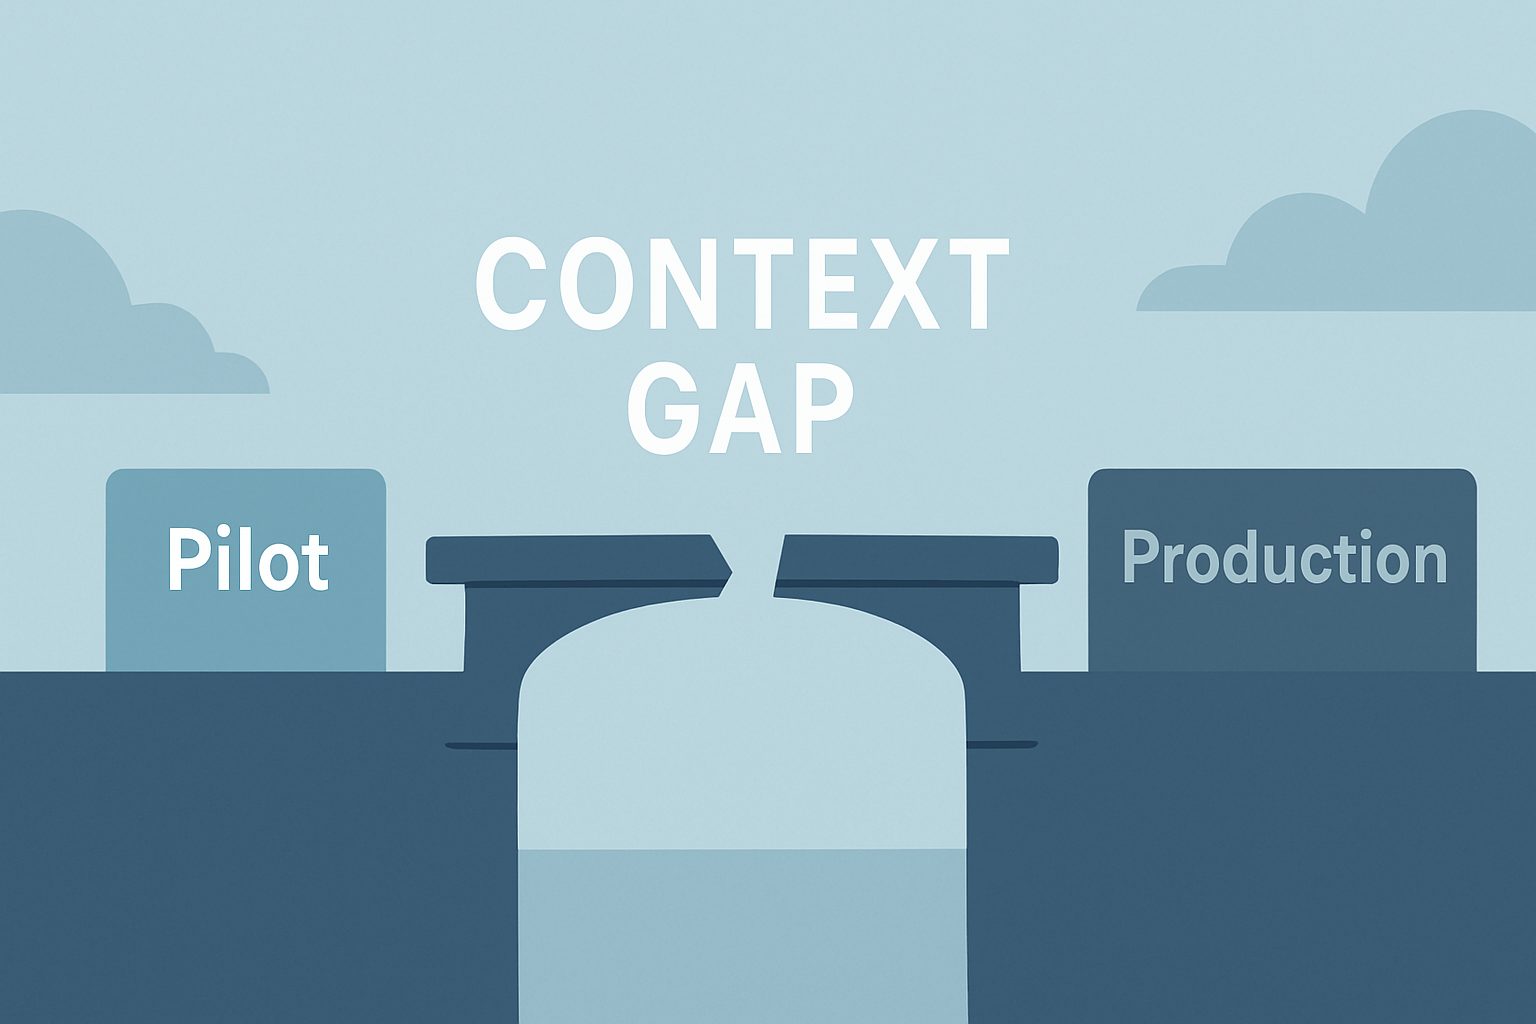
「コンテキストギャップ」とは、AIシステムがアクセスできる情報と、実際の業務判断に必要な情報との間のギャップのことです。AIは売上数値を取得できますが、それが暫定値なのか確定値なのかを識別できません。推奨を生成できますが、それがポリシーに違反するかどうかを認識できません。技術的には正しい答えを返しながら、実際の業務に使えないアウトプットになる——これがコンテキストギャップの典型的な現れ方です。
このギャップがある限り、企業AIは「パイロット止まり」になりがちです。IBMによれば、MIT NANDAイニシアティブの調査ではエンタープライズ生成AIプロジェクトの最大95%がROIを出せていないとされており、その主因をモデルの洗練度ではなく、コンテキストと業務ワークフローへの統合の失敗にあると分析しています。また、Gartnerは2026年末までに60%の企業AIプロジェクトが放棄されると予測しており、AI対応データ基盤の欠如がその主因として挙げられています。
コンテキストギャップが生じる典型パターンとしてBeharry氏は3つを挙げています。①データが変化したことに気づかず古い情報に依存する、②過剰でフィルタリングされていないデータを取り込みノイズとエラーを生む、③ポリシー・事例・観察結果を同一の重みで扱い区別できない——これらはいずれも、情報を検索できても、その情報をどう使うべきかを理解できないシステムの構造的な問題です。
パイロットが本番に移行できない理由
パイロット段階では問題が顕在化しにくい理由があります。テスト環境はキュレートされたデータ、整合のとれた定義、簡素化された業務制約で設計されることが多く、さらに人間の監視がアウトプットを検証しエラーの伝播を防ぎます。ほとんどのシステムはこうした特殊な条件下では良好に機能します。
しかし本番環境に移行すると、システムはフラグメント化されたデータ、地域や事業部門をまたいで異なるポリシー、開発中には見えなかった依存関係に直面します。アウトプット自体は生成され続けるものの、実際に活用するには解釈・照合・検証が必要になります。McKinseyを含む複数の業界調査が繰り返し指摘する主要な課題が 「データの断片化・ガバナンスの複雑さ・ワークフローへの統合困難」 である点と、これは一致しています。
エージェントAIがリスクを可視化する
エージェントAIへの移行は、コンテキストギャップをいっそう深刻な問題にします。従来型AIは出力を生成し、人間が判断・承認・実行するという流れでした。しかしエージェントAIは異なります。ワークフローを開始し、システムを更新し、決定を直接実行します。出力と結果の間に人間が介在する余地が大幅に縮小されるため、コンテキストを誤認したまま行動が実行されるリスクが高まります。
この変化はリスクの性質そのものを変えます。アウトプットの精度は依然として重要ですが、それ以上に「許可されているか」「どんな制約が適用されるか」「条件は満たされているか」を行動前に判断できるかどうかが問われます。Beharry氏は「この段階では、問題はアウトプットの品質だけではなく、コントロールの問題になる」と述べており、エージェントAIの実用化には制約の認識と遵守が不可欠だと考えられます。
なぜ既存のアプローチでは不十分なのか
RAGパイプライン、ベクターデータベース、セマンティックレイヤーなど、現在主流のアプローチはデータへのアクセス改善には有効です。しかしBeharry氏は、データアクセスの向上と意思決定の信頼性向上は別物だと指摘します。
セマンティックレイヤーは定義を標準化できますが、承認状態の把握やポリシーの執行はできません。データの一元化はアクセスを簡素化しますが、規制上・業務上の制約を取り除くことはなく、むしろ新たなリスクを生む可能性もあります。「より多くのデータとより多くの出力があっても、信頼性や実用性が対応して向上するわけではない」という指摘は、実感を持って受け取れる企業も多いと思います。
エンタープライズ環境は単なるデータの集合体ではなく、ポリシー・承認プロセス・規制・ワークフローという制約の体系の上に成り立っています。そしてこれらの多くは構造化データとして存在しておらず、ドキュメント・プロセス・組織的な知識として分散しています。現在のAIアーキテクチャはこうした環境への最適化という点で不十分であり、ここに「アーキテクチャとしての失敗」があるとBeharry氏は論じます。
コンテキストエンジニアリングという設計思想
解決策として提示されるのが 「コンテキストエンジニアリング」 です。これはモデルの改善や検索技術の向上に留まらず、データ・意味・ガバナンスを単一の運用レイヤーに統合し、AIがエンタープライズの制約の中で機能できる基盤を構築するというアプローチです。
「コンテキストエンジニアリングがなければ、AIは依然として補助的な存在に留まる。それがあることで、システムは定義された境界の中でより自律的に動作できる」とBeharry氏は述べています。RAGや検索精度の改善の延長線上にある話ではなく、AIシステムの設計思想そのものの転換を求める提言と言えます。
コンテキストエンジニアリングという概念は2025年頃からAI開発コミュニティで注目されはじめており、検索精度の最適化とコンテキスト制御・管理の設計を区別する視点として議論が積み上げられています。Beharry氏の論考は、この概念をエンタープライズAIの失敗分析と結びつけた点で実践的な示唆を持つと思います。なお、IBMはこのアプローチを支える具体的な製品として watsonx.data を提示していますが、本論考が提起するコンテキストギャップという問題設定は、特定製品に依存しない普遍的な設計課題として読むことができます。
まとめ
IBMが提起する「コンテキストギャップ」という視点は、パイロット成功後に本番展開で躓く企業にとって、問題の所在を整理する上で参考になると思います。モデルやRAGの改善だけでなく、AIがポリシーや制約の中で動作できる設計そのものを問い直すことが、エンタープライズAI活用の次のステップだと思います。エージェントAIが頓挫しやすい背景をより詳しく知りたい方は、過去記事もあわせてご覧いただければと思います(https://jobirun.com/why-40-percent-of-agentic-ai-projects-will-fail/)。