はじめに
Googleが2026年4月15日、テキスト読み上げ(TTS)の最新モデル「Gemini 3.1 Flash TTS」を発表しました。新たに導入された「音声タグ」機能により、声のトーンや速度・アクセントをテキスト内の自然言語で直感的に制御できるようになっています。本稿ではその機能と利用方法、性能評価の詳細を解説します。
参考記事
- タイトル: Gemini 3.1 Flash TTS: the next generation of expressive AI speech
- 著者: Vilobh Meshram(Senior Product Manager)、Max Gubin(Principal Research Engineer)
- 発行元: Google Blog
- 発行日: 2026年4月15日
- URL: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-1-flash-tts/
関連記事
要点
- Gemini 3.1 Flash TTSは音声品質・表現力・操作性を向上させた最新のテキスト読み上げモデルであり、Gemini API・Google AI Studio・Vertex AI・Google Vidsで提供されている
- Artificial Analysis TTSリーダーボードにおいてEloスコア1,211を記録し、「高品質かつ低コスト」の象限に位置づけられている
- 新機能「音声タグ」により、テキスト内に自然言語で指示を埋め込むことで声のスタイル・速度・アクセントを文中でリアルタイムに変更できる
- シーン設定・キャラクターごとのプロファイル・音声パラメーターのAPIコードエクスポートという「ディレクター機能」が開発者向けに提供されている
- 生成された音声にはAI生成コンテンツの検出を可能にする「SynthID」ウォーターマークが自動的に付与される
詳細解説
Gemini 3.1 Flash TTSとは
Gemini 3.1 Flash TTSは、Googleが開発した最新のテキスト読み上げ(Text-to-Speech、TTS)モデルです。TTSとは、文字データを人間の発話に近い音声に変換する技術で、音声アシスタントや有声ニュース、オーディオブック生成などに広く活用されています。
Googleによれば、今回のモデルは従来比で自然さと表現力が向上しており、「これまでで最も自然で豊かな表現力を持つモデル」と位置づけられています。開発者向けにはGemini APIとGoogle AI Studio、企業向けにはVertex AI、Googleのオフィスツール利用者向けにはGoogle Vidsを通じて、それぞれプレビュー提供が開始されています。
性能評価:Artificial Analysisのリーダーボードで上位
Googleの発表によれば、Gemini 3.1 Flash TTSはArtificial Analysis TTSリーダーボードでEloスコア1,211を記録しました。このリーダーボードは、数千件の人間によるブラインド評価(生成した音声のどちらが自然か判断させるテスト)を集計した指標です。特定の企業が設けた内部基準ではなく、第三者機関による評価であるため、信頼性の高い参考値だと考えられます。
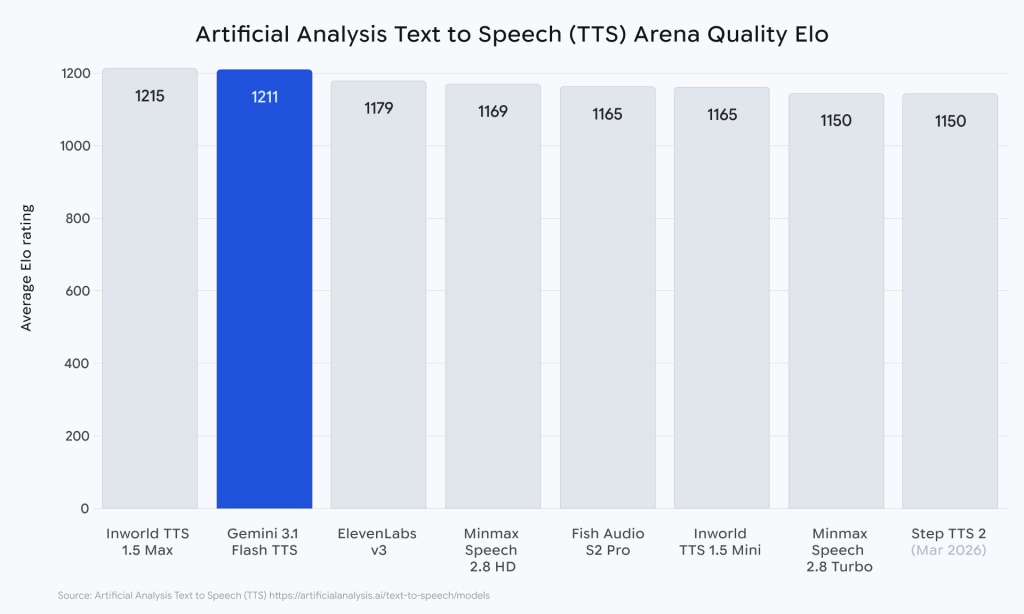
さらにArtificial AnalysisはGemini 3.1 Flash TTSを「最も魅力的な象限(most attractive quadrant)」に位置づけています。これは高い音声品質と低いコストを両立するモデルを示す区分で、商用利用を検討している開発者にとって実用的な選択肢になると思います。
また、70言語以上のネイティブ対応に加え、複数話者が自然に会話するマルチスピーカーダイアログ機能も備えています。多言語化が進むグローバルな音声アプリケーションへの適用に向けて、対応言語の幅広さは重要な要素だと考えられます。
新機能「音声タグ」—テキストに指示を埋め込む
Gemini 3.1 Flash TTSの中心的な新機能が「音声タグ(audio tags)」です。これは、読み上げるテキストの中に自然言語の指示を直接埋め込むことで、AIの発話スタイルをコントロールする仕組みです。
従来のTTSでは、速度や音量といったパラメーターを数値で設定する形式が一般的でした。音声タグを使うと、たとえば「ここは驚いた口調で」「少しゆっくり話して」といった表現を文中に自然に組み込むことができ、文の途中で発話スタイルを切り替えることも可能です。Googleは「これにより、単純なテキストを高品質な声の演技に変換できる」と説明しています。
開発者向け「ディレクター機能」の詳細
Googleはこの音声タグと合わせて、開発者が「ディレクターの席に座る」ようなイメージで音声を設計できる機能群を提供しています。
まず シーン設定(Scene direction) では、どのような場面でどのキャラクターがどう話すかという文脈を事前に定義できます。この設定により、複数の話者が「キャラクターらしさ」を保ちながら自然にやり取りする音声を生成しやすくなります。
次に 話者ごとの個別設定(Speaker-level specificity) では、キャラクターに固有の「Audio Profile」を割り当て、速度・トーン・アクセントの方向性を設定できます。さらに文中のインラインタグを使ってその設定を途中で切り替えることも可能です。
最後に シームレスなエクスポート(Seamless export) 機能により、Google AI Studioで構築した音声パラメーターをそのままGemini APIのコードとして書き出せます。これにより、同じキャラクターボイスを複数のプロジェクト間で一貫して再現する際の手間が大きく減ると考えられます。
SynthIDによるAI生成音声のウォーターマーキング
Gemini 3.1 Flash TTSが生成するすべての音声には、Googleが開発した「SynthID」ウォーターマークが自動的に埋め込まれます。SynthIDは人間の耳には聞こえないレベルで音声データに情報を付加する技術で、後から「この音声はAIが生成したものかどうか」を検出することができます。
音声合成技術がより身近になる一方、なりすましや偽情報への悪用リスクも高まっています。SynthIDはその対策として機能する仕組みで、AI生成コンテンツの責任ある普及につながる取り組みだと思います。
まとめ
Googleが発表したGemini 3.1 Flash TTSは、第三者評価で高評価を受けつつ低コストを実現した点と、音声タグによる直感的な発話制御が特徴的なモデルです。開発者にとっては、より精細な表現が求められる音声アプリケーションの設計において、選択肢のひとつとして注目に値するのではないかと思います。