はじめに
GitHub CopilotをベースにしたオープンソースプロジェクトSquadについて、GitHub Blogが2026年3月19日に公開した記事をもとに解説します。Squadはリポジトリ内に複数のAIエージェントを直接配置し、設計・実装・テスト・レビューを協調して進めるマルチエージェント開発ツールです。
参考記事
- タイトル: How Squad runs coordinated AI agents inside your repository
- 著者: Brady Gaster
- 発行元: GitHub Blog
- 発行日: 2026年3月19日(更新: 2026年3月20日)
- URL: https://github.blog/ai-and-ml/github-copilot/how-squad-runs-coordinated-ai-agents-inside-your-repository/
要点
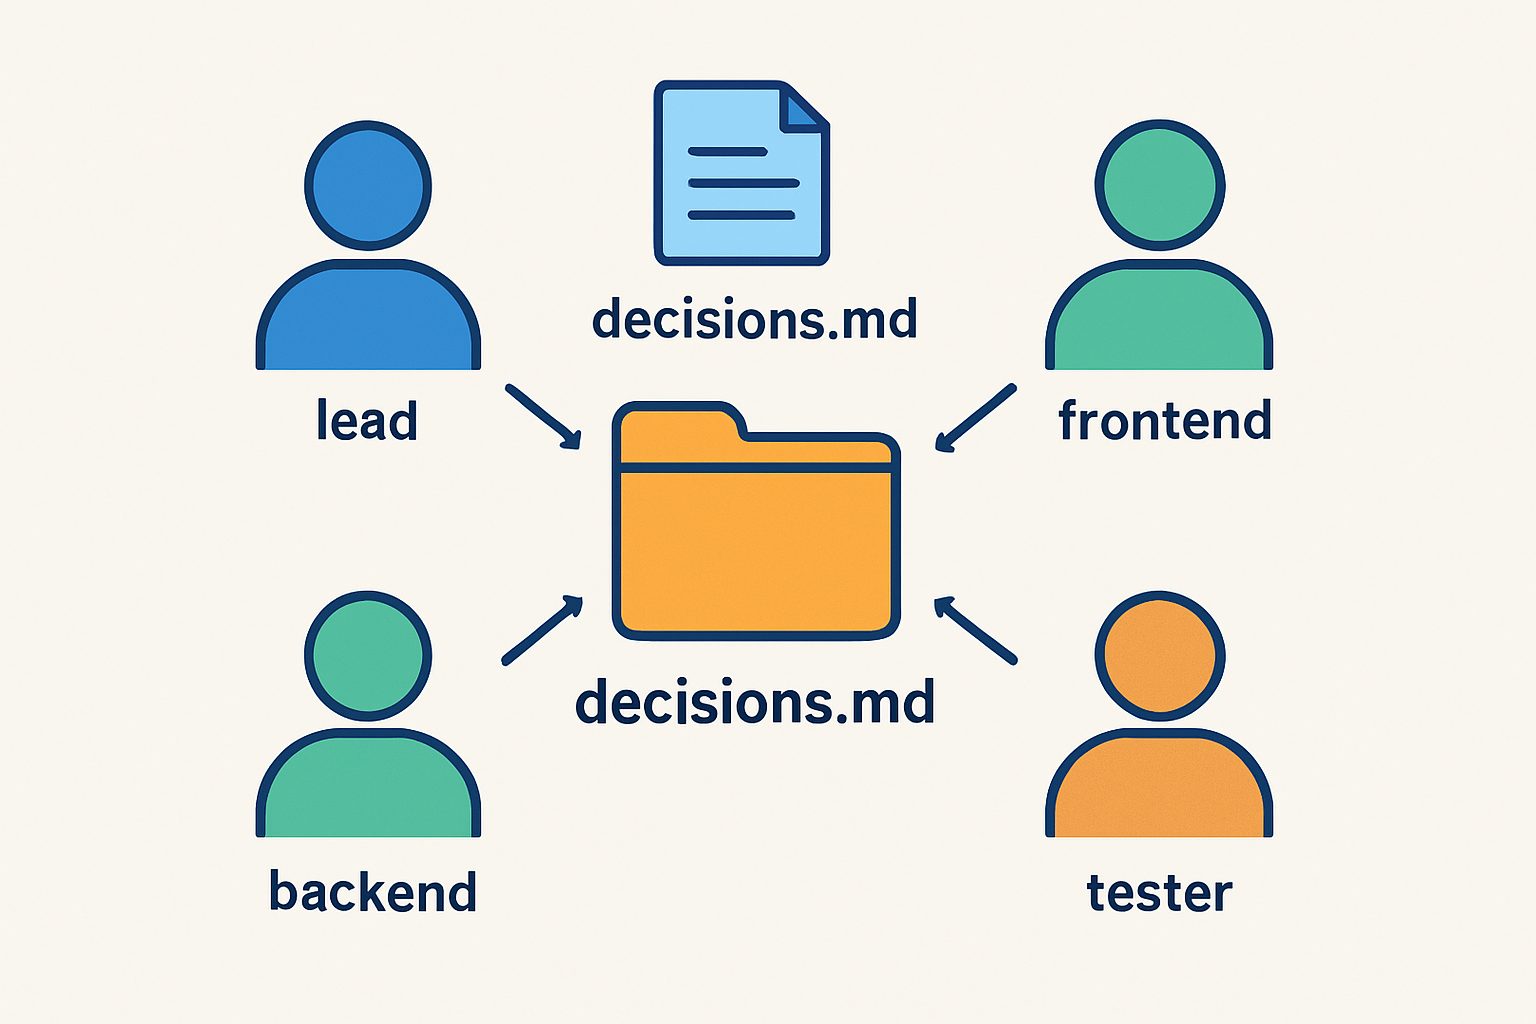
- Squadはnpm install -g @bradygaster/squad-cliとsquad initの2コマンドで、リポジトリ内にリード・フロントエンド・バックエンド・テスターの4役AIチームを配置できるオープンソースプロジェクトである
- エージェント間の共有メモリに「ドロップボックス」パターンを採用し、バージョン管理されたdecisions.mdファイルにすべてのアーキテクチャ決定事項を記録する
- コーディネーターエージェントは薄いルーターとして機能し、各スペシャリストが独立した推論呼び出しとして最大200Kトークンのコンテキストウィンドウで並列実行される
- テストが失敗した場合、元の実装エージェントは自分の成果物を修正できず、別のエージェントが対応するレビュープロトコルが実装されている
- エージェントのチャーター(役割定義)と履歴ファイルは.squad/フォルダ内にプレーンテキストとして保存され、コードと同じようにバージョン管理される
詳細解説
Squadとは——コマンド2つで始まるAIチーム
Squadは、GitHub Copilotをベースにしたオープンソースのマルチエージェント開発ツールです。Brady Gasterが公開したこのプロジェクトは、npm install -g @bradygaster/squad-cliをグローバルに一度実行し、各リポジトリでsquad initを実行するだけで、リポジトリ内にAIチームを配置できます。チームの構成はリード、フロントエンド開発者、バックエンド開発者、テスターの4役で、単一のチャットボットが役割を切り替えるのとは異なり、それぞれが独立したエージェントとして動作します。
マルチエージェントシステムの課題として従来から挙げられてきたのが、導入までの手間です。オーケストレーション層の構築やフレームワークの配線、ベクターデータベースの設定など、重いインフラ準備に何時間もかかることが少なくありませんでした。Squadはこのハードルを下げ、「マルチエージェント開発を、複雑なインフラやプロンプトエンジニアリングの専門知識なしに利用できる」ことを目指して設計されています。
エージェント間の協調の仕組み
Squadでの作業は自然言語の指示から始まります。例えば「JWTの認証——リフレッシュトークン、bcrypt付き——を実装して」と入力すると、コーディネーターエージェントがルーティングを担い、バックエンドスペシャリストが実装を、テスターがテストスイートの作成を並列で開始します。ドキュメント担当エージェントはプルリクエストを作成します。このとき、各スペシャリストはプロンプトに書かなくても、命名規則やデータベース接続の決定事項をすでに知っています。それはリポジトリにコミットされたチーム決定ファイルとプロジェクト履歴ファイルから自動的に読み込まれるためです。
注目すべきはレビューのプロセスです。テストが失敗した場合、元の実装エージェントは自分のコードを修正できません。別のエージェントが独立したコンテキストウィンドウで修正に当たるレビュープロトコルが設定されており、単一のAIが自分のミスをレビューするという問題を構造的に回避しています。ユーザーはこの内部ループを経て残ったプルリクエストを確認・マージするだけです。
なお、Squadは「自律実行」ではなく「協調的なオーケストレーション」です。GitHub Blogの記事では「エージェントは確認を求めることがあり、合理的に見えても誤った前提を置くこともある」と明示されており、すべてのプルリクエストをユーザーがレビューする設計になっています。
アーキテクチャパターン①:ドロップボックスパターン(共有メモリ)
多くのAIオーケストレーションは、リアルタイムチャットや複雑なベクターデータベースでエージェント間の同期を取ろうとします。しかしGitHub Blogの記事では、この方法は「壊れやすい」と評価されており、Squadは別のアプローチを採用しています。
Squadの「ドロップボックス」パターンでは、ライブラリ選定や命名規則などすべてのアーキテクチャ上の決定事項を、リポジトリ内のバージョン管理されたdecisions.mdファイルに構造化されたブロックとして追記します。このファイルがチームの「共有メモリ」として機能し、すべての決定事項の監査証跡にもなります。ライブセッションではなくプロジェクトファイルにメモリが存在するため、セッションの切断や再起動後も、このファイルからコンテキストを復元して作業を継続できます。非同期の知識共有がリアルタイム同期より堅牢というこの発想は、ドキュメント駆動の開発文化に近い考え方と言えます。
アーキテクチャパターン②:コンテキスト複製(分割ではなく複製)
AIエージェント開発でよく問題になるのが、コンテキストウィンドウの限界です。単一エージェントがすべてを担当しようとすると、管理情報でワーキングメモリが圧迫され、ハルシネーションが起きやすくなります。
Squadではコーディネーターエージェントを「薄いルーター」として設計し、実際の作業はスペシャリストに委譲します。各スペシャリストは独立した推論呼び出しとして実行され、対応モデルでは最大200Kトークンのコンテキストウィンドウを個別に持ちます。GitHub Blogの記事では、これを「1つのコンテキストを4つに分割する」のではなく「リポジトリのコンテキストを4つに複製する」方式として説明しています。並列実行により、複数の独立した推論コンテキストが同時に動作し、各エージェントが他のエージェントの思考と競合することなく、リポジトリの関連部分を確認できます。
アーキテクチャパターン③:明示的なメモリ管理
Squadでは、エージェントのアイデンティティを主に2つのリポジトリファイルで構成します。チャーター(自分が誰であるか)と履歴(これまでに何をしたか)、そして共有のチーム決定事項です。これらはプレーンテキストで.squad/フォルダに保存されます。
この設計の特徴は透明性にあります。「エージェントがプロジェクトについて何を知っているか」がファイルを見ればすぐに確認でき、コードと同じようにバージョン管理されます。リポジトリをクローンすると、コードだけでなく「オンボーディング済みのAIチーム」も一緒に取得できるという考え方は、チーム開発における継続性という観点から注目できるアプローチだと思います。
まとめ
Squadは、ドロップボックス・コンテキスト複製・明示的メモリという3つのパターンを組み合わせ、リポジトリ内に完結するマルチエージェント開発の新しいかたちを示しています。重いインフラなしに始められるこのアプローチが、実際の開発現場でどのように活用されていくか注目されます。