はじめに
Anthropicが2026年2月16日に公開した教育レポート「AI Fluency Index(AI流暢性指数)」では、Claude.aiでの約1万件の会話データをもとに、ユーザーがAIをどのように活用しているかを定量的に分析しています。本稿では、その調査手法と主な発見内容、そして実践的な示唆を解説します。
参考記事
- タイトル: Anthropic Education Report: The AI Fluency Index
- 著者: Kristen Swanson, Drew Bent, Zoe Ludwig, Rick Dakan, Joe Feller
- 発行元: Anthropic
- 発行日: 2026年2月16日
- URL: https://www.anthropic.com/research/AI-fluency-index
要点
- AnthropicはRick Dakan・Joseph Feller両教授と共同開発した「4D AI流暢性フレームワーク」をもとに、24の行動指標のうち会話内で観察可能な11項目を分析した
- 2026年1月の1週間に行われたClaude.aiでの9,830件の会話を対象に、プライバシー保護ツールを用いて各指標の有無を分類した
- 「繰り返しと改善(iteration and refinement)」を示す会話は85.7%を占め、それ以外の流暢性行動の出現率と強い正の相関があった
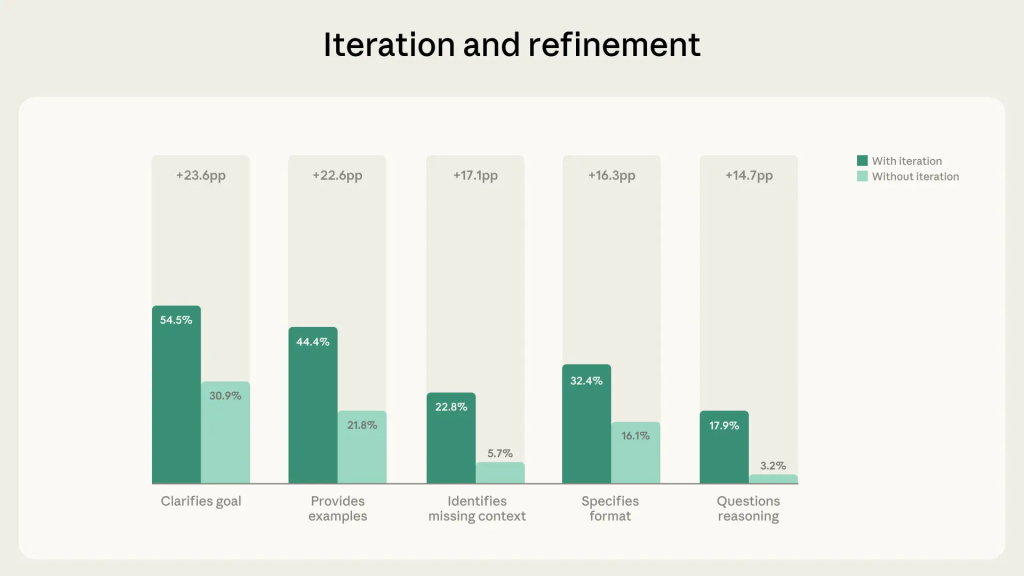
- 繰り返しと改善を行う会話は、そうでない会話と比べて平均2倍以上の流暢性行動を示し、モデルの推論を問い直す行動は5.6倍多かった
- コードや文書などの成果物(アーティファクト)を作成する会話では、指示の具体性は高まる一方、事実確認や推論への批判的評価が低下する傾向が確認された
詳細解説
AI流暢性とは何か:4Dフレームワークの概要
「AI流暢性(AI Fluency)」とは、AIを安全かつ効果的に活用するための行動の集合を指します。Anthropicは今回の研究にあたり、Rick Dakan教授とJoseph Feller教授が開発した「4D AI流暢性フレームワーク」を採用しました。このフレームワークは、安全で効果的な人間とAIの協働を体現する24の具体的な行動を定義しています。
24の行動指標のうち11項目は、Claude.aiやClaude Codeでのやり取りの中で直接観察が可能です。残り13項目(AIの関与を正直に開示する、生成物の共有の影響を考慮するなど)は会話の外側で起こるため、今回の研究では対象外となりました。Anthropicによれば、この観察できない13項目こそがAI流暢性において最も重要な側面の一部であり、今後は定性的な研究手法を用いて評価していく方針とのことです。
調査設計:約1万会話を分析
今回の調査では、2026年1月20日から26日の1週間に行われたClaude.ai上の9,830件の会話を対象としました。Anthropicはプライバシー保護ツールを使用し、各会話を高レベルな利用要約(「コードのトラブルシューティング」「経済概念の説明」など)に変換した上で、11の指標ごとに二値分類を行っています。個人を特定できる情報は分析に含まれていません。
なお、曜日ごとの比較や英語・フランス語・スペイン語・中国語・日本語・ドイツ語の6言語間での比較を行ったところ、ほとんどの指標で変動幅は3ポイント以内に収まり、結果の安定性が確認されています。この安定性は、観察された行動パターンが特定の時間帯や文化的文脈に依存するものではないことを示唆していると考えられます。
発見①:繰り返しと改善がAI流暢性の鍵
今回の調査で最も顕著だったのは、「繰り返しと改善(iteration and refinement)」、つまり最初の回答をそのまま受け入れず、やり取りを重ねて内容を洗練させる行動と、他の流暢性指標との強い相関です。
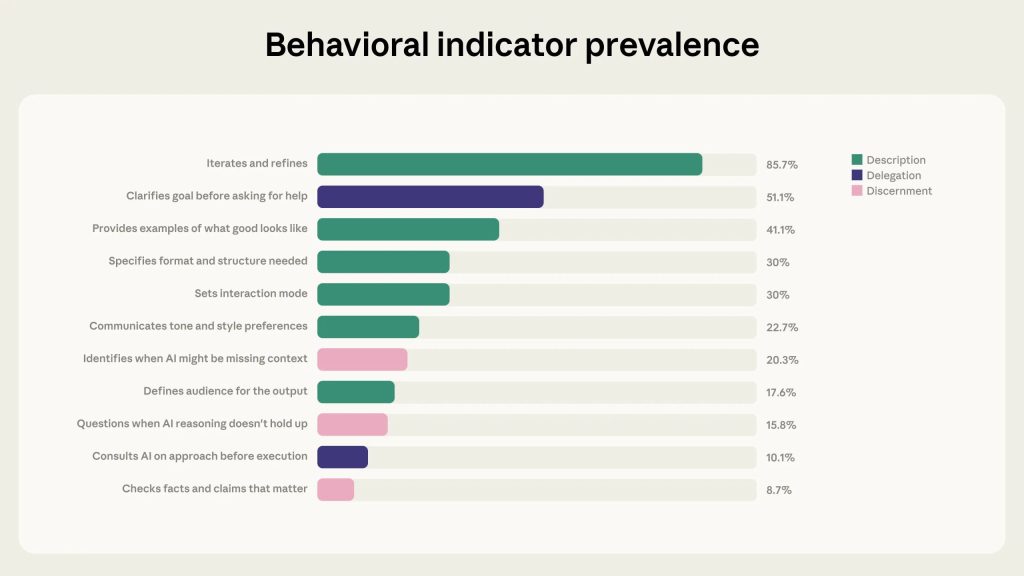
Anthropicによれば、サンプルの85.7%の会話でこの行動が確認されました。繰り返しと改善を行う会話(n=8,424)では平均2.67の流暢性行動が観察されたのに対し、そうでない会話(n=1,406)では平均1.33にとどまり、約2倍の差がありました。
特に評価的な行動への影響が大きく、繰り返しと改善を行う会話ではモデルの推論を問い直す行動が5.6倍、不足している文脈を指摘する行動が4倍多く見られました。AIとの対話を「一問一答」ではなく「思考のパートナーとの継続的なやり取り」として捉えることが、より深い関与につながると考えられます。
発見②:成果物を作るとき、評価的な行動が低下する
調査対象の12.3%(1,209件)の会話では、コード・文書・インタラクティブツールなどのアーティファクト(成果物)が作成されました。これらの会話では、AI流暢性の観点から興味深いパターンが確認されています。
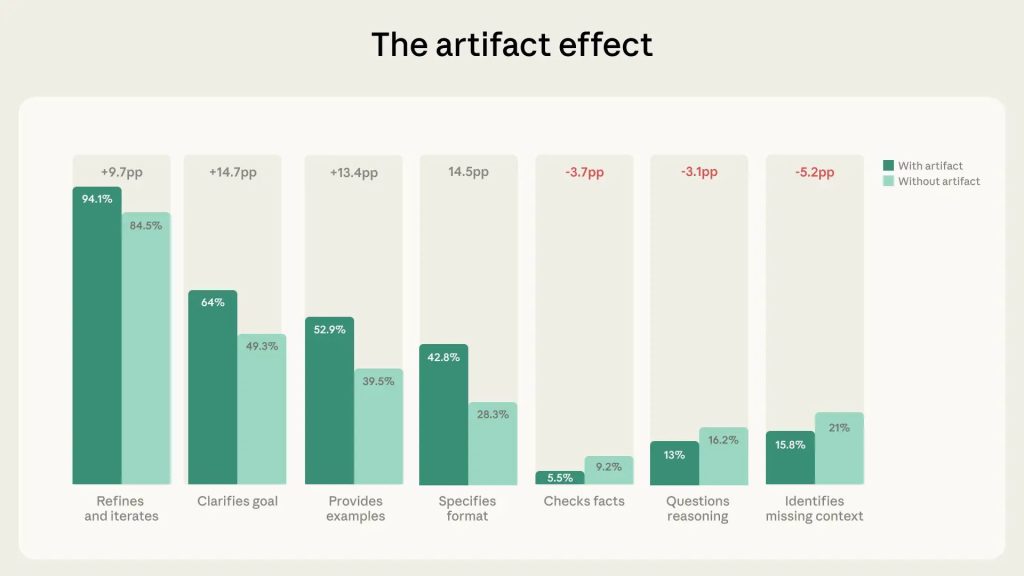
Anthropicによれば、成果物を作成する会話では、目標を明確にする行動(+14.7ポイント)、フォーマットを指定する行動(+14.5ポイント)、例を提示する行動(+13.4ポイント)、繰り返しと改善(+9.7ポイント)など、AIへの指示を具体化する行動が増加しました。一方で、不足している文脈の指摘(-5.2ポイント)、事実確認(-3.7ポイント)、推論の根拠を問い直す行動(-3.1ポイント)といった批判的な評価行動はいずれも低下しています。
この背景について、Anthropicはいくつかの可能性を示しています。完成度が高く見える成果物に対してはそれ以上の確認が不要に感じられるのかもしれない、あるいは、コードの実行やアプリのテストなど、会話の外側で評価が行われている可能性もあるとのことです。また、UIデザインのような用途では、法的文書の作成とは異なり、事実精度より機能性や見た目が優先されることもあると考えられます。
ただし、Anthropicの経済指数レポートによれば、最も複雑なタスクほどClaudeが苦手とする傾向があるとされており、成果物を作成する場面でこそ批判的な評価が重要だと思います。
AI流暢性を高めるための3つの実践
Anthropicは今回のデータをもとに、多くのユーザーが改善できる3つの領域を挙げています。
1つ目は、会話を続けることです。最初の回答をゴールとせず、追加質問や修正依頼を繰り返すことが、あらゆる流暢性行動の基盤となるとされています。
2つ目は、完成度の高い成果物にこそ批判的に向き合うことです。見栄えが良い出力ほど、内容が正確かどうか、何か抜けていないか、推論は適切かを確認する習慣が重要と考えられます。
3つ目は、協働の条件を明示することです。Anthropicによれば、「前提が間違っていたら指摘してください」「答えを出す前に推論を説明してください」「不確かな点を教えてください」といった指示を会話の最初に与えているユーザーは、全体のわずか30%にとどまっています。こうした事前の期待値の設定が、その後の対話の質を左右する可能性があります。
研究の限界と今後の展開
今回の調査にはいくつかの限界点も明示されています。サンプルは2026年1月の1週間のみで、Claude.aiの複数ターンの会話に限定されており、早期採用者に偏っている可能性があります。また、各行動指標は「あり/なし」の二値で分類されており、程度や質の細かいニュアンスは捉えられていません。
今後はコホート分析(新規ユーザーと経験者の比較)、会話外での行動を捉える定性的研究、そしてClaude Codeを対象とした分析の拡張が計画されています。
まとめ
Anthropicの「AI流暢性指数」レポートは、AIの「使いこなし」を行動レベルで測定しようとする初めての試みです。繰り返しと改善を重ねることの重要性と、完成度の高い成果物への過信リスクという2つの発見は、日々AIを活用する方にとって実践的な気づきになると思います。今後の縦断的な研究による継続的な観察が注目されます。