はじめに
Anthropicが2026年2月5日、最上位モデルの新バージョン「Claude Opus 4.6」を発表しました。コーディングスキルの大幅な向上に加え、Opusクラスとして初めて100万トークンのコンテキストウィンドウを実装し、複数の主要ベンチマークで業界最高スコアを記録しました。本稿では、この発表内容をもとに、Opus 4.6の性能、新機能、安全性への取り組みについて解説します。
参考記事
- タイトル: Introducing Claude Opus 4.6
- 発行元: Anthropic
- 発行日: 2026年2月5日
- URL: https://www.anthropic.com/news/claude-opus-4-6
要点
- Claude Opus 4.6は、前バージョンと比較してコーディングスキル、計画性、エージェント的タスクの持続性が向上し、Opusクラスとして初めて100万トークンのコンテキストウィンドウをベータ版で実装した
- Terminal-Bench 2.0、Humanity’s Last Exam、GDPval-AAなど複数の主要ベンチマークで最高スコアを記録し、GDPval-AAではGPT-5.2を約144 Eloポイント上回る性能を示した
- 安全性評価においても業界最高水準のプロファイルを維持し、誤整合行動の発生率が低く、過剰な拒否率も最低レベルを記録した
- Adaptive thinking、Effort controls、Context compactionなどの新機能がAPI経由で提供され、開発者はモデルの思考深度とコスト効率をより細かく制御できるようになった
- Claude Codeでは複数エージェントが並行作業する「agent teams」機能が追加され、Claude in PowerPointがリサーチプレビューとして公開された
詳細解説
Opus 4.6の基本性能向上
Anthropicによれば、Opus 4.6は前バージョンのOpus 4.5と比較して、コーディングにおける計画性が向上し、エージェント的なタスクをより長時間持続できるようになりました。大規模なコードベースでの動作信頼性が高まり、コードレビューとデバッグのスキルも強化され、自身のミスを検出する能力が向上しています。
また、Opusクラスのモデルとして初めて、100万トークンのコンテキストウィンドウをベータ版で実装しました。これは、約75万語に相当する膨大なテキスト量を一度に処理できることを意味します。従来のOpusクラスでは20万トークン程度が標準的でしたが、この拡張により、大規模なドキュメントセット全体を参照しながらの作業や、長時間にわたる会話の維持が可能になると考えられます。
コーディング以外の業務タスク、例えば財務分析、リサーチ、ドキュメント・スプレッドシート・プレゼンテーションの作成や利用においても、これらの向上した能力を発揮できます。
主要ベンチマークでの業界最高スコア
Anthropicの発表では、Opus 4.6は複数の評価で業界最高水準の性能を記録しました。
エージェント的コーディング評価であるTerminal-Bench 2.0では最高スコアを達成しました。このベンチマークは、複数のステップにわたるコーディングタスクを自律的に実行する能力を測定する指標です。
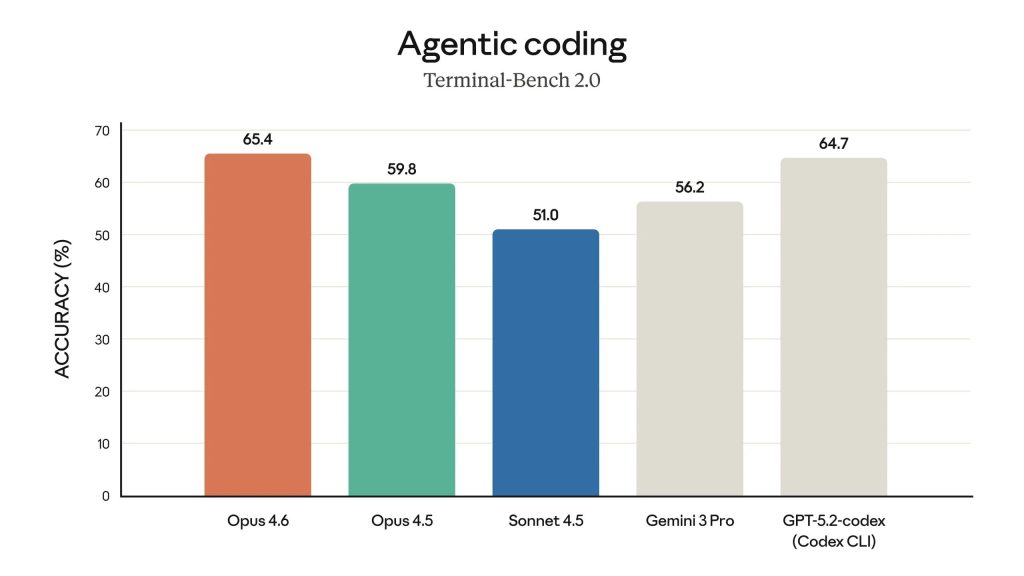
※なお、Opus4.6の発表と同日、OpenAIがGPT-5.3-Codexを発表しました。GPT-5.3-Codexは77.3%と記録したと報告しています。
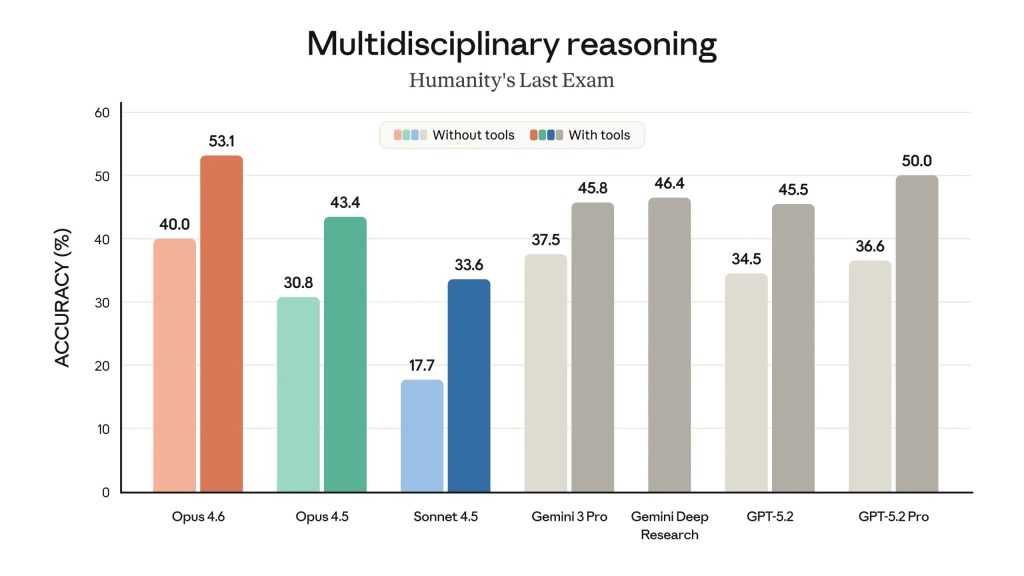
複雑な多分野推論テストであるHumanity’s Last Examでは、他のすべてのフロンティアモデルを上回る結果を示しました。この評価は、科学、人文科学、技術など幅広い分野の知識を統合して推論する能力を測定します。
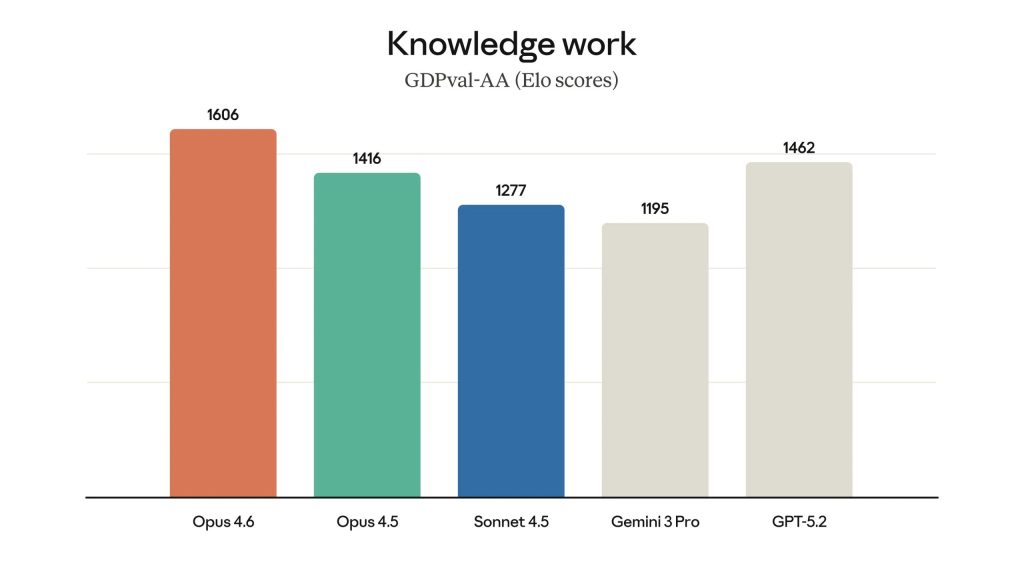
実務的ナレッジワーク評価であるGDPval-AAでは、Anthropicによれば業界次点のモデル(OpenAIのGPT-5.2)を約144 Eloポイント、前バージョンのOpus 4.5を190ポイント上回りました。第三者機関Artificial Analysisによる独立評価として実施されたこのベンチマークは、金融、法務などの分野における経済的価値の高い実務タスクの遂行能力を測定します。144 Eloポイントの差は、約70%の確率でOpus 4.6がGPT-5.2より高いスコアを獲得することを意味します。
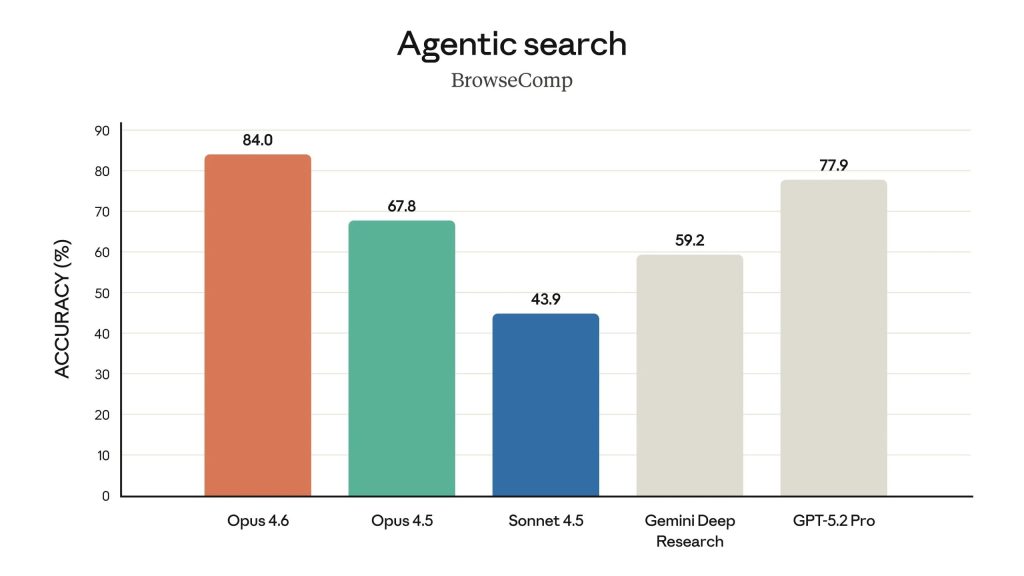
また、情報検索能力を測定するBrowseCompでも最高性能を記録しました。このベンチマークは、オンライン上で見つけにくい情報を探し出す能力を評価するもので、実用的なリサーチタスクに近い条件で測定されます。
長文コンテキスト処理の飛躍的向上
Anthropicによれば、Opus 4.6は長文コンテキストからの情報抽出能力が大幅に向上しています。特に「context rot」と呼ばれる、会話が一定のトークン数を超えると性能が劣化する現象への耐性が強化されました。
具体的には、100万トークンの8-needle変種版MRCR v2ベンチマークにおいて、Opus 4.6は76%のスコアを記録したのに対し、Sonnet 4.5は18.5%にとどまりました。MRCR v2は、膨大なテキスト量の中に「隠された」情報を取り出す能力を測定する評価で、針を干し草の山から探すような困難さを模擬しています。この大幅な性能向上は、長文コンテキストを実際に活用できる水準が質的に変化したことを示していると考えられます。
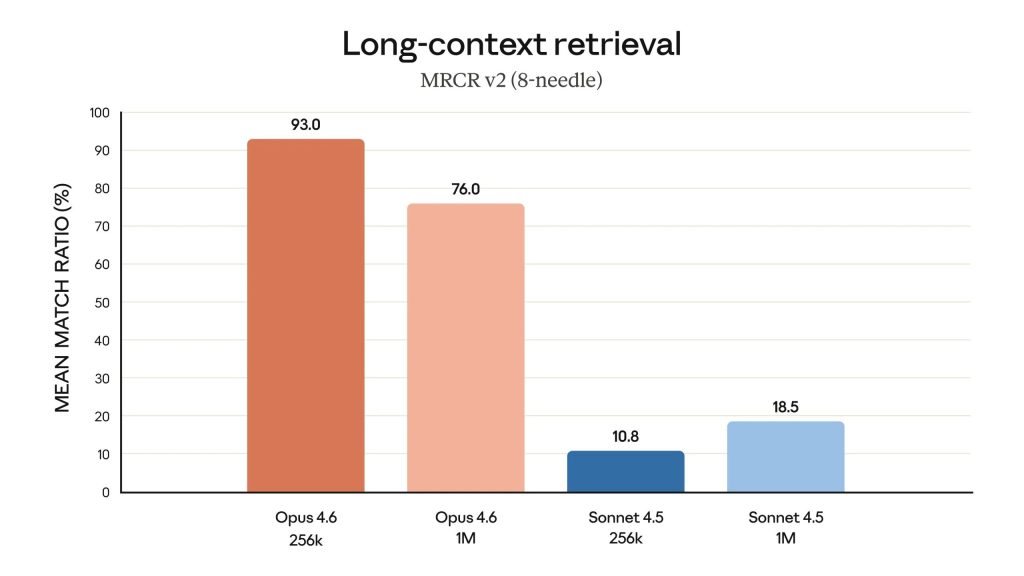
数十万トークンにわたる情報を保持・追跡する際のドリフト(情報の欠落や混同)が減少し、Opus 4.5でも見逃していた埋もれた詳細情報を拾い上げられるようになっています。
包括的な安全性評価と対策
Anthropicの自動行動監査によれば、Opus 4.6は欺瞞、迎合、ユーザーの妄想の助長、悪用への協力といった誤整合行動の発生率が低いレベルに抑えられています。全体的な整合性は、同社のこれまでで最も整合性の高かったOpus 4.5と同等です。また、無害なクエリに対して回答を拒否してしまう「過剰拒否」の発生率は、最近のClaudeモデルの中で最も低い水準となりました。
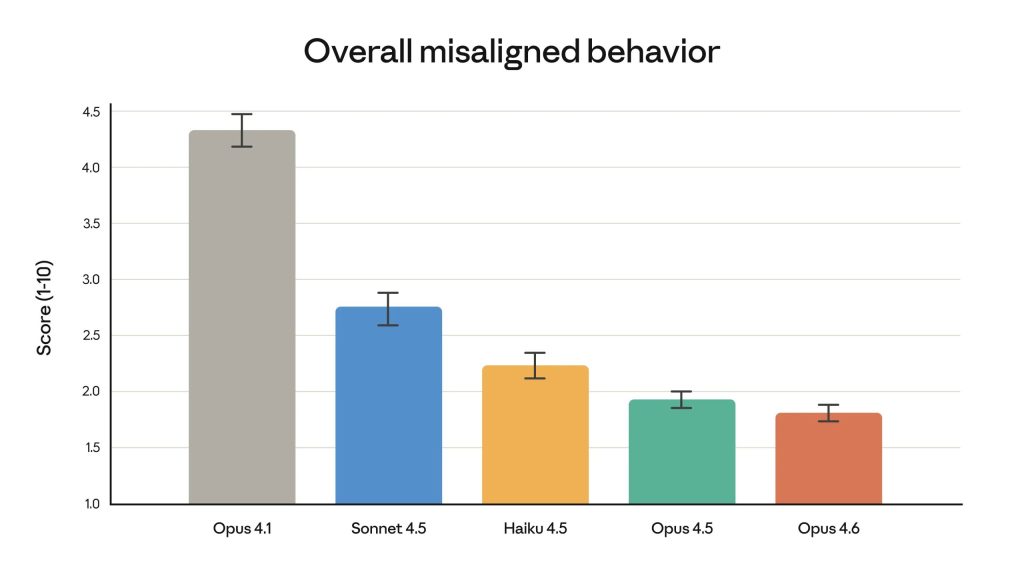
Opus 4.6に対しては、同社史上最も包括的な安全性評価セットが実施されました。ユーザーのウェルビーイングに関する新しい評価、潜在的に危険なリクエストを拒否する能力のより複雑なテスト、有害な行動を密かに実行する能力の更新された評価が含まれています。
さらに、AIモデルの内部動作を解明する「interpretability(解釈可能性)」研究の新しい手法も実験的に適用され、モデルが特定の方法で振る舞う理由の理解を深め、標準的なテストでは見逃される可能性のある問題を捕捉する試みが行われています。
特にサイバーセキュリティ能力が強化されたことから、悪用の可能性に対応するため、6つの新しいサイバーセキュリティ「probe(プローブ)」が開発されました。これは有害な応答を検出する手法で、さまざまな形態の潜在的悪用を追跡するためのものです。一方で、同社はモデルをオープンソースソフトウェアの脆弱性発見とパッチ適用に活用するなど、サイバー防御への利用も加速させています。サイバーセキュリティの状況は急速に変化するため、今後も学習内容に応じて対策を調整・更新し、近い将来にはリアルタイム介入による悪用のブロックを実施する可能性があります。
開発者向け新機能:思考制御とコンテキスト管理
API経由で提供される新機能により、開発者はモデルの動作をより細かく制御できるようになりました。
Adaptive thinking(適応的思考)では、従来は拡張思考のオン/オフの二択だったものが、モデル自身が深い推論が有用かどうかを判断できるようになりました。デフォルトの「high」effort設定では、有用な場合に拡張思考を使用しますが、開発者はeffort levelを調整してより選択的に、あるいはより積極的に使用させることができます。
Effort controls(努力制御)では、low、medium、high(デフォルト)、maxの4段階から選択可能になりました。Anthropicによれば、Opus 4.6はしばしばより深く考え、答えを出す前に推論を注意深く見直します。これは難しい問題でより良い結果をもたらしますが、単純なタスクではコストとレイテンシーが増加する可能性があります。そのため、モデルが過剰に考えすぎていると感じる場合は、effortをhighからmediumに下げることが推奨されています。
Context compaction(コンテキスト圧縮、ベータ版)は、長時間の会話やエージェント的タスクがコンテキストウィンドウの上限に達する問題に対処します。会話が設定可能な閾値に近づくと、古いコンテキストを自動的に要約・置換し、上限に達することなくより長いタスクを実行できるようにします。
その他、100万トークンコンテキスト(ベータ版、20万トークン超過時はプレミアム価格)、最大128,000トークンの出力サポート、米国内でのみ処理を行うUS-only inference(1.1倍の料金)も提供されます。
なお、価格はこれまでと同じく100万トークンあたり入力$5/出力$25に据え置かれています。
製品アップデート:チーム開発とOffice統合
Claude Codeでは、agent teams(エージェントチーム)機能がリサーチプレビューとして導入されました。これにより、複数のエージェントを並行して立ち上げ、チームとして自律的に協調作業させることができます。コードベースのレビューのような、独立した読み取り中心の作業に分割できるタスクに最適と考えられます。開発者はShift+Up/Downキーやtmuxを使用して、任意のサブエージェントを直接引き継ぐこともできます。
Claude in Excelでは、長時間実行タスクや難易度の高いタスクへの対応が改善され、行動前の計画立案、非構造化データの取り込みと適切な構造の自動推論、複数ステップの変更を一度に処理する能力が強化されました。
Claude in PowerPointがリサーチプレビューとして公開されました。Excelでデータを処理・構造化した後、PowerPointで視覚的に表現するという連携が可能になります。Claudeはレイアウト、フォント、スライドマスターを読み取り、テンプレートからの構築でも、説明文からの全デッキ生成でも、ブランドイメージを保ちながら作業できます。Max、Team、Enterpriseプランで利用可能です。
まとめ
Claude Opus 4.6は、コーディング性能、長文コンテキスト処理、実務タスクの実行能力において業界最高水準を達成しながら、包括的な安全性評価もクリアしたモデルです。Adaptive thinkingやContext compactionなどの新機能により、開発者はより柔軟な制御が可能になり、エージェントチームやOfficeツール統合により実用性も大きく向上しました。今後、これらの機能がどのように実務環境で活用されていくか、注目されます。