はじめに
OpenAIが2026年1月29日、同社の社内データ分析業務を支援するAIエージェントの技術詳細を公開しました。このエージェントは3,500名以上の社員が利用し、70,000以上のデータセット(総容量600ペタバイト超)を横断的に扱うシステムです。本稿では、OpenAIが公開した技術情報をもとに、大規模データ基盤におけるAIエージェントの実装方法と、実運用から得られた知見について解説します。
参考記事
- タイトル: Inside OpenAI’s in-house data agent
- 著者: Bonnie Xu, Aravind Suresh, Emma Tang
- 発行元: OpenAI
- 発行日: 2026年1月29日
- URL: https://openai.com/index/inside-our-in-house-data-agent/
要点
- OpenAIは社内専用のデータエージェントを構築し、エンジニアリング、データサイエンス、営業、財務、研究部門の3,500名以上が利用している
- エージェントはGPT-5.2を基盤とし、Slack、Web UI、IDE、Codex CLI、ChatGPTアプリの5つのインターフェースから利用可能である
- データの正確な理解を実現するため、テーブル使用状況、人間によるアノテーション、Codexエンリッチメント、組織知識、メモリ、ランタイムコンテキストの6層からなるコンテキストシステムを構築した
- OpenAI Evals APIを活用した継続的な評価パイプラインにより、応答品質の維持と改善を行っている
- 実装を通じて、ツールの統合による曖昧性の削減、高レベルなガイダンスの有効性、コードレベルでのデータ理解の重要性という3つの教訓を得た
詳細解説
開発の背景:大規模データ基盤が抱える課題
OpenAIによれば、同社のデータプラットフォームは600ペタバイト以上のデータを70,000以上のデータセットに分散して管理しています。このような規模では、分析に適したテーブルを見つけるだけでも多大な時間を要します。
実際の利用者の声として、「似たようなテーブルが多数存在し、それらの違いを理解するのに多くの時間を費やしている。ログアウトユーザーを含むものと含まないもの、フィールドが重複しているものなど、何が何だか判別しづらい」という課題が紹介されています。
適切なテーブルを選択できたとしても、正確な結果を得るためには、テーブル間の関係性を理解し、適切な変換やフィルタを適用する必要があります。多対多結合、フィルタのプッシュダウンエラー、NULL値の未処理など、一般的なエラーパターンが結果を誤らせる可能性があるためです。
このような状況では、アナリストがSQLのデバッグやクエリ性能の最適化に時間を費やすのではなく、指標の定義、仮説の検証、データドリブンな意思決定に集中できる環境が求められると考えられます。
エージェントの基本構成と利用形態
OpenAIのデータエージェントはGPT-5.2を基盤として構築されており、従業員が日常的に使用する5つのインターフェースから利用できます。具体的には、Slackエージェント、Webインターフェース、IDE内、Codex CLI経由のMCP(Model Context Protocol)、そしてOpenAI社内のChatGPTアプリ内のMCPコネクタです。

エージェントの特徴的な能力として、複雑で曖昧な質問にも対応できる点が挙げられます。OpenAIが示した例では、「ニューヨークのタクシー利用で、乗車地点と降車地点のZIPコードの組み合わせのうち、通常時と最悪時の所要時間の差が最も大きい(最も信頼性が低い)組み合わせはどれか、またその変動はいつ発生するか」という質問に対し、エージェントは自律的にデータ探索、クエリ実行、結果の統合までを実行します。
データ分析の実務では、このような多段階の探索が必要になることが一般的です。エージェントは固定されたスクリプトに従うのではなく、自身の進捗状況を評価しながら問題解決を進めます。中間結果が誤っている場合(例:不適切な結合やフィルタによる0行の結果)、エージェントは問題を調査し、アプローチを調整して再試行します。このフィードバックループにより、ユーザー側の反復作業が削減され、手作業よりも高品質な分析が実現されると考えられます。
6層のコンテキストシステム
データエージェントの応答品質は、提供されるコンテキストの質に大きく依存します。OpenAIによれば、適切なコンテキストがない場合、強力なモデルであってもユーザー数の大幅な誤推定や社内用語の誤解釈といった誤りが発生します。
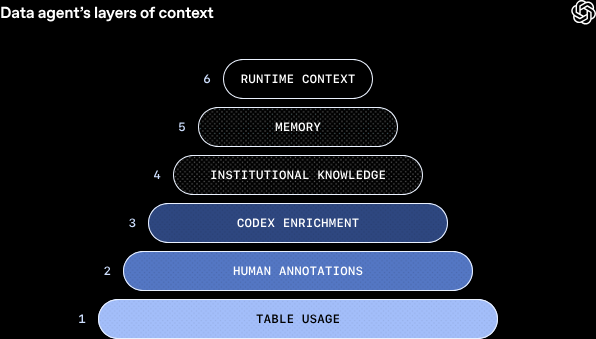
こうした失敗を防ぐため、エージェントは6層のコンテキストシステムを備えています。
レイヤー1:テーブル使用状況
スキーマメタデータ(カラム名とデータ型)を基礎として、テーブルリネージ(上流・下流のテーブル関係)を把握します。また、過去のクエリ履歴を取り込むことで、どのテーブルが一般的に結合されるかを学習します。
レイヤー2:人間によるアノテーション
ドメインエキスパートが提供する、テーブルやカラムの説明です。意図、セマンティクス、ビジネス上の意味、既知の注意点など、スキーマや過去のクエリからは推測できない情報が含まれます。
レイヤー3:Codexエンリッチメント
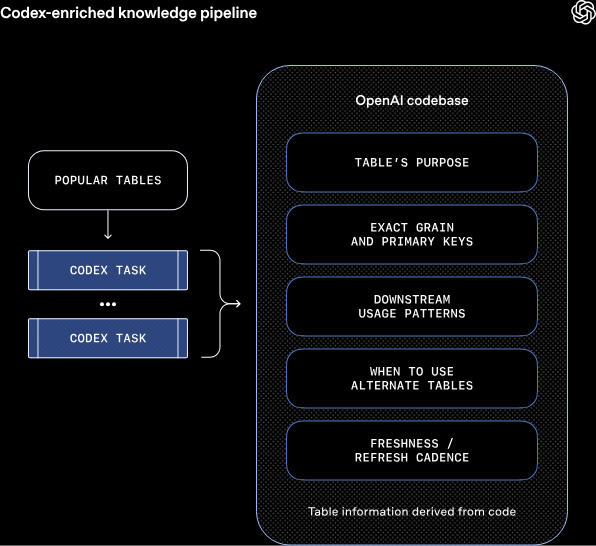
メタデータだけでは不十分であるため、テーブルがどのように作成されたかをコードレベルで理解する層です。Codexを使用してテーブルの生成コードを解析することで、以下の情報が得られます:
- テーブルに何が格納されているか、分析イベントからどのように導出されているか
- 値の一意性、データ更新頻度、データスコープ(特定フィールドの除外の有無、粒度レベル)などの詳細
- SQL以外のSpark、Pythonなどのデータシステムでの使用方法
この層により、エージェントは見た目が似ているが重要な点で異なるテーブルを区別できます。例えば、特定のテーブルがファーストパーティのChatGPTトラフィックのみを含むかどうかを判別できます。また、このコンテキストは自動的に更新されるため、手動メンテナンスなしで最新の状態が保たれます。
レイヤー4:組織知識
Slack、Google Docs、Notionなどから、製品リリース、信頼性インシデント、社内コードネームやツール、重要指標の正式な定義と計算ロジックといった組織の重要な文脈情報にアクセスします。これらのドキュメントは取り込まれ、埋め込みベクトル化され、メタデータと権限情報とともに保存されます。ランタイム時には、検索サービスがアクセス制御とキャッシングを処理し、エージェントが効率的かつ安全に情報を取得できます。
レイヤー5:メモリ
エージェントが修正を受けたり、特定のデータ質問に関する微妙な違いを発見したりした場合、その学習内容を次回のために保存します。これにより、将来の回答はより正確なベースラインから開始でき、同じ問題を繰り返し遭遇することが避けられます。
メモリの目的は、データの正確性に重要だが他の層だけでは推測が難しい、自明でない修正、フィルタ、制約を保持して再利用することです。OpenAIが示した例では、特定の分析実験用のフィルタ方法(実験ゲートで定義された特定文字列とのマッチング)をエージェントが知らなかったケースで、メモリが正確なフィルタリングを実現する上で重要な役割を果たしました。
メモリは、ユーザーがエージェントに修正を与えた時や、会話から学習を見つけた時に保存を促すプロンプトが表示されます。また、ユーザーが手動で作成・編集することも可能で、グローバルレベルと個人レベルでスコープ設定されます。
レイヤー6:ランタイムコンテキスト
テーブルに関する事前コンテキストが存在しない場合や、既存情報が古い場合、エージェントはデータウェアハウスに対してライブクエリを発行し、テーブルを直接検査・クエリできます。これにより、スキーマの検証、リアルタイムでのデータ理解、適切な応答が可能になります。また、メタデータサービス、Airflow、Sparkなど他のデータプラットフォームシステムとも対話し、ウェアハウス外に存在する広範なデータコンテキストを取得できます。
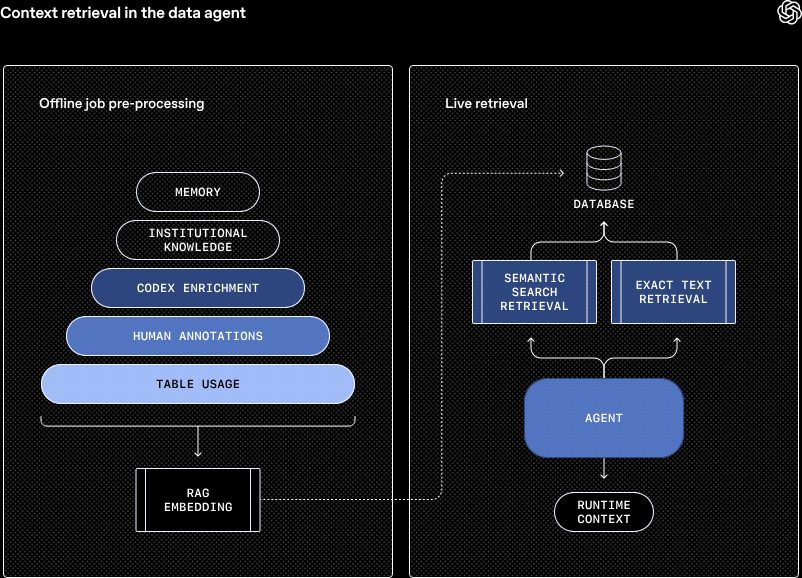
これらの層を統合するため、OpenAIは日次のオフラインパイプラインを実行しています。テーブル使用状況、人間によるアノテーション、Codex由来のエンリッチメントを単一の正規化された表現に集約し、OpenAI Embeddings APIを使用して埋め込みベクトルに変換して保存します。クエリ時には、RAG(検索拡張生成)を介して最も関連性の高い埋め込みコンテキストのみを取得します。これにより、数万のテーブルを扱う場合でも、テーブル理解が高速でスケーラブルになり、ランタイムレイテンシが予測可能かつ低く保たれます。
チームメイトのように思考し、協働する設計
一度きりの回答は、問題が明確な場合には有効ですが、多くの質問はそうではありません。OpenAIによれば、正しい結果に到達するには、往復的な改善と軌道修正が必要になることが多いとされています。
エージェントは、ユーザーが協働できるチームメイトのように振る舞うよう設計されています。会話型で常時利用可能であり、迅速な回答と反復的な探索の両方に対応します。
ターン間で完全なコンテキストを引き継ぐため、ユーザーはフォローアップ質問をしたり、意図を調整したり、方向を変えたりする際に、すべてを再度述べる必要がありません。エージェントが誤った方向に進み始めた場合、ユーザーは分析の途中で割り込んで方向転換させることができます。これは、話を聞く人間の協力者と同様の体験と言えます。
指示が不明確または不完全な場合、エージェントは積極的に明確化のための質問をします。応答がない場合は、進捗のために妥当なデフォルト値を適用します。例えば、ユーザーが日付範囲を指定せずにビジネス成長について尋ねた場合、過去7日間または30日間を想定することがあります。これらの事前設定により、ブロッキングせずに応答性を保ちつつ、適切な結果に収束できます。
導入後、OpenAIはユーザーが定期的な反復作業のために同じ分析を頻繁に実行することを観察しました。これを効率化するため、エージェントのワークフロー機能は、繰り返し発生する分析を再利用可能な指示セットにパッケージ化します。例として、週次のビジネスレポートやテーブル検証のワークフローがあります。コンテキストとベストプラクティスを一度エンコードすることで、ワークフローは反復分析を効率化し、ユーザー間で一貫した結果を保証します。
信頼を損なわない高速な進化
常時稼働し、進化し続けるエージェントを構築する場合、品質は改善するのと同じくらい容易に劣化する可能性があります。OpenAIによれば、厳密なフィードバックループがなければ、性能低下は避けられず、かつ見えにくいとされています。
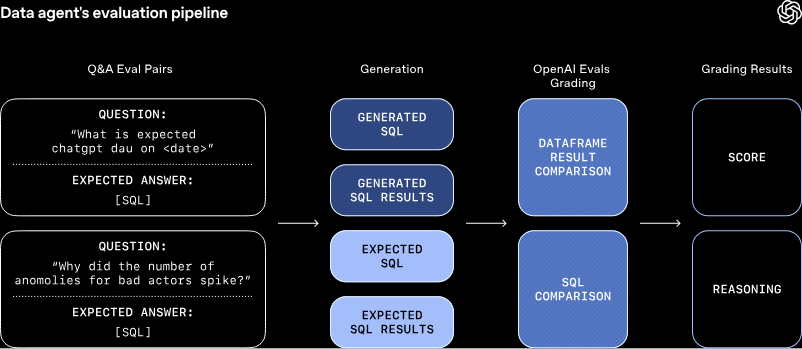
同社は、OpenAI Evals APIを活用して、エージェントの応答品質を測定し保護しています。評価は、厳選された質問・回答ペアのセットに基づいて構築されます。各質問は、正確に取得したい重要な指標または分析パターンをターゲットとし、期待される結果を生成する手動で作成された「ゴールデン」SQLクエリとペアになっています。
各評価では、自然言語の質問をクエリ生成エンドポイントに送信し、生成されたSQLを実行し、その出力を期待されるSQLの結果と比較します。
評価は単純な文字列マッチングに依存しません。生成されたSQLは構文的に異なっていても正しい場合があり、結果セットには答えに実質的に影響しない追加カラムが含まれる場合があります。これを考慮するため、SQLと結果データの両方を比較し、これらの信号をOpenAIのEvalsグレーダーに供給します。グレーダーは、正確性と許容される変動の両方を捉えた最終スコアと説明を生成します。
これらの評価は、開発中に継続的に実行される単体テストのように機能し、本番環境でのカナリアとして性能低下を早期に検出します。これにより、エージェントの能力が拡大しても、問題を早期に捉え、自信を持って反復できます。
継続的な評価の仕組みは、AIシステムの品質保証において重要なアプローチと考えられます。特に、本番環境で使用されるエージェントにおいては、このような体系的な評価パイプラインが信頼性の維持に不可欠と言えます。
セキュリティとアクセス制御
OpenAIのデータエージェントは、同社の既存のセキュリティおよびアクセス制御モデルに直接統合されています。エージェントは純粋にインターフェース層として動作し、OpenAIのデータを管理する権限とガードレールを継承し、実施します。
エージェントのすべてのアクセスは厳格なパススルー方式であり、ユーザーは既にアクセス権限を持つテーブルのみをクエリできます。アクセス権がない場合、エージェントはそれを通知するか、ユーザーが利用を許可されている代替データセットにフォールバックします。
また、透明性を重視した設計になっています。どのシステムも誤りを犯す可能性があるため、エージェントは各回答とともに前提条件と実行ステップを要約することで、推論プロセスを公開します。クエリが実行されると、基礎となる結果に直接リンクし、ユーザーが生データを検査し、分析のすべてのステップを検証できるようになっています。
実装から得られた3つの教訓
OpenAIは、エージェントをゼロから構築する過程で、エージェントの振る舞い、課題、そして大規模な信頼性を実現する要素について実践的な教訓を得ました。
教訓1:シンプルさが重要
初期段階では、エージェントに全ツールセットを公開していましたが、機能の重複により問題が発生しました。この冗長性は、特定のカスタムケースには有用で、人間が手動で呼び出す場合には明確ですが、エージェントにとっては混乱を招きます。OpenAIは、曖昧性を減らし信頼性を向上させるため、特定のツール呼び出しを制限・統合しました。
AIエージェントにおいては、選択肢が多すぎることが逆効果になる場合があると考えられます。人間にとって柔軟性が高いインターフェースが、エージェントにとっては意思決定の複雑さを増大させる可能性があります。
教訓2:目標を導き、経路は任せる
高度に規定的なプロンプトが結果を悪化させることも発見されました。多くの質問は一般的な分析の形状を共有していますが、詳細は十分に異なるため、厳格な指示がしばしばエージェントを誤った方向に導きました。より高レベルのガイダンスに移行し、GPT-5の推論能力に適切な実行経路の選択を任せることで、エージェントはより堅牢になり、より良い結果を生成するようになりました。
これは、AIエージェントの設計において重要な知見と思われます。詳細な手順を指定するのではなく、達成すべき目標を明確にし、そこに至る方法はエージェント自身の推論に委ねるアプローチが効果的である可能性を示しています。
教訓3:意味はコードの中に存在する
スキーマとクエリ履歴は、テーブルの形状と使用方法を記述しますが、その真の意味はテーブルを生成するコードの中にあります。パイプラインロジックには、SQLやメタデータには決して現れない前提条件、鮮度保証、ビジネス意図が含まれています。
Codexでコードベースをクロールすることで、エージェントはデータセットが実際にどのように構築されているかを理解し、各テーブルが実際に何を含んでいるかをより適切に推論できます。「ここに何があるか」「いつ使えるか」という質問に、ウェアハウスからの信号のみよりもはるかに正確に答えられます。
データの意味を理解する上で、メタデータだけでなく、そのデータを生成するプログラムコード自体を分析対象とすることの重要性を示す教訓と言えます。
まとめ
OpenAIが公開したデータエージェントの技術詳細は、大規模データ基盤における実用的なAIエージェント実装の一例を示しています。6層のコンテキストシステム、継続的な評価パイプライン、そして実運用から得られた教訓は、今後のエージェント開発において参考になる知見と考えられます。同社は、曖昧な質問への対応能力向上、検証強化による信頼性と精度の改善、ワークフローへのより深い統合を進めており、データ分析業務におけるAIエージェントの役割がさらに拡大していく可能性があります。