はじめに
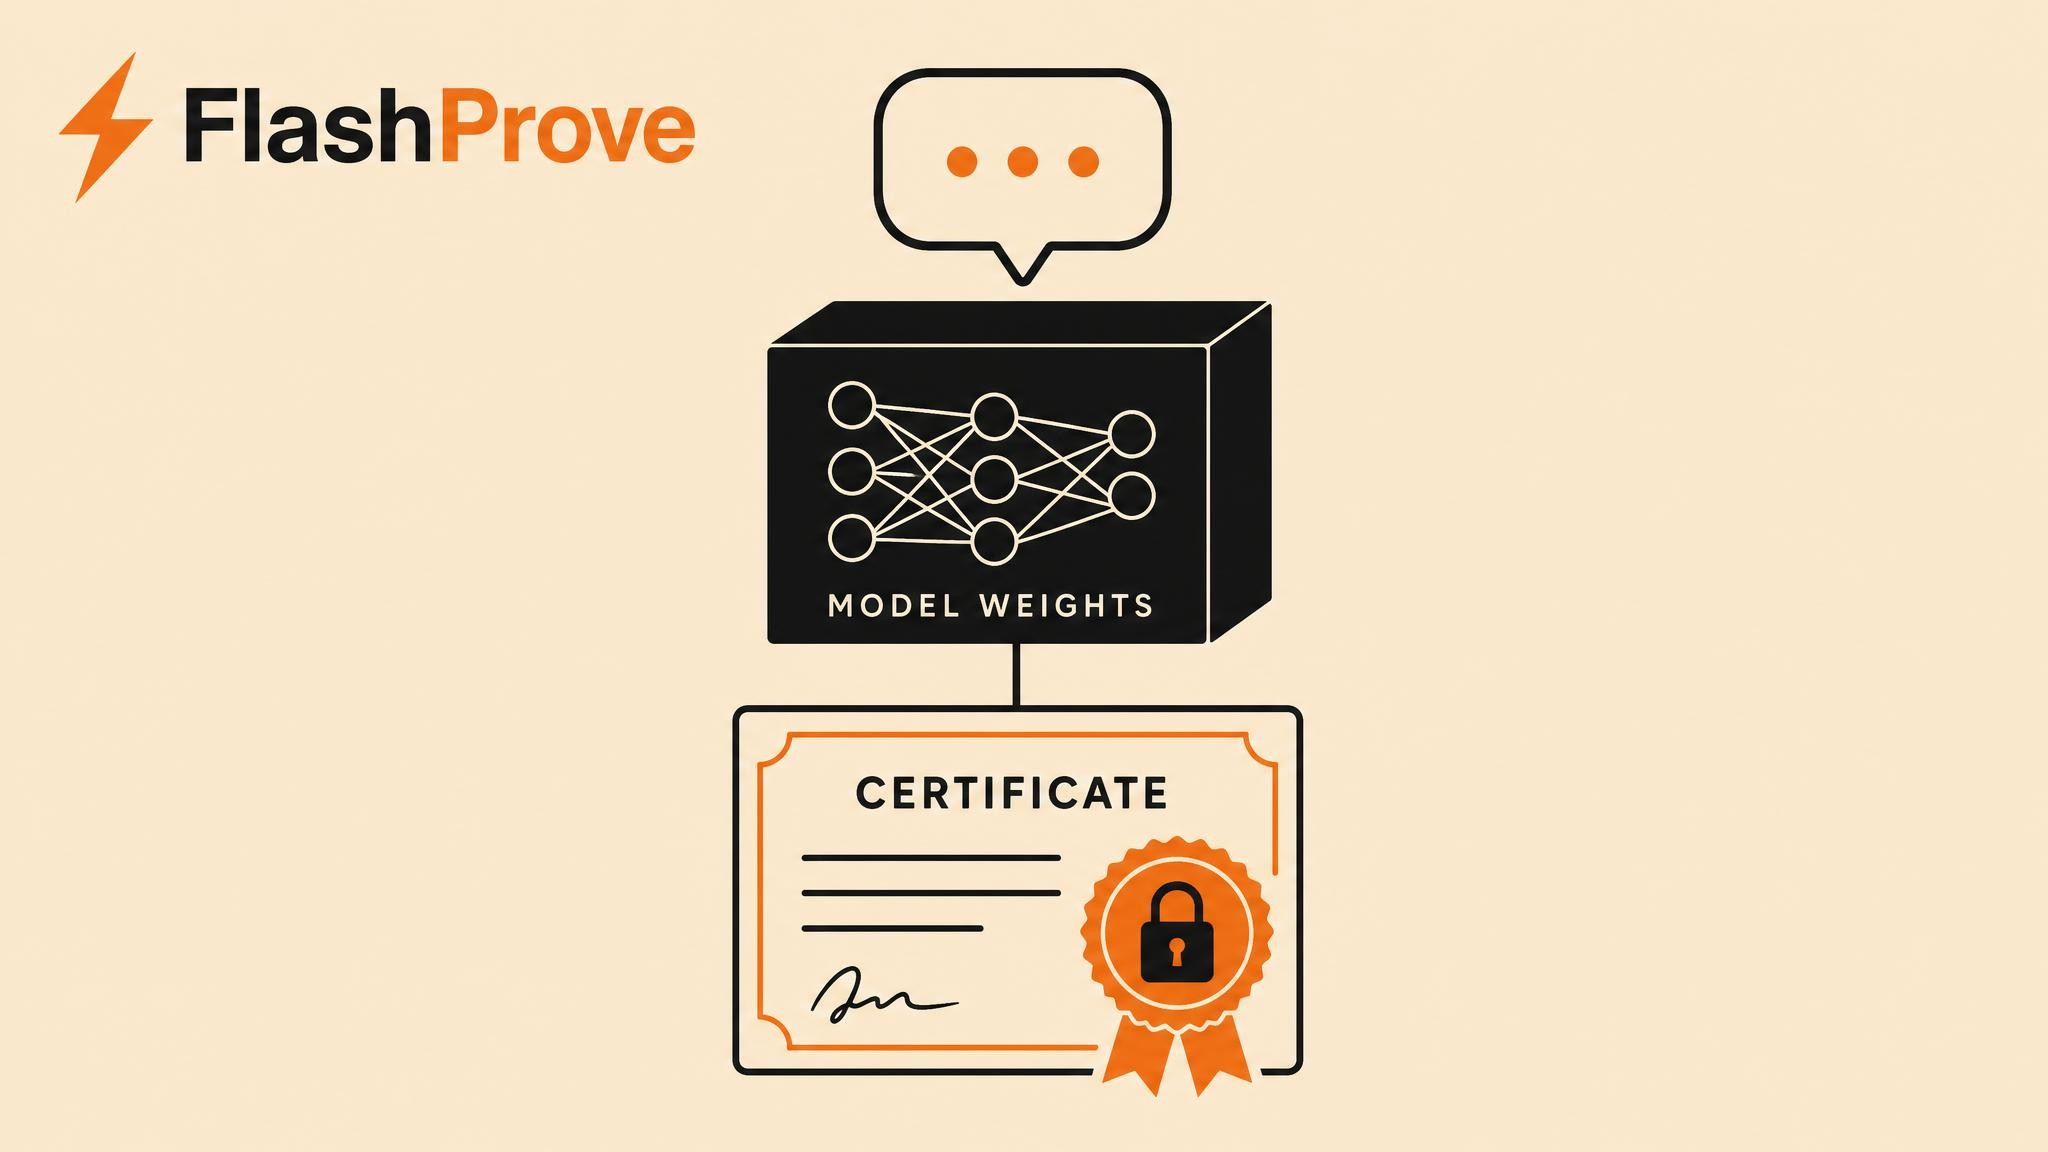
Anthropicが2026年11月2日、AIの回答が特定のモデルによって生成されたことを暗号技術で証明する「証明可能な推論」の研究成果を公開しました。中心は、オープンソースの試作システム「FlashProve」です。本稿では、その仕組みと性能、想定される用途、そして現時点での限界を解説します。
参考記事
- タイトル: Progress on provable inference for large language models
- 著者: Roy Rinberg、Alex Allain、Alessandro Chiesa、Miranda Christ、Rahul Dalal、Giacomo Fenzi、Ben Mayer、Guy Weissenberg(Anthropic Frontier Red Teamほか)
- 発行元: Anthropic
- 発行日: 2026年11月2日
- URL: https://www.anthropic.com/research/provable-inference
関連記事
要点
- FlashProveは、回答が約束どおりのモデルから生成されたことを、重みを明かさずに証明する仕組みである。
- 4000億パラメータのLlama 4 Maverickで、H100 1基あたり毎秒約110トークンの証明を生成した。
- 証明は約19MBで、GPUなしのCPUで十数秒で検証できる。
- 安全性の主張はLeanで形式証明され、コードとともにApache 2.0で公開された。
- 対象は整数版モデルの貪欲デコーディングに限られるなど、研究段階の制約がある。
詳細解説
背景: 「どのモデルが答えたか」を確かめる手段がない
Anthropicは、対面の友人なら顔や声で本人だと分かるのに対し、AIモデルと話すときにはそうした手がかりがほとんどないと指摘しています。現在のユーザーは、回答が開発者の主張するモデルから来たのか、それともルーティングサービス(複数のモデルへ要求を振り分ける中継サービス)がコスト削減のためにこっそり別のモデルに差し替えたのか、あるいは攻撃者がトークンの流れを改ざんしたのかを確かめられません。回答の品質が高くても、出力だけから判断するのは信頼できないとしています。
日常的な用途では、どのモデルが答えたかよりも回答の内容そのものが重要なため、この問題はそれほど切実ではありません。しかしAnthropicは、確認の手段があると役立つ場面として次の例を挙げています。
- リリース前後にモデルを試験する独立した評価者が、評価しているモデルと実際に提供されているモデルが同じだと知る必要がある場合
- 第三者のルーティングサービス経由でモデルを使う顧客が、料金を払ったモデルから回答が来ていると確かめたい場合
- 攻撃者が特定のモデルを装ってトークンの流れを書き換えた場合に、ユーザーがそれを検知したい場合
ただし、検証は簡単ではありません。最先端モデルの重み(学習によって得られたモデルのパラメータ)の多くは非公開で、仮に重みが手元にあっても、回答を確かめるにはモデルを実際に動かす必要があり、一般のユーザーや評価者が用意できる計算資源を大きく超えてしまいます。
そこで「証明可能な推論(Provable Inference、PI)」は、計算資源が限られ、重みの情報も持たないユーザーでも、回答が指定したモデルから来たことを確かめられるようにすることを目指します。Anthropicによれば、その動機は顧客の信頼を高めることに加え、独立した評価者への保証や法的義務の順守を示す手段として、AI開発のペース管理や規制にも関わる点にあるとしています。
中核技術: zkSNARKとは何か
Anthropicが用いたのは、zkSNARK(zero-knowledge succinct argument of knowledge)と呼ばれる暗号技術です。くだけた言い方をすると、証明者(prover)が短い「証明書」によって、ある計算が正しく実行されたことを検証者(verifier)に納得させる仕組みです。この証明書には2つの重要な性質があります。
- ゼロ知識性: 計算が正しいという事実以外の情報を一切明かさない
- 簡潔性: 証明の検証が、元の計算を実行するよりも指数関数的に速い
具体的には、モデル提供者が回答と一緒に数MB程度の短い証明を送り、ユーザーはそれを(理想的にはCPUで数秒で)検証します。回答が指定のモデルから外れていれば、検証は失敗します。同時に、暗号技術によって証明からモデルの重みが一切漏れないことが保証されます。
ゼロ知識証明は、ブロックチェーンの分野で取引の正しさを中身を明かさずに示す用途などで実用化が進んできた技術です。本稿としては、その考え方を大規模言語モデルの推論という非常に重い計算に当てはめ、実用的な速度に近づけた点が今回の成果の要だと受け止めています。
想定される4つの用途
Anthropicは、AIの普及に伴う信頼の課題として4つの場面を挙げ、それぞれにzkSNARKがどう役立つかを説明しています。
1. ペース管理(pacing): AI開発の規制やペース管理の提案には、ハードウェアとその使われ方を監視する方法が含まれています。たとえば、提供者がハードウェアを強力な新モデルの学習ではなく推論に充てるよう求められる場合、安いモデルを提供したり計算資源を想定外の方法で使ったりして、学習用の資源をひねり出す不正の余地があります。zkSNARKを使えば、規制当局は一定期間の推論要求について、主張どおりのモデルで生成されたことを示す証明書を求められます。提供者が持つような大がかりな設備がなくても主張の正しさを確かめられ、提供者側も独自のモデル情報が当局に漏れない保証を得られます。ただしAnthropicは、これでハードウェアが推論を行っていることは確かめられても、裏で学習をしていないことまでは証明できないと注記しています。Anthropicは9月に自社のAI開発の速さを数値化して公表しており、ペース管理を検証可能にする道具立ての一つとして今回の研究を位置づけていると読めます。
2. 改ざんの検知: モデルの価値が高まるにつれ、モデルを動かすサーバーは攻撃の主要な標的になります。攻撃者がサーバーに侵入し、重みを盗み出したり、ユーザーに悪意ある回答(マルウェアの配布など)を返したりしながら、本物の回答に紛れ込むおそれがあります。敵は外部とは限りません。モデルが自らを改良・展開できるようになると、承認されたモデルの代わりにより高性能なモデルが動き、適用されるはずの分類器や監視を避けるために弱いモデルを装う可能性もあるとしています。zkSNARKでは、証明が特定の重みのコミットメント(後述)に結びつくため、「何らかのモデル」ではなく「約束したモデル」が回答したことを証明できます。
Anthropicは、Frontier Safety Roadmapで「2026年9月30日までに、AIモデルの出力を特定の重みに帰属させる形で確実に『署名』する、証明可能な推論の試作を開発する」という公開目標を掲げていました。この目標は、推論トラフィックに署名し、信頼できるサーバー上で推論を再計算するという、別の関連プロジェクトによって達成済みだとしています。今回の研究は、同じ目的を異なる方法で追求する取り組みにあたります。なお、10月19日の更新で、目標の名称は「証明可能な推論」から「推論検証(inference verification)」に改められています。目的はトークンの流れの完全性を高い確度で保証することで、暗号による証明はそのための方法の一つだという位置づけです。
3. テキストの来歴証明: 開発者が「自社のライブラリを最先端のサイバーセキュリティモデルで脆弱性スキャンした」と主張したり、企業が「事業計画を適切なモデルが承認した」と主張したりする場合、ユーザーはそれをどう確かめればよいのか。チャットログを公開しても、安いモデルや劣化版のモデルで生成して偽装できてしまいます。zkSNARKを回答に添えれば、主張どおりのモデルが与えられた入力から出力を生成したことを、ユーザーは専用のハードウェアなしで素早く確認できます。Anthropicはさらに、「特定のモデルで少なくとも100万トークンを費やしても、特定のパッチにバグを見つけられなかった」ことを示す「Proof-of-Failure」のような使い方にも触れています。
4. モデルの承認: 規制によって、安全と承認されたモデルだけの提供が求められる可能性があります。リスクのあるモデルの方が性能が高かったり安く提供できたりする場合、提供者には規制を回避する動機が生まれます。zkSNARKを回答に添付させれば、承認されていないモデルを使った場合には証明が検証を通らないため、当局は各要求を再実行せずに軽い負担で確認できます。
信頼できるハードウェアとの関係についても補足されています。従来の研究の多くは、改ざん防止機能を持つ専用ハードウェア(TEE、Trusted Execution Environment)による方法に注目してきました。これに対し今回の研究は、計算問題の困難さに安全性を依拠するソフトウェアのみの暗号的な方法に焦点を当てています。ハードウェアやOSが侵害された環境でも、計算上解けない問題を解かない限り偽の証明は作れません。Anthropicは、両者は保証の性質とトレードオフが異なる補完的な方法で、どちらも役割を果たすとしています。
FlashProveの仕組み: 2つのフェーズと4つの保証
FlashProveは、大規模な混合エキスパート(MoE、Mixture-of-Experts)型言語モデルのための証明可能な推論システムです。MoEは、多数の「専門家」サブネットワークのうち、トークンごとに一部だけを動かす構造のモデルを指します。システムには、モデル提供者(証明者)とユーザー(検証者)の2者が関わり、処理は2つのフェーズに分かれます。
- オフラインフェーズ: 証明者がモデルの重みに対する「コミットメント」を公開する。コミットメントは、重みそのものを隠したまま、ただ一つの重みの組み合わせを特定する短い指紋のようなもので、以後の推論の主張はこれに照らして検証される
- オンラインフェーズ: 検証者からの要求(プロンプトと対応する出力トークン)に対し、証明者が「コミットしたモデルを評価すると、これらの出力トークンが得られる」ことを示す証明ファイルを作成する
コミットメント、プロンプト、回答を持っていれば誰でも、重みなしに、限られた計算資源で、その回答が約束した重みから生成されたことを確かめられます。証明ファイルが満たす性質は次の4つです。
- 完全性(completeness): 正直な証明者の証明は、検証者に受理される
- 健全性(soundness): 偽の主張に対して有効な証明を作ることは、広く信じられている暗号の仮定を破るのと同等で、事実上不可能である。そのため検証者は証明者を信頼する必要がない
- ゼロ知識性(zero-knowledge): 検証者は、重み、計算の中間値、各層でどの専門家が動いたかについて何も知ることがない。ただし、重みを除くモデルのアーキテクチャは隠されない
- 簡潔性(succinctness): 証明される計算は、量子化版で約232GBある4000億パラメータのモデルをH100上で動かすものだが、検証者が受け取る証明ファイルは約19MBで、24コアのCPUで数秒で検証できる
Anthropicは、完全性と健全性だけなら、重みを知る強力な検証者がモデルを動かして結果を照合すれば実現できると述べ、システムを意義あるものにしているのは後半の2つの性質だとしています。
性能評価: 4000億パラメータのモデルで毎秒110トークン
Anthropicは、Llama 4 Maverick(4000億パラメータのMoEで、1トークンあたり約170億パラメータを使用)の公開されている4ビット量子化版の重みを使って測定しました。検証者の各要求は1,024トークンの範囲で、証明者はH100 1基と24個のCPUコアを持つサーバー、検証者はCPUで動作します。主な結果は次のとおりです。
- オフラインフェーズ: モデルごとに1回実行し、約39分かかる。得られたコミットメントは約1,600万要求まで使え、その後は再度コミットする必要がある
- オンラインフェーズ: 24件の要求のバッチを約223秒で処理し、これは毎秒110トークンに相当する。各証明のサイズは18.78MB
- 検証者: GPUは不要で、重みのコミットメントのみを扱う。クライアントは合計約6.5MBのコミットメントをダウンロードし、その後は要求ごとに1つの証明を受け取る。証明の検証は、オフラインフェーズ分の確認を含めて24スレッドで17秒、1スレッドで21秒
通常の推論との比較として、Anthropicは広く使われる推論エンジンvLLMで同じモデルのFP8版をH100 8基で動かしました。GPUあたりで比べると、24件のバッチの証明には、vLLMが同じ24件を一度に処理する時間の約72倍(実行ごとに66〜77倍)、vLLMを試した中で最も高い負荷で動かした場合と比べると約94倍の時間がかかったとしています。
内部の仕組みとしては、イーサリアムなどのブロックチェーン向けのL2ネットワーク(StarknetやMantleなど)で使われている種類のzkSNARKが土台です。対話型オラクル証明(IOP)と呼ばれる情報理論的な構成要素を、ハッシュ関数を使って暗号的な証明に変換するという確立された手法に沿って作られており、量子コンピュータに対する耐性(耐量子安全性)も備えるとしています。
「通常の推論の70〜95倍」という数字は、決して軽い負担ではありません。ただ、後述のとおり従来手法とは桁違いの差があり、本稿としては「すべての回答に付ける」よりも、監査や規制対応のように一部の回答を抜き出して確かめる用途から現実味を帯びてくるのではないかと考えています。
設計上の工夫と「事後証明」という選択
FlashProveの性能を支える設計上の判断として、Anthropicは次の3点を挙げています。
- 実際に動いた専門家の分だけ証明する: MoEでは1トークンが4000億パラメータのうち約170億しか使わないため、証明の作業量も約170億パラメータ分に比例する。それでも、どの専門家が選ばれたかは証明から隠される
- 要求をまとめて事後に証明する: 完成した文章を1回の並列処理(プロンプトを一括処理するprefillと同様)で読み込み、重みのコミットメントを開く処理も要求ごとではなくバッチごとに1回にする
- GPU 1基に収まるよう設計する: 各層の重みを区切り、層のまとまりごとに証明する。重みは通常のメモリに置いて順に読み込むため、80GBのGPU 1基と約290GBのホストメモリで足りる
証明の仕組みを推論サーバーに組み込む際には、推論と同時に証明する「インライン型」と、一部のトークンについて事後に証明する「事後型」の選択があります。FlashProveは後者を採用しています。インライン型は非常に高速である必要があり、効率のために安全性を犠牲にする可能性がある一方、事後型は遅くてもよいため、そうしたトレードオフを避けやすいとしています。ただし事後型にも、再計算による複雑さの増加、トラフィックに対する保証が得られるまでの遅延、本質的な「非決定性」といった限界があると説明しています。
形式検証で信頼性を担保する
暗号のコードは壊れやすく誤りが入り込みやすいことで知られています。Anthropicは、公開するコードをどう信頼してもらうかという問いに対し、形式検証で答えています。Leanという証明支援系(数学的な証明をコンピュータで厳密に検査するための言語・ツール)でプロトコルと求める安全性を記述し、機械で検査できる形で証明しました。対象とした最上位の性質は次の3つです。
- 完全性: 主張が正しければ、得られた証明は検証者に受理される
- 健全性: 偽の証明は、無視できるほど小さい確率を除いて検証者に拒否される
- ゼロ知識性: 証明は、回答そのものから推測できる以上のモデルの重みに関する情報を明かさない
これらは、ハッシュ関数を使う暗号プロトコルを分析するための「ランダムオラクルモデル」の上で述べられています。
Anthropicは、Claudeは最適化が得意な一方で、特に大規模で複雑なシステムでは評価しにくい判断をしがちだと率直に述べ、その対策として監査可能な最上位の命題をLeanで示したとしています。そのうえで、形式検証には2つの信頼のすき間が残ると説明しています。1つ目は、形式的な命題がそもそも意図どおりの内容かを人が確認する必要があることで、その作業を助けるために対話型の可視化ツールを提供しています。2つ目は、実行可能なコードが形式的に定義されたプロトコルと一致しているかを確認する必要があることです。その扱いは性質ごとに異なります。
- 健全性: 検証者のコードさえ正しければよい。Leanで書かれた実行可能な検証者をC++版と並べて提供しており、Lean版は遅いが、健全性定理の検証者が受理するものだけを受理することがLeanで証明されている。日常的に使うのはC++版で、形式的な保証はないものの、テストではすべての証明でLean版と結果が一致した
- 完全性: 証明者も検証者も正直である前提のため、正しい主張で証明者を動かし、その証明をLean版の検証者にかけるという通常のテストで確信を得られる
- ゼロ知識性: 証明者のコードさえ正しければよいが、証明者は計算が重く、Lean版を動かすのは現実的ではない。モデルの重みを隠したい提供者には、Lean版との同等性をエージェントや人による入念なセキュリティ監査で確かめるだけの資源があると想定している
Claudeがフェルマーの最終定理をLeanで形式化した事例のように、AIが生み出す成果物を形式検証で裏づける流れは広がりつつあります。AIに複雑なシステムを作らせるほど、人がすべてを読んで確かめることは難しくなるため、「何を保証しているか」を機械で検査できる形にしておく考え方は、今後さらに重要になると思います。
先行研究との比較: 数年での急速な進歩
証明可能な推論は「zkML」と呼ばれる研究の流れに属します。Anthropicがまとめた主な先行研究は次のとおりです。
- SafetyNets(2017年): 2層の畳み込み層を持つMNIST用CNNと、小規模な音声モデルを検証
- zkCNN(2021年): VGG-16(1500万パラメータ)を1証明あたり88.3秒で証明
- Kangら(2022年): フル解像度のImageNetでMobileNet v2を証明
- ZKMLのGPT-2: 1億1700万パラメータで1トークンあたり約159秒(毎秒約0.006トークン)
- Modulus LabsのGPT-2 XL: 15億パラメータで90時間以上
- EZKL(2023年): 100万パラメータのGPT型モデルで1トークンあたり約966秒(毎秒約0.001トークン)
- zkLLM(2024年): LLaMA-2-13Bで2,048トークンの入力をGPU上で約15分(新規トークンあたり毎秒約0.001トークン、バッチ全体で毎秒約2.5トークン)
- zkGPT(2025年): GPT-2を21.8秒に短縮(毎秒約0.05トークン)
- zkPyTorch(2025年): Llama-3 8BをCPU 1コアで1トークンあたり約150秒(毎秒約0.007トークン)
- ZKTorch(2025年): GPT-J(60億パラメータ)を約20分(毎秒約0.001トークン)
- VerInf: 今回と同じLlama 4 Maverickを毎秒約0.02トークンで証明
- DeepProve: 査読済みの現行最先端とされ、生成された系列全体を1回の順伝播で証明する。1台でGPT-2が毎秒約2.9トークン、Gemma 3が毎秒約1.4トークン、分散環境で毎秒31トークン
- SASHの証明者(2026年): Llama 3.1 8BをH100 1基で毎秒約1.25トークン
商用でも、AttestableがGemma 4 31BをH100 1基で毎秒53〜77トークンで証明したと報告していますが、執筆時点でオープンソースのライブラリは公開されていないとしています。
Anthropicは、同じLlama 4 Maverickについて、VerInfはDGX Sparkで1,000トークンに14.3時間かかり、証明は93.6GBで検証にほぼ1日を要したのに対し、FlashProveはH100 1基で毎秒110トークン、証明は19MBで数秒で検証できると対比しています。そのうえで、この進歩は他のモデルやアーキテクチャにも波及し、通常の計算に対するオーバーヘッドがおよそ2桁(測定では70〜95倍)という、これまでの想定よりはるかに小さい道具になるとの見方を示しています。
公開物と現時点での限界
今回、Anthropicは次の5つを公開しました。コード、Leanの証明、文書はApache 2.0ライセンスで提供されています。
- 本ブログ記事(システムの概要と想定用途)
- システムの詳細を説明する技術報告書
- Claudeが執筆したプロトコル仕様書
- 実行可能なコード(証明者と、C++製の高速な検証者・Lean製の正しさが証明された検証者の2種類)
- 最上位の数学的命題のLean証明と、監査を助ける対話型の可視化ツール
なお、実験に使ったLlama 4 Maverickの重みは公開物に含まれておらず、利用者がHugging FaceからMetaのLlama 4ライセンスのもとで各自ダウンロードする形です。完全な実行例を動かすには、大型のGPUマシンとMetaのトークナイザーへのアクセスが必要とされています。Anthropicはこの公開を完成した研究ではなく途中経過の共有と位置づけ、他の研究者が取り込んで改良することを明確に期待しているとしています。
研究段階の試作として、次の技術的な限界も示されています。
- 高速なコードには形式的な保証がない: 論文と高速なコードはLeanのプロトコルから導かれているが、Lean・論文・コードの3つが一致していることまでは保証していない
- 整数版モデルと貪欲デコーディングが対象: 証明しているのは公開重みの厳密な整数版で、各トークンがそのモデルの貪欲な選択(最も確率の高いトークンを選ぶ方式)であることを示す。浮動小数点で動かした場合やサンプリングによる生成では、途中から証明した計算と一致しなくなる可能性がある。整数版は通常の浮動小数点推論と小さな誤差の範囲に収まると想定・確認されているが、敵対的に作られたプロンプトは対象外
- アーキテクチャは隠せない: システムはMoE構造を前提とし、その構造を効率化に利用している。密なモデルなど他のアーキテクチャも広く使われており、その構造自体が提供者の知的財産である場合もある。重みとアーキテクチャの両方を隠す仕組みは今後の課題
- サイドチャネル攻撃: 証明そのものは重みについて何も明かさないが、証明の生成時間を測るといったサイドチャネル攻撃で情報が漏れる可能性があり、今回は対象外としている
- 文脈長が短い: 現在証明できるのは最大1,024トークンの文脈で、数十万〜数百万トークンの文脈を持つ最先端モデルの実際の利用と比べるとかなり短い
特に文脈長の制約は、実際の対話やエージェント利用に当てはめるうえで大きな壁になると考えられます。一方で、課題を具体的に列挙し、コードと証明を誰でも確かめられる形で公開している点は、検証技術そのものの信頼性を高める進め方だと受け止めています。
まとめ
Anthropicは、回答が約束どおりのモデルから生成されたことを、重みを明かさずに証明するFlashProveを公開しました。性能は従来手法を大きく上回る一方、文脈長などの課題も残ります。暗号技術をAI評価に応用する動きとして、Googleによる二重盲検AI評価の解説もあわせてご覧ください。