はじめに
OpenAIは 2026年9月10日 、全二重音声モデル「GPT-Live-1」をAPIで公開しました。音声の聞き取りと発話を単一モデルで同時に処理し、割り込み対応や低遅延化を狙います。本稿では、性能指標、バックエンド委譲、料金、実装上の注意点を整理します。
参考記事
メイン記事:
- タイトル: Build more natural voice experiences with GPT‑Live‑1 in the API
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年9月10日
- URL: https://openai.com/index/introducing-gpt-live-1-in-the-api/
関連記事
要点
- GPT-Live-1は聞き取りと発話を単一モデルで同時に処理し、会話中の割り込み、相づち、沈黙へ連続的に応答する。
- Speakの初期評価では割り込みが約80%減少し、Full Duplex Benchの総合性能はGPT-Realtime-2.1より30ポイント向上した。
- 深い推論やツール呼び出しはGPT-6 Astraや第三者モデルへ委譲でき、速度、推論深度、コストをタスク別に設計できる。
- ターン取得遅延は0.798秒で、比較対象の1.41秒、1.63秒を下回り、Terra low併用時のツール呼び出しPass@1は87.0%だった。
- フロントエンド音声層は1分0.05ドルだが、バックエンドモデルとagent harnessの費用やツール遅延は別に見積もる必要がある。
詳細解説
全二重音声は、何を変えるのか
従来の音声エージェントは、音声認識で文字に変換し、言語モデルで考え、音声合成で読み上げる構成が一般的です。このSTT、推論モデル、TTSを連結する方式では、段階を移るたびに遅延が加わり、割り込みや短い相づち、話し直しの扱いを開発者が調整する必要があります。
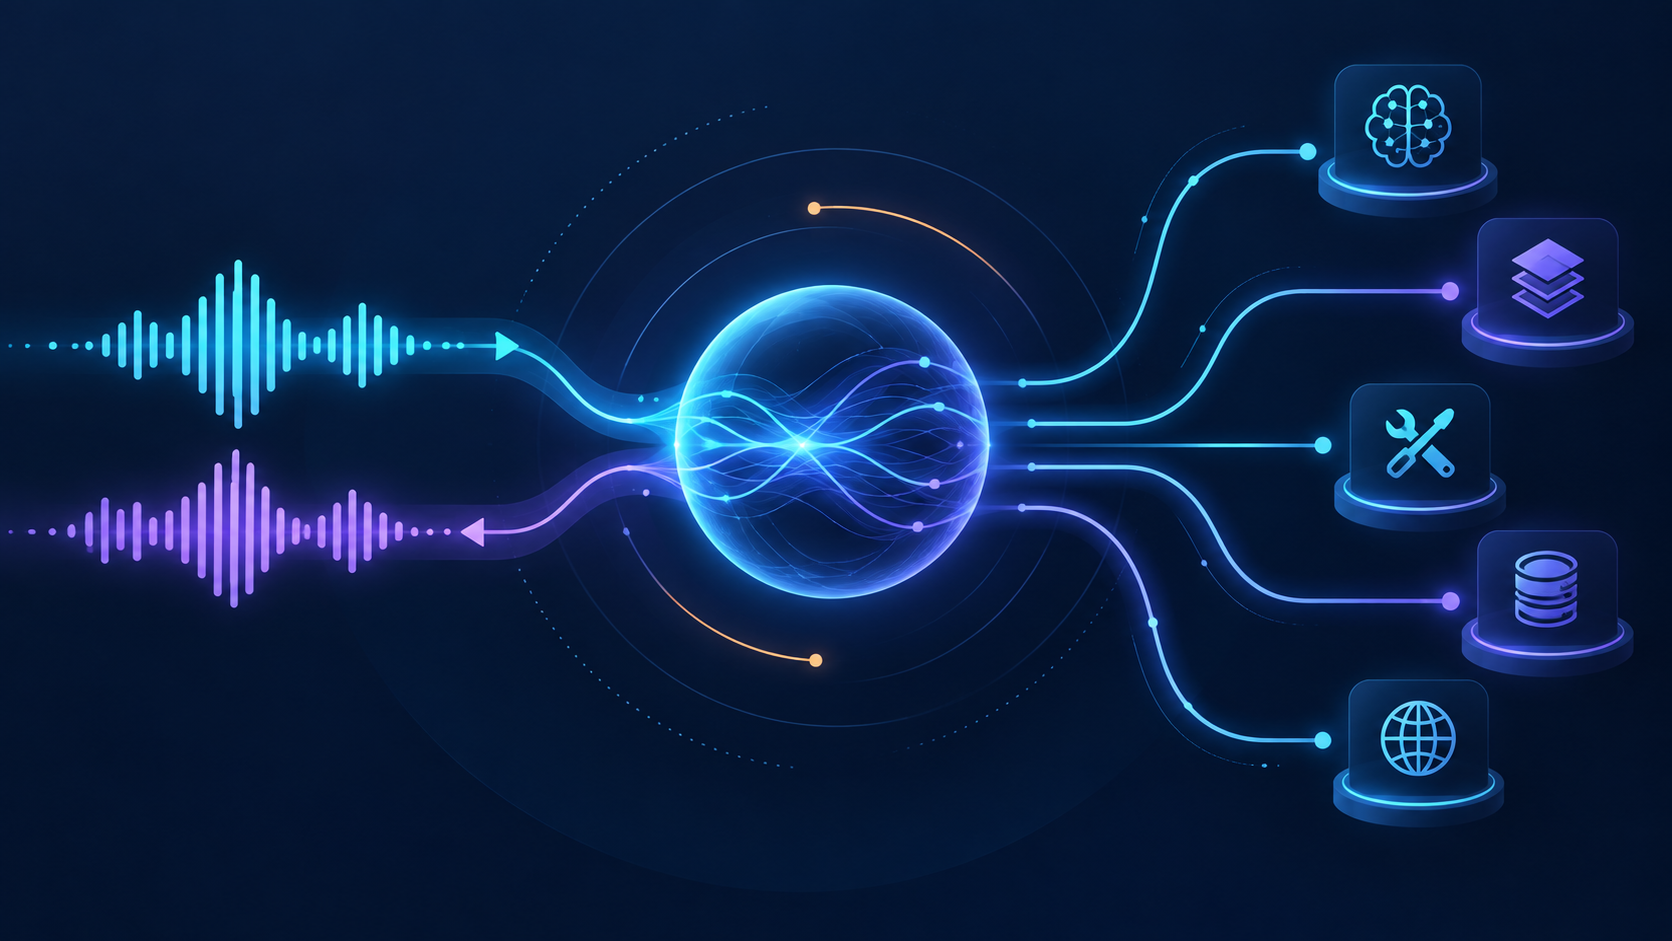
GPT-Live-1は、入ってくる音声と出ていく音声を同じモデルで扱います。相手が話し始めれば発話を止め、ためらいや沈黙を待ち、会話を続けながら裏側の処理を進められます。Speakの初期評価では、語学学習者が考える時間を取りやすくなり、従来のターン制システムと比べて割り込みが約80%減少しました。
全二重化は、モデルが常に話すという意味ではありません。背景雑音や別の人への発話を会話の指示と誤認しないこと、沈黙中に内部処理を逐一読み上げないことも含みます。OpenAIは背景雑音、沈黙、長時間セッション、電話を主要な改善対象に挙げ、レストラン予約や顧客サポートへの利用を想定しています。
音声層と推論層を分けて選べる
GPT-Live-1は自然な会話のタイミングを担い、重い推論やツール呼び出しをバックエンドへ渡せます。委譲先はGPT-6 Astraや第三者モデルで、OpenAIは大量処理はLuna、複雑な問い合わせはAstraという使い分けを例示しました。音声モデルだけを固定し、裏側のモデルを業務ごとに替える構成です。
この分離により、すべての発話へ最大の推論量を使わずに済みます。予約確認や注文更新は速く低コストなモデルへ、例外対応や複雑な質問は高い推論能力を持つモデルへ送れます。ただし、委譲の判定、ツール権限、確認が必要な操作、失敗時の復帰はagent harness側の責任です。音声が自然でも、裏側の操作まで自動的に安全になるわけではありません。
APIはASR文字起こし、応答テキストをネイティブに返します。英数字の理解、特定語を認識しやすくするkeyword biasing、明示的なターン境界で実装したい場合のturn detectionも利用できます。system promptでは声のトーン、速度、会話スタイルを調整できます。
コード削減は、音声層の一体化による
元記事の顧客事例では、従来のカスケード構成と比べてコードベースを80%簡素化し、2万3,000行を削減したと報告されています。音声認識、割り込み制御、発話状態、音声合成の間をつなぐコードを減らせた結果です。
ただし、この数字をすべてのシステムへ一般化はできません。既存構成の複雑さ、電話基盤、録音や監査の要件、ツール数によって削減余地は変わります。評価時にはコード行数だけでなく、割り込み失敗率、ターン遅延、ツール完了率、会話終了率、エスカレーション率を測る方が実運用に近づきます。
7つの指標で見る性能差
OpenAIは、GPT-Live-1がGPT-Realtime-2.1よりFull Duplex Benchで30ポイント向上したとしています。評価ごとにバックエンド条件が異なるため、数字を一列に並べるだけでなく、音声層単体と組み合わせ性能を分けて読む必要があります。
Astraをmedium reasoning effortで組み合わせたTau3 VoiceのPass@1は、GPT-Live-1が86.2%、GPT-Realtime-2.1が45.7%、GPT-Realtimeが42.4%でした。航空、流通、通信の音声顧客対応を対象に、各分野を同じ重みで評価しています。97件の銀行業務を扱うTau Bankingは32.0%、12.4%、10.3%で、知識検索と口座ツールを含むため全体に難しい結果です。
会話のタイミングでは、Artificial Analysisの会話ダイナミクスは97.3%で、比較対象は95.7%と95.3%でした。差がより大きいFull Duplex Bench v1.5のInteractivityは80.10%、45.4%、47.8%です。後者は背景の発話、別の人への会話、相づち、割り込みへの反応を測ります。
ユーザーが話し終えてからエージェントが応答を始めるまでのターン取得遅延は、0.798秒、1.41秒、1.63秒でした。低いほどよい指標で、GPT-Live-1は比較対象のおよそ半分です。音声体験では平均だけでなく、遅い側の分布や電話回線を含む端末間遅延も確認する必要があります。
Terraをlow effortで組み合わせたFull Duplex Bench v3では、自然な間、ためらい、言い直しを含む音声指示に対するツール呼び出しPass@1は87.0%、60.0%、58.0%でした。応答品質は90.0%、88.0%、81.0%です。ツール系列の正しさと、最後の音声回答の品質を別々に採点している点が重要です。
Codexへ委譲する実装例
元記事は、会話の文脈をCodexへ渡し、短い音声向け回答をGPT-Live-1へ返す概念例を掲載しています。主要部分は次のとおりです。
import { Codex } from "@openai/codex-sdk";

const thread = new Codex().startThread({
  workingDirectory: "./repo",
  sandboxMode: "read-only",
  approvalPolicy: "never",
});

async function answer(live, delegationId, context) {
  const { finalResponse } = await thread.run(
    `Answer the latest question using this repo.\nReply in two short spoken sentences.\n${context}`
  );
  live.send({
    type: "session.commentary.append",
    delegation_id: delegationId,
    content: finalResponse,
  });
}
この抜粋は接続設定と委譲処理を省略しています。sandboxMode: “read-only”とapprovalPolicy: “never”は、読み取り専用で承認不要の範囲だけを動かす例です。実際に予約変更、送信、購入、顧客データ更新まで行う場合は、操作ごとの権限と確認、監査ログ、タイムアウトを別に設計します。
注意: 元記事のコードは接続設定と委譲処理を省いた概念例で、そのまま本番へ投入できる完全な実装ではありません。
音声選択肢と料金の読み方
GPT-Live-1では、従来の少数のリアルタイム音声から、アクセント、方言、言語にまたがる選択肢へ拡大しました。記事ではQuartz、Ripple、Vesper、Willow、Stoneなどを含む音声例を示し、今後も選択肢と言語を増やすとしています。
APIは公開時点で利用でき、フロントエンド音声層の料金は1分0.05ドルです。ここでいう料金は会話全体の総額ではありません。バックエンドモデルとagent harness、ツール実行、電話回線、保存や監視の費用を加える必要があります。バックエンドの使い分けは性能だけでなく、1通話当たりの総費用で評価します。
カスタム音声は営業窓口へ問い合わせる提供形態です。企業向けには、質問回答、社内システム利用、承認済み操作、人へのエスカレーションをまとめるOpenAI Presenceも案内されています。標準APIの機能、カスタム音声、企業向け運用基盤は同じ提供条件ではないため、必要な範囲を切り分けて確認します。
導入時に確認したいこと
第一に、自社音声で全二重の評価セットを作ります。静かな室内だけでなく、電話、雑音、複数人、長い沈黙、話し直し、途中キャンセルを含めます。平均遅延だけでなく、誤割り込みと割り込み無視の双方を測ります。
第二に、音声層とバックエンドの境界をログへ残します。どの発話をどのモデルへ渡し、どのツールを呼び、ユーザー確認をどこで取ったかを追跡できるようにします。音声の自然さと業務結果の正しさを別の指標として管理することが重要です。
第三に、料金比較は音声層だけで終えません。モデル委譲、ツール、再試行、通話、監視を含む1件当たり費用と、完了率、有人転送率を組み合わせて判断します。公開ベンチマークは導入候補の比較材料であり、自社業務の結果を保証するものではありません。
まとめ
GPT-Live-1は全二重の音声処理とバックエンド委譲を分け、会話の自然さと推論能力をタスク別に構成できるAPIです。公開評価では割り込み、遅延、ツール利用が改善しました。導入時は1分0.05ドルの音声層だけでなく、委譲モデル、権限、確認、電話回線を含む全体で評価する必要があります。