はじめに
OpenAIは2026年8月13日、GPT‑5.6の開発者ガイドを公開しました。Sol、Terra、Lunaの使い分けと、Responses APIの推論保持、コンパクション、マルチエージェント、プログラムによるツール呼び出しを組み合わせ、性能と費用を調整する設計を解説します。
参考記事
- タイトル:A builder’s guide to GPT‑5.6
- 著者:Samarth Madduru、Prashant Mital、Dave Leo、Julien Reiman
- 発行元:OpenAI
- 発行日:2026年8月13日
- URL:https://openai.com/index/builders-guide-to-gpt-5-6/
関連記事
要点
- GPT‑5.6はSol、Terra、Lunaをタスクの難易度、速度、費用に応じて使い分ける設計が前提である
- Hyphaの抽出処理ではLunaがGPT‑5.5の98%の精度を18分の1の費用で達成した事例が紹介された
- Browser Useの難問106件ではLunaが78%を約14ドルで達成し、80%の比較システムは約235ドルだった
- Responses APIの推論保持とコンパクションにより、長時間エージェントの出力トークンを抑えながら成績を改善できる
- マルチエージェントとプログラムによるツール呼び出しは、複雑な処理を役割分担し、コンテキスト消費を抑える手段になる
詳細解説
最上位モデルを常に使わない
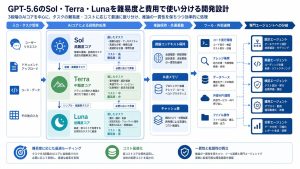
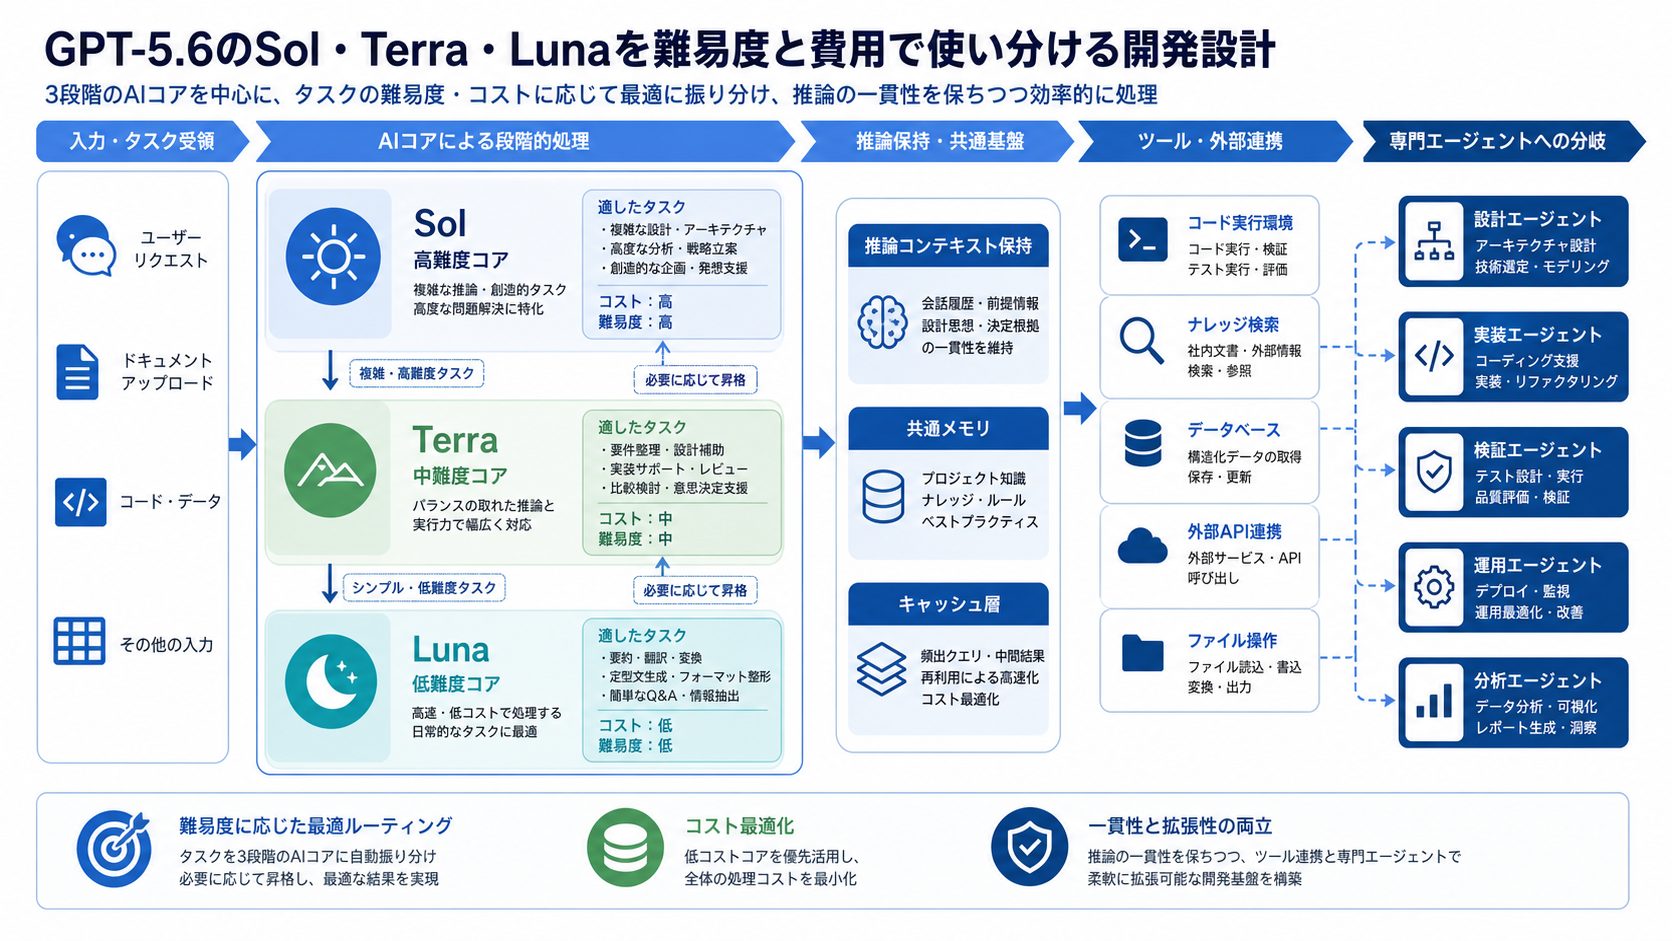
GPT‑5.6ファミリーは、高性能のSol、バランス型のTerra、低コストのLunaで構成されています。OpenAIのガイドが強調するのは、一つのモデルへすべてを任せるのではなく、タスクの難しさと失敗時の影響に応じて割り当てる方法です。定型的な抽出、分類、検索判断にはLunaを使い、曖昧な計画や高い正確性が必要な処理へTerraやSolを割り当てます。
Hyphaの情報抽出では、LunaがGPT‑5.5の98%に相当する精度を18分の1の費用で達成しました。Browser Useの難しい106課題では、Lunaが78%を約14ドルで処理し、80%の比較システムは約235ドルかかったとされています。わずかな性能差より費用差が大きい場合、再確認が容易な処理を軽量モデルへ寄せる価値があります。
モデル選択を固定ルールにしない
難易度は依頼文だけで判断できません。最初はLunaで実行し、根拠不足、ツール失敗、低い確信度、規定回数を超える再試行が発生したときにTerraやSolへ切り替える方法が現実的です。高リスクな契約判断や本番変更は最初から上位モデルと人の承認を組み合わせます。
比較では正答率だけでなく、処理時間、入力・出力トークン、ツール回数、再試行、最終的な人の修正時間を記録します。PlayerZeroの事例では、高スループットなコード検索と判断でGPT‑5.6を既定にし、費用64%削減、応答時間90%短縮、F1スコア5ポイント改善が報告されました。用途ごとの実測がモデル選択を支えています。
推論保持とコンパクション
長時間のエージェントでは、会話履歴やツール結果が増え、入力費用と遅延が大きくなります。Responses APIでは、過去の推論状態を保持して次の処理へ渡し、必要に応じて履歴をネイティブに圧縮できます。ARC‑AGI‑3の評価では、Solの標準構成が13.3%だったのに対し、推論保持とコンパクションを使った構成は38.3%へ改善し、出力トークンは約6分の1になりました。
これは単なる要約とは異なります。エージェントが判断に必要な状態を残し、古いツール出力や重複説明を圧縮することで、長い作業でも方向性を保ちやすくします。どの情報を保持し、何を捨てたかをログに残し、重要な制約が失われていないか検証する必要があります。
マルチエージェントとプログラムによるツール呼び出し
Responses APIは、親エージェントが必要に応じて専門エージェントを起動し、結果を統合する構成を支援します。調査、コード確認、データ分析などを分けることで、各エージェントの文脈を小さく保てます。ただし、何でも並列化すると費用と調整コストが増えます。独立して検証できる作業だけを分け、最終判断の責任を一つに集める設計が必要です。
プログラムによるツール呼び出しでは、モデルがJavaScriptを生成し、複数ツールの呼び出し、絞り込み、集計をコンテキスト外で実行します。Rogoの事例では、評価品質を保ちながら入力トークンを21%削減しました。大量の検索結果をすべてモデルへ戻さず、必要な情報だけ渡すことで費用と混乱を抑えられます。
キャッシュを前提にプロンプトを構成する
共通するシステム指示やツール定義が長い場合、プロンプトキャッシュの利用も重要です。GPT‑5.6では最低30分のキャッシュ保持と、決定的な区切り位置を設計できます。Ployでは約2万9,000トークンの共通プロンプトを複数処理で共有し、キャッシュされない入力を28%減らしたと報告されています。固定部分を前、依頼ごとに変わる部分を後ろへ置く構造が基本です。
まとめ
GPT‑5.6の実用性は、最上位モデルの性能だけでなく、モデル選択、履歴管理、ツール連携、キャッシュを一体で設計することで高まります。まず代表業務を難易度とリスクで分類し、Lunaから上位モデルへ切り替える条件を決め、タスク単価と人の修正時間を測ることが導入の第一歩です。