はじめに
OpenAIは2026年8月13日、GPT‑5.6 Solを標準階層の最大14倍、毎秒最大750出力トークンで提供する「Ultrafast」を発表しました。障害対応、調査、顧客対応、音声など低遅延が重要な用途を想定しています。本稿では導入判断のポイントを解説します。
参考記事
- タイトル:Previewing Ultrafast mode: GPT‑5.6 Sol at up to 14X the speed
- 著者:OpenAI
- 発行元:OpenAI
- 発行日:2026年8月13日
- URL:https://openai.com/index/previewing-ultrafast/
関連記事
要点
- UltrafastはGPT‑5.6 Solを標準サービス階層の最大14倍、最大毎秒750出力トークンで提供する
- Cerebrasの推論基盤を採用し、まずAPIの一部顧客向け限定プレビューとして開始される
- 想定用途は障害対応、金融・セキュリティ調査、顧客対応、音声、商取引、ライブ実験である
- 生成速度が上がっても、ツール実行、検索、ネットワーク、承認工程がボトルネックになる可能性がある
- 導入効果はトークン速度ではなく、業務全体の完了時間、正確性、費用、再試行回数で評価すべきである
詳細解説
最大14倍・毎秒750トークンの高速階層
Ultrafastは、新しいモデルではなく、GPT‑5.6 Solを低遅延で提供するサービス階層です。OpenAIによれば、標準階層と比べて最大14倍の速度、最大毎秒750出力トークンを実現します。推論基盤にはCerebrasが使われ、限定された顧客からプレビューを開始し、処理能力の拡大に合わせて対象を広げる計画です。
AIの応答速度は、単に待ち時間を短くするだけではありません。人が画面の前で結果を待つ業務では、数十秒の差が集中の中断や確認回数に影響します。エージェントが何度もモデルへ問い合わせる処理では、1回ごとの差が積み重なり、タスク全体の所要時間を大きく左右します。
速度が価値へつながる用途
OpenAIは、障害対応でログ、トレース、利用者との会話を横断して原因候補を絞る用途を挙げています。障害中は数分の遅れが影響拡大につながるため、調査の初動を速める価値があります。ただし、OpenAI社内でもエンジニアが判断とデプロイの責任を持ち、モデルへ変更を任せ切る運用ではありません。
金融調査やセキュリティ分析では、大量資料から論点を抽出し、追加質問を繰り返す速度が重要です。顧客対応や音声では、返答までの遅れが会話の自然さへ直結します。商取引では商品比較や在庫確認、ライブ研究では仮説作成と検証の反復を速められます。Jane Street、Podium、Basis、Rogoなどが早期利用企業として紹介されています。
モデル以外の遅延を分解する
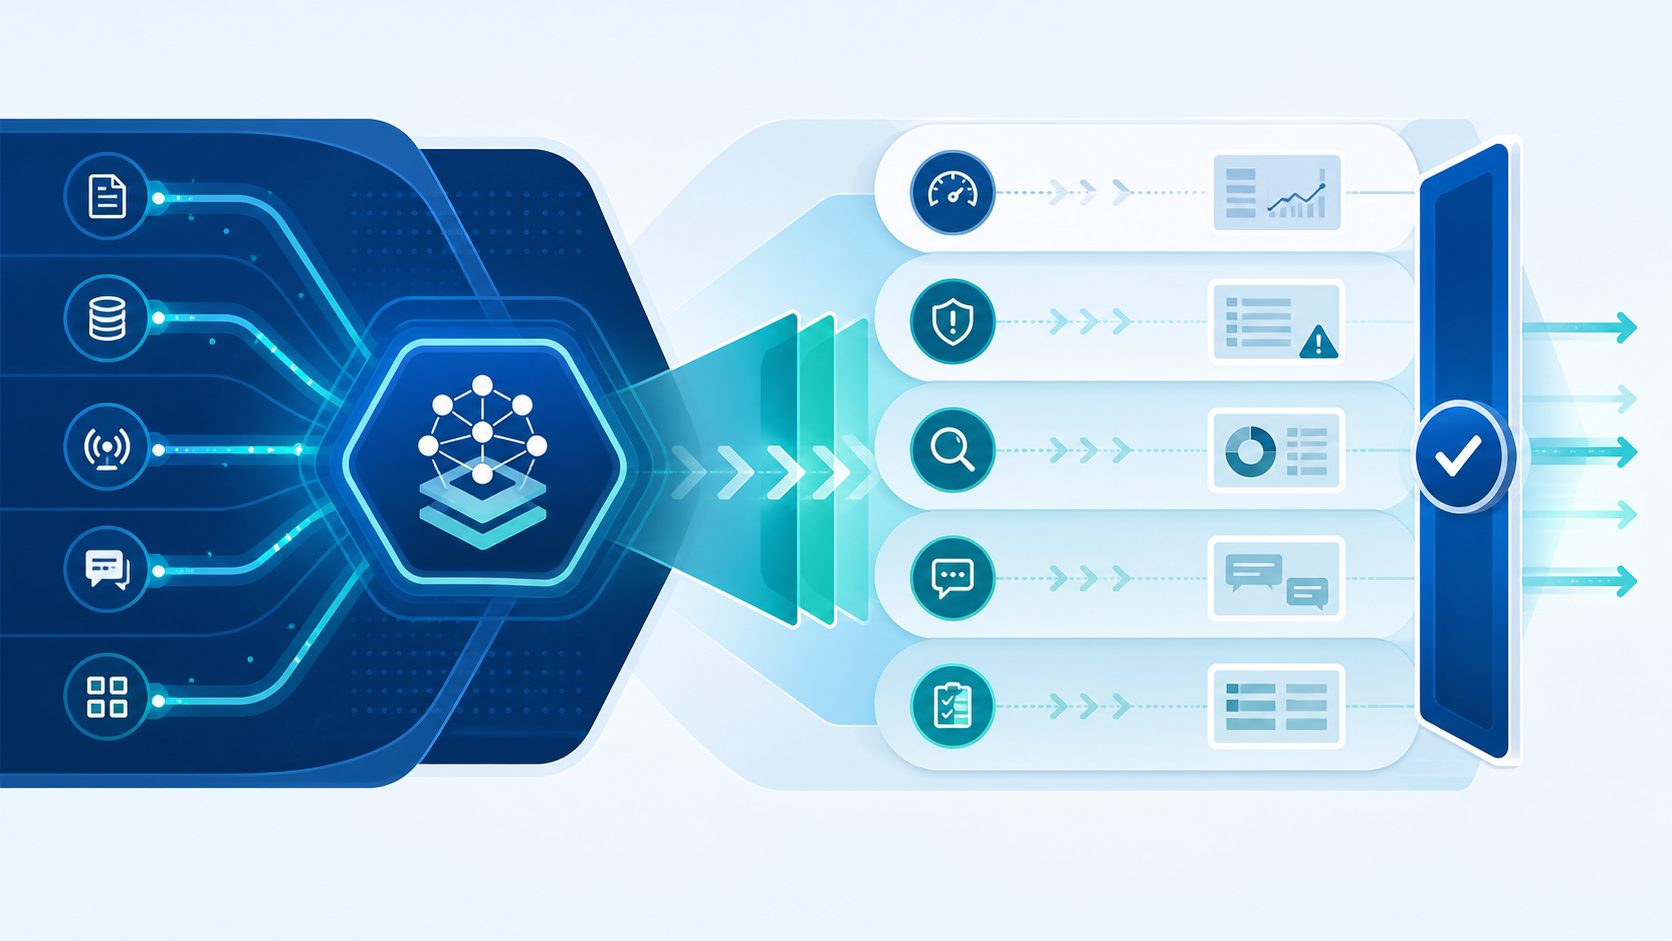
毎秒750トークンという数値はモデル出力の速度です。実際のアプリケーションでは、入力準備、検索、データベース照会、外部ツール実行、安全性チェック、ネットワーク転送、画面描画、人の承認にも時間がかかります。出力だけを14倍にしても、他の工程が長ければ全体は14倍にはなりません。
導入前には、現在の処理を「モデル待ち」「ツール待ち」「システム待ち」「人の確認」に分けて計測する必要があります。モデル待ちが支配的な用途であればUltrafastの効果が見込めます。外部APIや社内承認が支配的なら、先にワークフローの並列化、キャッシュ、権限設計を見直す方が効果的な場合があります。
高速化で増える運用上の注意
出力が速くなると、誤った前提のまま多数のツール操作へ進む速度も上がります。実行前の確認、操作回数の上限、書き込み権限、異常時の停止、監査ログを設計しなければなりません。特に障害対応、金融、セキュリティでは、提案生成と実行を分け、人が承認する境界を残すことが重要です。
また、限定プレビューでは料金、利用上限、リージョン、可用性保証が一般提供と異なる可能性があります。本番の基幹処理を直ちに依存させるのではなく、待ち時間の影響が大きく、失敗時に人が戻せる作業から試す方法が安全です。
評価指標は業務全体で置く
比較では、最初のトークンまでの時間、出力完了時間だけでなく、タスク完了時間、成功率、再試行回数、ツール呼び出し数、1件当たり費用を測ります。人が結果を修正する時間も含めるべきです。速い回答を何度もやり直すより、少し遅くても一度で正しい回答の方が業務全体では効率的な場合があります。
まとめ
Ultrafastは、GPT‑5.6 Solによる対話やエージェントの反復を速める選択肢です。ただし、最大14倍は業務全体の改善率ではありません。遅延の場所を測り、権限と承認を保った小さな業務で検証し、完了時間と費用を基準に採用を判断する必要があります。