はじめに
Microsoft Researchが2026年6月29日、AIエージェント向けの長期記憶フレームワーク「Memora」を発表しました。長期タスクに取り組むエージェントが直面する「記憶の断片化と文脈喪失」という課題に対し、抽象性と具体性を両立させる新しいアプローチを提案しています。本稿ではその仕組みと性能評価を解説します。
参考記事
- タイトル: Memora: A Harmonic Memory Representation Balancing Abstraction and Specificity
- 著者: Xuchao Zhang, Molly Xia, Mayukh Das, Anson Bastos, Rujia Wang, Chetan Bansal, Saravan Rajmohan
- 発行元: Microsoft Research
- 発行日: 2026年6月29日
- URL: https://www.microsoft.com/en-us/research/blog/memora-a-harmonic-memory-representation-balancing-abstraction-and-specificity/
関連記事
要点
- Memoraは「何を保存するか(記憶の内容)」と「どう取り出すか(軽量な抽象表現)」を分離することで、精度と効率を両立するエージェント向け記憶フレームワークである
- LoCoMoベンチマーク(平均600ターンの対話)でLLMジャッジ精度86.3%、LongMemEval(11万5000トークンの文脈)で87.4%を記録し、RAG・Mem0・全文脈推論を上回る
- フルコンテキスト推論と比較してトークン消費を最大98%削減しつつ、性能は上回るという効率性を実現している
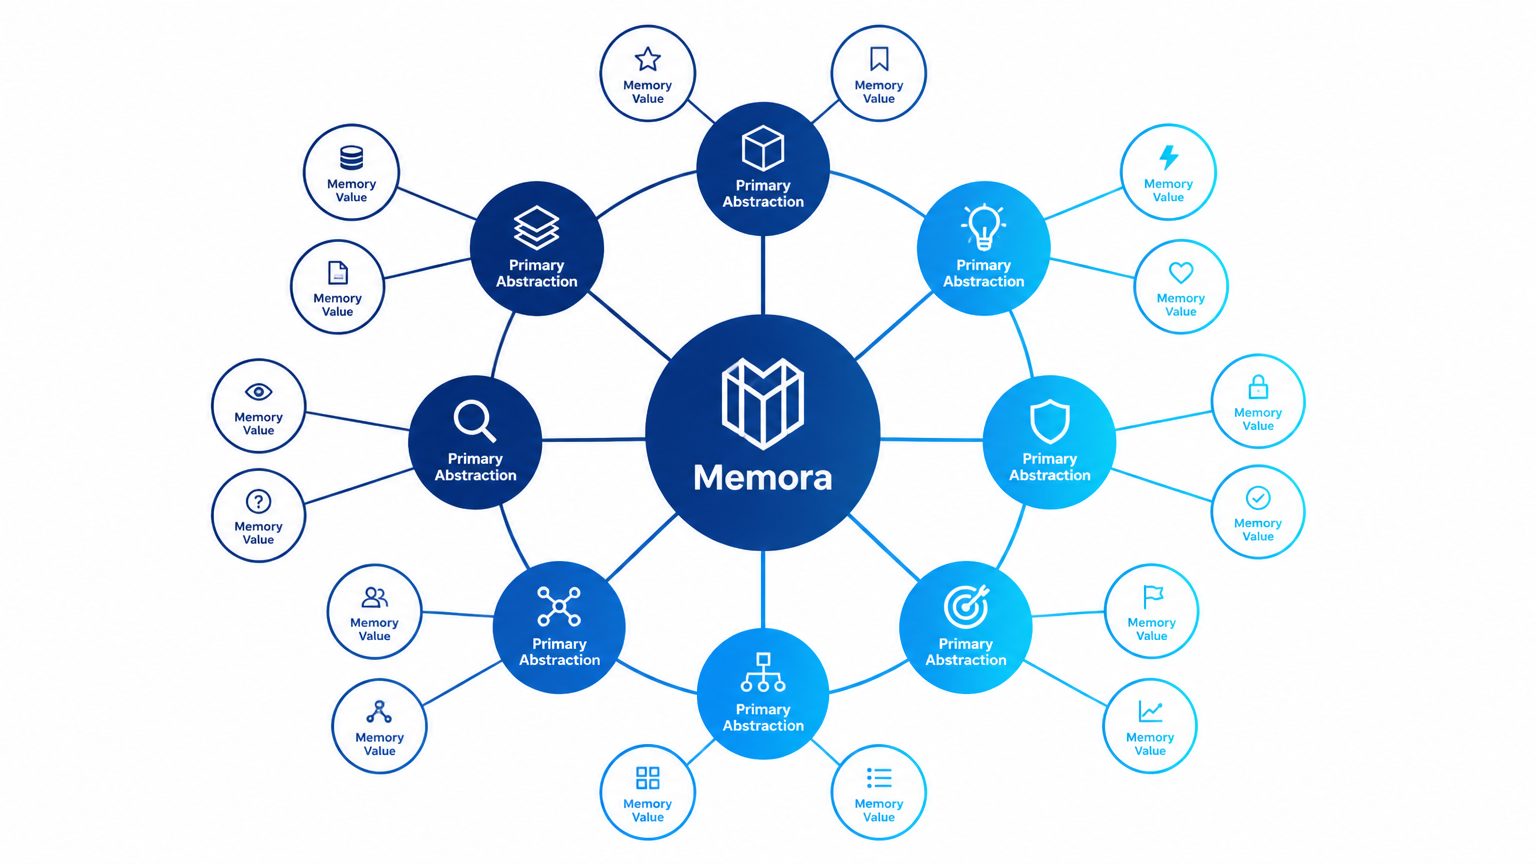
- 各記憶エントリには「プライマリ抽象」(6〜8語の短いフレーズ)と豊富な内容を持つ「記憶値」が対になっており、検索は抽象レイヤーのみで行われる
- 論文はICML 2026に採択され、コードはGitHubで公開されている
詳細解説
現在のAIエージェントが抱える「記憶問題」
現代の大規模言語モデル(LLM)は高度な推論能力を持ちながら、実質的にステートレス(状態を持たない)な存在です。セッションをまたぐたびにゼロからスタートし、長い会話になればなるほどモデルは全履歴を再読しなければならず、処理コストが膨らみます。記憶として保存する場合も、生テキストそのまま(断片化・ノイズ多)か、粗い要約(細部の喪失)かのどちらかに偏りがちでした。
この課題を解決しようとしてきたシステムには、Mem0のような「原子的な事実の抽出」、RAG(Retrieval-Augmented Generation)のような「テキスト断片のインデックス化」、Zep・GraphRAGのような「グラフ構造による知識表現」などがあります。Microsoft Researchの発表によれば、いずれも「具体性(specificity)」と「抽象性(abstraction)」のトレードオフという壁を越えられていないと指摘しています。Memoraはこの壁を取り払うことを目指したフレームワークです。
Memoraの核心——「保存」と「検索」の分離
Memoraの中心的なアイデアは、記憶の内容と取り出し方を切り離すことです。各記憶エントリは2つの要素で構成されます。
- プライマリ抽象(Primary Abstraction): 記憶の本質を6〜8語で表現した短いフレーズ。類似度検索に使われるのはこのレイヤーのみです。
- 記憶値(Memory Value): プロジェクトの議事録、制約事項の議論、意思決定の経緯など、豊富な内容そのものです。
この分離により、同じトピックに関する新しい情報が入ってきたときに「新しいエントリとして断片化する」のではなく、既存のエントリに統合・更新されます。従来のRAGが同じプロジェクトの話題を複数の断片として保存しがちだったのに対し、Memoraは同一プライマリ抽象のもとで情報を集約できます。
キューアンカー——柔軟な検索経路
プライマリ抽象を補う仕組みとして、キューアンカー(Cue Anchors)があります。これは記憶値から抽出される短い文脈依存タグで、同一の記憶への別の入口として機能します。
Microsoft Researchが挙げている例で具体的に見てみます。「DaveとSarahが、プロトタイプを4月1日、パイロットを5月2日、MVPを5月30日に延期することで合意した」という情報をMemora に保存する場合を考えます。
- プライマリ抽象: “Updated Project Orion timeline agreed by Dave and Sarah”
- キューアンカー: “Dave Project Orion update”、”Project Orion prototype schedule”、”Project Orion pilot timeline” など
後から「Daveの最近の貢献は?」「プロトタイプのスケジュールは?」「パイロットの時期は?」という異なる問いかけをしても、それぞれのキューアンカーが同じ記憶値へ誘導します。知識グラフシステムでは事前にエンティティ型やリレーション型を定義する必要がありますが、Memoraではオントロジー(概念体系の定義)なしで柔軟な多経路検索を実現しています。
ポリシーガイド付き検索
検索の仕組みも工夫されています。Memoraのポリシーガイド付き検索器(Policy-Guided Retriever)は、「トップk件の類似アイテムを一度に返す」単純な方式ではなく、検索を能動的な推論プロセスとして扱います。具体的には、クエリを反復的に絞り込みながら、キューアンカーを通じて関連する(ただし意味的に直接類似はしていない)記憶にも到達できます。人間が関連する出来事を思い出すときの「連想」に近い動作です。検索ポリシーは、強力なLLMへのプロンプトで実現するか、強化学習によってより小さなモデルに蒸留することもできます。
ベンチマーク性能
Microsoft Researchの評価によれば、2つの長文脈ベンチマークでいずれも最高性能を記録しました。
- LoCoMo: 平均600ターンの対話を評価するベンチマーク。LLMジャッジ精度 86.3% を達成し、RAG・Mem0・Nemori・Zep・LangMem・フルコンテキスト推論すべてを上回りました。
- LongMemEval: 11万5,000トークンという非常に長い文脈での評価ベンチマーク。こちらでも 87.4% を記録し、同様に競合手法を凌駕しています。
効率性の面でも注目すべき数値が出ています。Memoraの1会話あたりの記憶エントリ数は平均344件で、Mem0の651件と比較して約47%少ない水準です。さらにトークン消費量はフルコンテキスト推論と比べて最大98%削減されています。「より少ないトークン、より少ないエントリで、より良い回答が得られる」というのがMicrosoftの評価です。
多ホップ推論(複数の記憶をたどって回答を導くタスク)での差が特に大きいとされており、キューアンカーによる連想的な検索が効いている領域と考えられます。
論文とコード
この研究はICML 2026(国際機械学習会議)に採択されており、論文はarXiv(https://arxiv.org/abs/2602.03315)で公開されています。コードはGitHub(https://github.com/microsoft/Memora)で公開されており、研究者や開発者がMemora上で独自の記憶システムを構築・実験できる状態になっています。
なお、本稿執筆時点では公開されたコードの動作確認は行っておらず、実際の利用にあたってはリポジトリのREADMEや論文を直接ご確認ください。
今後の研究方向
Microsoftの研究チームはMemora以外にも3つの発展的な方向を探っているとしています。MemLoopは検索・タスクの失敗から学習し、記憶パイプラインの特定ステージに誤りを帰属させて自己改善するアプローチです。Deferred Memory(遅延記憶)は、保存のタイミングを先送りし、十分なコンテキストや将来の有用性が見えてから記憶を確定させる考え方で、早急にコミットしてしまうことによる情報損失を防ぐことを目指しています。Group Memoryは複数のエージェントや人間チームにわたって知識を共有しながら、情報の出所・アクセス権・所有権・機密性を維持する仕組みです。
まとめ
Microsoft Researchが発表したMemoraは、「何を保存するか」と「どう検索するか」を分離するというシンプルな原則で、長期記憶における精度と効率の両立を実現しています。AIエージェントが月単位・年単位で人間と協働し、組織的な知識を蓄積していくためのインフラとして、今後の実用化が注目されるところです。エージェントのメモリ設計に関心のある方は、ChatGPTのDreaming V3によるメモリ刷新もあわせてご覧いただければと思います。