はじめに
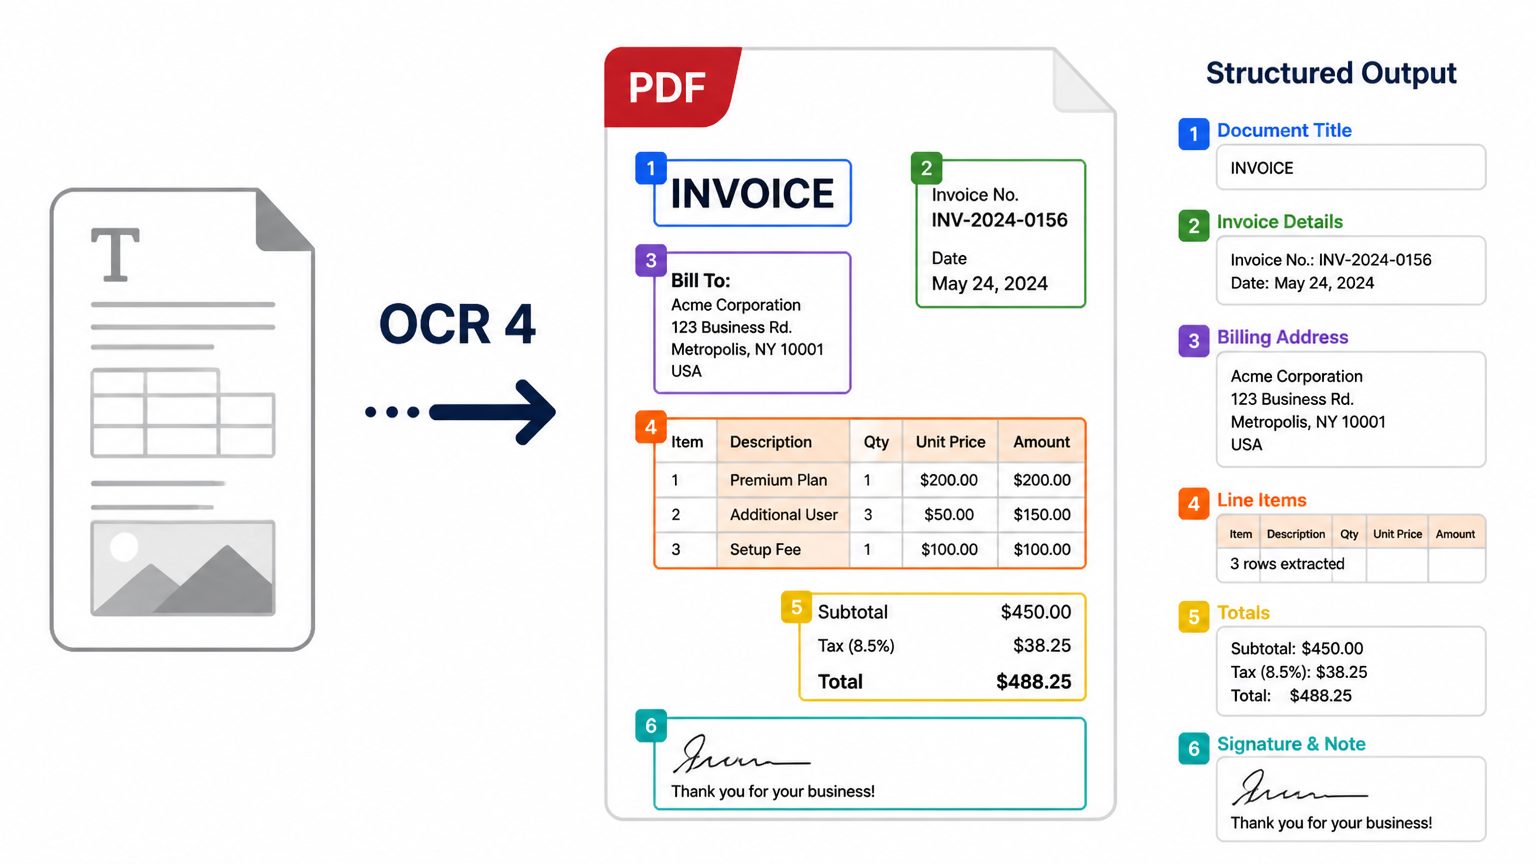
Mistral AIが2026年6月23日、文書構造化OCRの新バージョン「OCR 4」を公開しました。テキスト抽出に加え、バウンディングボックス・ブロック分類・信頼スコアをセットで返す設計が特徴です。RAGや企業内検索のデータ基盤として訴求しており、本稿ではその性能評価と活用シーンを解説します。
参考記事
- タイトル: Introducing OCR 4
- 著者: Mistral AI
- 発行元: Mistral AI
- 発行日: 2026年6月23日
- URL: https://mistral.ai/news/ocr-4/
関連記事
要点
- Mistral OCR 4は、テキスト抽出にバウンディングボックス・ブロック分類・信頼スコアを加えた構造化出力対応のOCRモデルである
- 人間による比較評価では全比較対象に対して平均 72% の勝率を記録し、OlmOCRBenchで 85.20 のトップスコアを達成している
- 170言語・10言語グループに対応し、低リソース言語でも競合システムより高い精度を維持している
- シングルコンテナでの自己ホスト運用が可能であり、データ主権・コンプライアンス要件を持つ組織に対応している
- RAG取り込み・エージェントワークフロー・企業内検索・構造化データパイプラインでの活用が想定されている
詳細解説
テキスト抽出から「構造化文書理解」へ
従来のOCRモデルが主にページ内のテキストと表を文字列として抽出することに注力していたのに対し、OCR 4は文書の「構造的な表現」を返すことを設計の核心に置いています。各ブロックにはバウンディングボックス(テキストの位置座標)・ブロックタイプ(タイトル・表・数式・署名など)・ページ単位および単語単位の信頼スコアが付与されます。
Mistral AIによれば、この構造化された出力によって、下流のシステムは「文書に何が書かれているか」だけでなく、「各要素がどこにあるか」「どのような役割を担っているか」「モデルがどれほど確信しているか」という情報を同時に得られるとのことです。これによりコンテキスト内ハイライト・信頼性の高いデータパイプライン・ソースを明示した引用・人間が介在する検証フローなどが実現できるとしています。
対応フォーマットはPDF・DOC・PPT・OpenDocumentなど一般的なエンタープライズ形式を網羅しており、単一の取り込みコンポーネントで多様なドキュメントを扱える設計です。
ベンチマーク性能——数値と留保を合わせて読む
Mistral AIによれば、OCR 4は複数の評価軸で先行システムを上回る結果を示しています。人間による比較評価は600件以上の文書・12以上の言語を使用した設計で、独立した評価者が各競合の出力とOCR 4の出力を盲目的に比較したものです。結果として全比較対象に対して平均 72% の勝率を記録したとのことです。
公開ベンチマークでは、OlmOCRBenchで 85.20(テスト対象中トップ)、OmniDocBenchで 93.07 を記録しています。内部の多言語評価「Crawl Multilingual」でも .98 の最高スコアとしています。一方で同社は、これらのスコアについて一定の留保を示しています。スコアのミスマッチの多くが「モデルの誤りではなく評価手法の問題」によるものだとし、具体的には参照アノテーション自体の誤り・同一の意味を持つ異なるLaTeX記法の不一致カウント・複数カラム文書での読み順解釈差などを挙げています。
同社は「スコアは方向性を示すものとして解釈すべきであり、自社の文書での評価を推奨する」と明記しており、ベンチマークの限界を公式に認めたうえで透明性を保つ姿勢は評価できると思います。ベンチマーク評価が実用環境での性能と乖離しやすい点は、OCR分野に限らずAIモデル全般に共通する課題だと考えられます。
多言語対応と自己ホスト展開
OCR 4は170言語・10言語グループ(英語・西欧・東欧・中東・中国語・東アジア・東南アジア・特殊言語など)に対応しています。Mistral AIの内部評価では8つすべての言語グループでトップの精度を記録し、ヒンディー語・日本語・ジョージア語・ベンガル語・アルメニア語など低リソース言語や特殊言語での精度低下が少ない点を強みとして挙げています。
また、シングルコンテナで動作する設計のため、自社インフラ内での完全な自己ホスト運用が可能です。文書データを外部サービスに渡さず処理できるため、データ主権・居住要件・コンプライアンス要件を持つ金融・医療・法務分野の組織にとって実用上の意義が大きいと考えられます。自己ホスト展開はエンタープライズ顧客向けに提供されているとのことです。
活用場面と「対象外」の明示
Mistral AIはOCR 4の主な活用シーンとして次を挙げています。RAG向けには分類済みのクリーンなブロックが質の高い検索ユニットとなり、引用元を明示した回答生成にも活用できます。エージェントワークフロー向けには請求書処理・フォーム入力・コンプライアンスチェックに必要な構造的プリミティブを提供します。また、Search Toolkit(オープンソースの検索フレームワーク)との統合により、RAGや企業内検索のパイプラインに直接組み込める設計になっているとのことです。
一方で同社は「OCR 4は文書理解モデルであり意思決定者ではない」と明記し、医療診断・法的判断・高リスクな金融意思決定・安全クリティカルなシステムへの適用は対象外としています。利用目的の線引きを公式に示している点は、実装時の判断材料として参考になると思います。
価格とアクセス方法
OCR 4はAPIを通じてページ単価 $4/1,000ページ で利用でき、バッチAPIを使用すると50%割引の $2/1,000ページ になります。構造化JSONスキーマでの出力やカスタム指示に対応するDocument AI機能は $5/1,000ページ で提供されます。Mistral Studio・Amazon SageMaker・Microsoft Foundry経由でアクセスでき、Snowflake Parse Documentへの対応も近く予定されているとのことです。
APIとDocument AIは同一エンドポイントを共有しており、バウンディングボックスや信頼スコアを含む基本のOCR出力は常に取得できる設計です。構造化JSONスキーマやカスタムプロンプトによる解釈が必要な場合に限りDocument AIのパラメータを追加する形で、用途に応じてコストと機能のバランスを選べると思います。
まとめ
Mistral OCR 4は、テキスト抽出から構造化文書理解へという方向性を示したOCRモデルです。バウンディングボックスや信頼スコアの付与によりRAGや企業内検索のデータ基盤として実用性が高まっています。RAGの関連動向として、Googleのマルチエージェント型エンタープライズRAGの解説もあわせてご覧いただければと思います。