はじめに
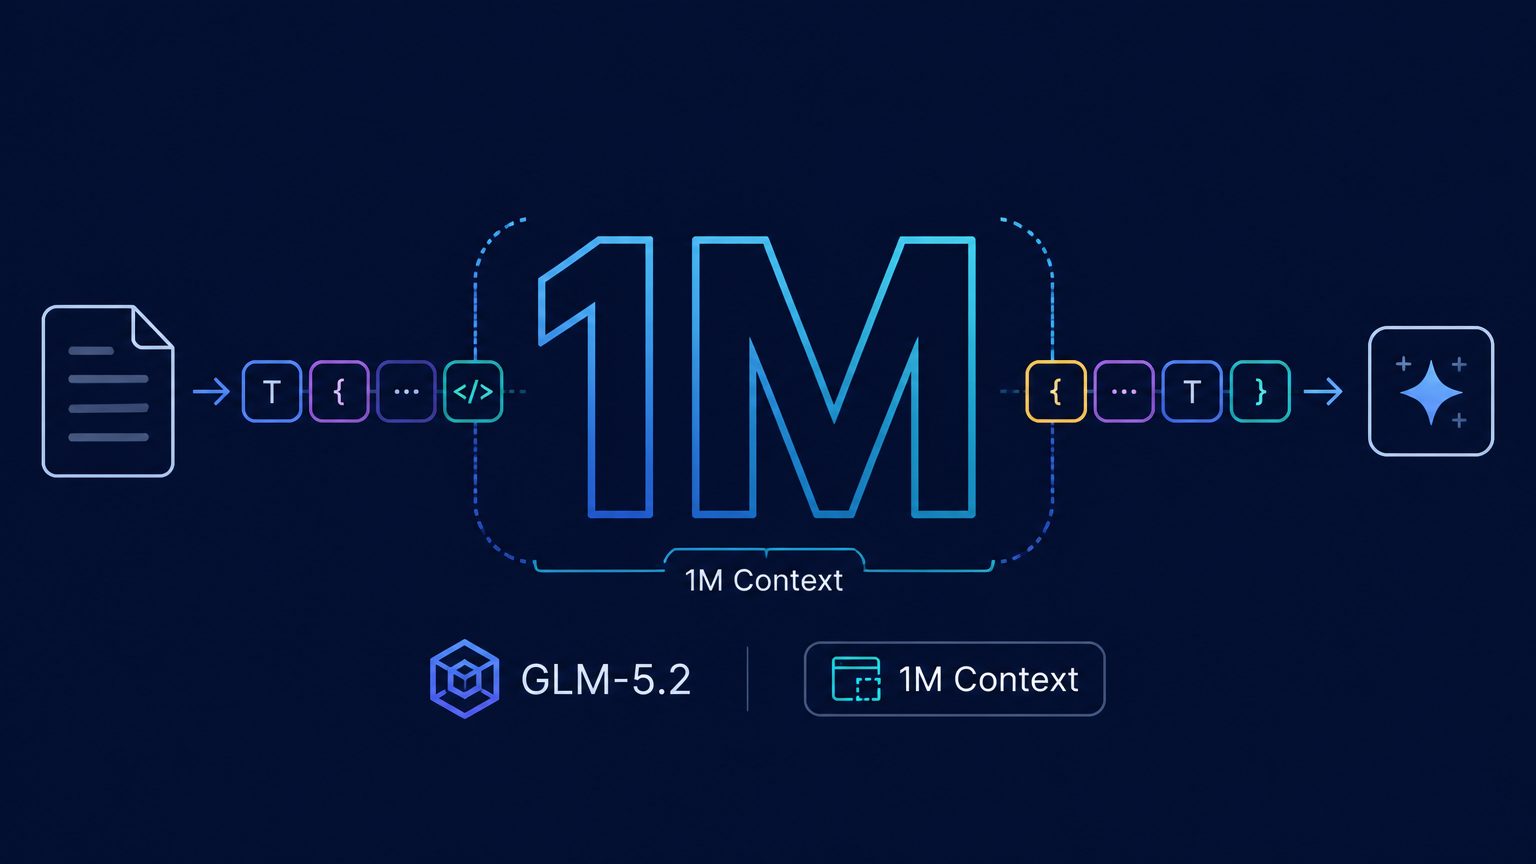
Z.aiが2026年6月16日、長期タスク対応フラッグシップモデル「GLM-5.2」をHugging FaceにてMITライセンスで公開しました。前モデルGLM-5.1からコンテキストウィンドウが大幅に拡張され、今回初めて100万トークンの安定稼働を実現しています。本稿では、その性能と新アーキテクチャの概要、ならびにローカル実行環境の構築手順を解説します。
参考記事
メイン記事:
- タイトル: GLM-5.2: Built for Long-Horizon Tasks
- 著者: GLM-5 Team
- 発行元: Hugging Face(zai-org)
- 発行日: 2026年6月16日
- URL: https://huggingface.co/zai-org/GLM-5.2
関連情報:
- タイトル: GLM-5.2 Built for Long-Horizon Tasks(ブログ)
- 発行元: Z.ai
- 発行日: 2026年6月16日
- URL: https://z.ai/blog/glm-5.2
関連記事
要点
- GLM-5.2はZ.aiが開発したオープンソースの大規模言語モデルで、MITライセンスのもとHugging Faceで一般公開されている
- コンテキストウィンドウ(一度に参照できるテキストの長さ)が前モデルGLM-5.1の200Kトークンから1Mトークン(100万トークン)へと拡張された
- 新アーキテクチャ「IndexShare」により、1Mコンテキスト時の1トークンあたりの計算量(FLOPs)を2.9倍削減している
- 長期コーディングタスクのベンチマークFrontierSWEでスコア74.4を記録し、オープンソースモデルとして最高性能を達成した
- SGLang、vLLM、HuggingFace Transformers、KTransformers、Unslothなど複数の推論フレームワークでローカル実行が可能である
詳細解説
GLM-5.2の概要と位置づけ
GLM-5.2は、中国のAI企業Z.ai(旧Zhipu AI)が開発したフラッグシップモデルの最新版です。Z.aiによれば、前モデルのGLM-5.1実装ガイドで解説したGLM-5.1から長期タスク能力を大きく向上させ、Hugging Faceの zai-org/GLM-5.2 リポジトリからMITライセンスで公開されています。
MITライセンス(MIT License)とは、商用利用・改変・再配布をほぼ無制限に認める最も緩やかなオープンソースライセンスのひとつです。地域制限なく利用できる「Pure Open」方針を明示しており、日本国内での研究・開発・業務活用においても制約なく使用できます。
今回の最大の変更点は、コンテキストウィンドウ(モデルが一度に受け付けられるテキストの長さ。会話履歴・コード・ドキュメントなどをすべて含む)の拡張です。GLM-5.1の200Kトークンから1M(100万)トークンへと5倍に広がりました。単に受け付けられるだけでなく、大規模コードベースの実装・自動リサーチ・複雑なデバッグといった「コーディングエージェント向け長期シナリオ」を想定した追加学習が行われており、長い入力でも品質が落ちにくい設計になっていると説明されています。
コーディング性能:オープンソースモデルとして最高水準を記録
Z.aiの発表によれば、GLM-5.2は長期タスク系と標準コーディング系の両方のベンチマーク(AIの性能を測る評価指標)で、オープンソースモデルとして最高性能を達成しました。
長期タスク系ベンチマーク:
| ベンチマーク | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 | GPT-5.5 |
| FrontierSWE(Dominance) | 74.4 | 30.5 | 75.1 | 72.6 |
| PostTrainBench | 34.3 | 20.1 | 37.2 | 28.4 |
| SWE-Marathon | 13.0 | 1.0 | 26.0 | 12.0 |
標準コーディングベンチマーク:
| ベンチマーク | GLM-5.2 | GLM-5.1 | Claude Opus 4.8 | GPT-5.5 |
| Terminal-Bench 2.1 | 81.0 | 63.5 | 85.0 | 84.0 |
| SWE-bench Pro | 62.1 | 58.4 | 69.2 | 58.6 |
| FrontierSWE | 74.4 | 30.5 | 75.1 | 72.6 |
特に注目されるのはFrontierSWEです。このベンチマークは、数時間〜数十時間規模の技術プロジェクト(システム最適化・大規模コード構築・応用ML研究など)をエージェントが完遂できるかを評価するもので、実務レベルの長期タスク能力を測る指標と位置づけられています。GLM-5.2のスコア74.4は、前モデルGLM-5.1の30.5から約2.4倍の大幅な向上であり、Claude Opus 4.8(75.1)にわずか1%差まで迫っています。
SWE-Marathonはコンパイラ構築・カーネル最適化・本番グレードのサービス開発など超長期タスクを対象としており、スコア13.0はClaude Opus 4.8(26.0)と差があります。一方でGPT-5.5(12.0)を上回り、オープンソースモデルの中では最高スコアを記録している点は注目に値すると考えられます。
新アーキテクチャ:IndexShareとMTPの改善
GLM-5.2では、1Mコンテキストを実用的に扱うための2つのアーキテクチャ上の工夫が導入されています。
① IndexShare(インデックスシェア)
IndexShareは、スパースアテンション(Sparse Attention、重要なトークンだけに絞って注意計算を行う技術)に使われるインデクサー(どのトークンに注目するかを決定する部品)を複数のアテンション層で共有する仕組みです。
従来のDSA(Dual Sparse Attention、二重スパースアテンション)では、各層が独立してインデクサーの計算を実行していました。IndexShareでは4層ごとに1つのインデクサーを共有することで、その計算を4分の1に削減しています。Z.aiによれば、この改良により 1Mコンテキスト時の1トークンあたりの計算量(FLOPs)が2.9倍削減 されます。
② MTP(Multi-Token Prediction)層の改善
MTP(マルチトークン予測)は、次のトークンを1つずつ逐次的に予測するのではなく、複数のトークンをまとめて予測する技術です。特に投機的デコーディング(Speculative Decoding、草稿モデルが先読みしてメインモデルが検証する高速化手法)と組み合わせることで、推論速度の向上に寄与します。
GLM-5.2ではMTP層にもIndexShareを適用し、さらにリジェクションサンプリングとエンドツーエンドのTV(Total Variation)損失関数を加えることで、受け入れ長(アクセプタンスレングス、1回の検証で承認されるトークン数)を 最大20%向上 させています。
思考量の制御(Effort Level)
GLM-5.2では、推論時に思考の深さ(Effort Level)を指定できます。難しいタスクには「Max」、速度重視なら「High」を選択することで、応答精度とレイテンシ(応答速度)を用途に応じて調整できます。
Z.aiのCoding Planを利用する場合は、APIリクエスト時のモデル名を “GLM-5.2” と指定します。1Mコンテキストを明示的に有効にしたい場合は “GLM-5.2[1m]” と指定できます。思考量の設定は https://docs.z.ai/guides/capabilities/thinking-mode のドキュメントで詳細が公開されています。
ローカル実行環境の構築
GLM-5.2のモデルウェイト(重みファイル)はHugging Faceから無料でダウンロードできます。ここでは対応フレームワークの概要と基本的なセットアップ手順を解説します。
前提条件の確認
ローカル実行前に以下を確認してください。
- Pythonのバージョン確認(3.10以上推奨):
# Pythonのバージョンを確認するコマンドです

python --version

# または

python3 --version- GPU環境(NVIDIA CUDA対応GPU)が推奨です。CPU推論を行う場合はKTransformers(後述)が有効です。
- 大型モデルのためGPU VRAMが不足する場合があります。VRAMの空き容量はNVIDIAのGPUであれば nvidia-smi コマンドで確認できます。
対応推論フレームワーク一覧:
| フレームワーク | 最低バージョン | 特徴 |
| SGLang | v0.5.13.post1+ | 高スループット・バッチ推論向け |
| vLLM | v0.23.0+ | API経由のサービング向け |
| Transformers | v0.5.12+ | HuggingFace標準ライブラリ、最も簡単 |
| KTransformers | v0.5.12+ | CPUオフロード対応、低VRAM環境向け |
| Unsloth | v0.1.47-beta+ | ファインチューニング・高速推論向け |
Ascend NPU(華為製AIアクセラレータ)環境では、vLLM-Ascend・xLLM・SGLangを通じた実行もサポートされています。
HuggingFace Transformersを使った基本セットアップ
以下のセットアップ手順は、最もアクセスしやすいTransformersライブラリを使った例です。参考記事のサンプルをもとにした筆者補足サンプルです。
ステップ1: 仮想環境の作成(推奨)
仮想環境(venv)は、プロジェクトごとにPythonパッケージを独立して管理するための仕組みです。異なるプロジェクトのパッケージが干渉するのを防ぐために使います。
# 仮想環境「glm52-env」を作成するコマンドです

python -m venv glm52-env

# 仮想環境を有効化します(Mac/Linux)

source glm52-env/bin/activate

# Windowsの場合はこちら

# glm52-env\Scripts\activate
ステップ2: 必要なパッケージのインストール
# Transformers(v0.5.12以上)とその依存パッケージをインストールします

pip install "transformers>=0.5.12" torch accelerate
注意: torch はPyTorch(ディープラーニングフレームワーク)です。CUDA(GPU用の計算環境)がインストールされている場合、GPU対応版のtorchが自動で選択されます。GPU環境のセットアップがうまくいかない場合は https://pytorch.org/get-started/locally/ でOS・バージョンに対応したインストールコマンドを確認してください。
ステップ3: モデルのロードと推論
# HuggingFaceからGLM-5.2をロードして推論するサンプルコードです

from transformers import AutoTokenizer, AutoModelForCausalLM

import torch

# モデルID: Hugging Face上の公開リポジトリを指定します

model_id = "zai-org/GLM-5.2"

# トークナイザーの読み込み(テキストをモデルが処理できる数値列に変換するツール)

tokenizer = AutoTokenizer.from_pretrained(model_id)

# モデルの読み込み

# torch_dtype=torch.float16 はGPUのVRAM消費量を半精度に下げる設定です

# device_map="auto" は利用可能なGPU/CPUに自動で配置する設定です

model = AutoModelForCausalLM.from_pretrained(

    model_id,

    torch_dtype=torch.float16,

    device_map="auto",

)

# プロンプトを準備してトークン化します

prompt = "Pythonで簡単なWebサーバーを実装してください。"

inputs = tokenizer(prompt, return_tensors="pt").to(model.device)

# テキストを生成します(max_new_tokens: 生成するトークンの最大数)

with torch.no_grad():

    outputs = model.generate(

        **inputs,

        max_new_tokens=512,

        do_sample=True,

        temperature=1.0,

    )

# 生成結果をテキストに戻して表示します

generated_text = tokenizer.decode(outputs[0], skip_special_tokens=True)

print(generated_text)
注意: GLM-5.2はフルサイズモデルのため、GPU VRAMが不足する場合は KTransformers を使ったCPUオフロード実行を検討してください。KTransformersの利用方法は公式チュートリアル(https://github.com/kvcache-ai/ktransformers)を参照してください。
SGLang・vLLMを使ったサービング構成
本番環境やAPIサーバーとして運用する場合は、SGLangまたはvLLMが適しています。各フレームワークの公式ドキュメントに詳細なガイドが用意されています。
- SGLang cookbook: https://cookbook.sglang.io/autoregressive/GLM/GLM-5.2
- vLLM recipes: https://recipes.vllm.ai/zai-org/GLM-5.2
- HuggingFace Transformers docs: https://github.com/huggingface/transformers/blob/main/docs/source/en/model_doc/glm_moe_dsa.md
Z.aiでのAPI・クラウド利用
ローカル環境を用意せずに試したい場合は、Z.aiのWebUI(https://chat.z.ai/)またはAPIを利用できます。Z.aiのCoding Planに加入すると、ZCode(デスクトップエージェント)・Claude Code・OpenCodeなど主要なコーディングエージェントからGLM-5.2を呼び出すことが可能です。APIドキュメントは https://docs.z.ai/guides/llm/glm-5.2 で公開されています。
また、中国向けのModelScope(https://modelscope.cn/models/ZhipuAI/GLM-5.2)でもモデルウェイトが公開されています。
まとめ
GLM-5.2は、1Mトークンコンテキストと新アーキテクチャIndexShareにより、オープンソースモデルとして初めて長期コーディングタスクでフロンティアモデルに肉薄する性能を示しました。MITライセンスで商用利用も可能なため、選択肢のひとつとして検討する価値があると思います。ローカル実行の詳細は各フレームワークの公式ドキュメントをあわせてご確認ください。