はじめに
Google ResearchとGoogle Cloudが共同で開発したエンタープライズ向けマルチエージェントRAGフレームワークが、2026年6月5日に発表されました。本稿では、複雑な業務クエリに対して自律的に検索を繰り返し、回答に必要な情報が揃うまで探索し続ける新しいアーキテクチャの仕組みと性能を解説します。
参考記事
- タイトル: Unlocking dependable responses with Gemini Enterprise Agent Platform’s Agentic RAG
- 著者: Cyrus Rashtchian(Research Scientist), Da-Cheng Juan(Engineering Manager), Google Research
- 発行元: Google Research Blog
- 発行日: 2026年6月5日
- URL: https://research.google/blog/unlocking-dependable-responses-with-gemini-enterprise-agent-platforms-agentic-rag/
関連記事
要点
- 従来の単一ステップRAGは、複数のデータソースをまたいだ複合クエリへの対応が苦手であり、情報が複数の「島」に分散している場合に不完全な回答を返しやすい
- Googleの新フレームワークは「十分な文脈エージェント(Sufficient Context Agent)」を核に据え、必要な情報が揃うまで検索を反復する設計である
- FactualityデータセットでバニラRAGと比較した際、精度が最大34%向上している
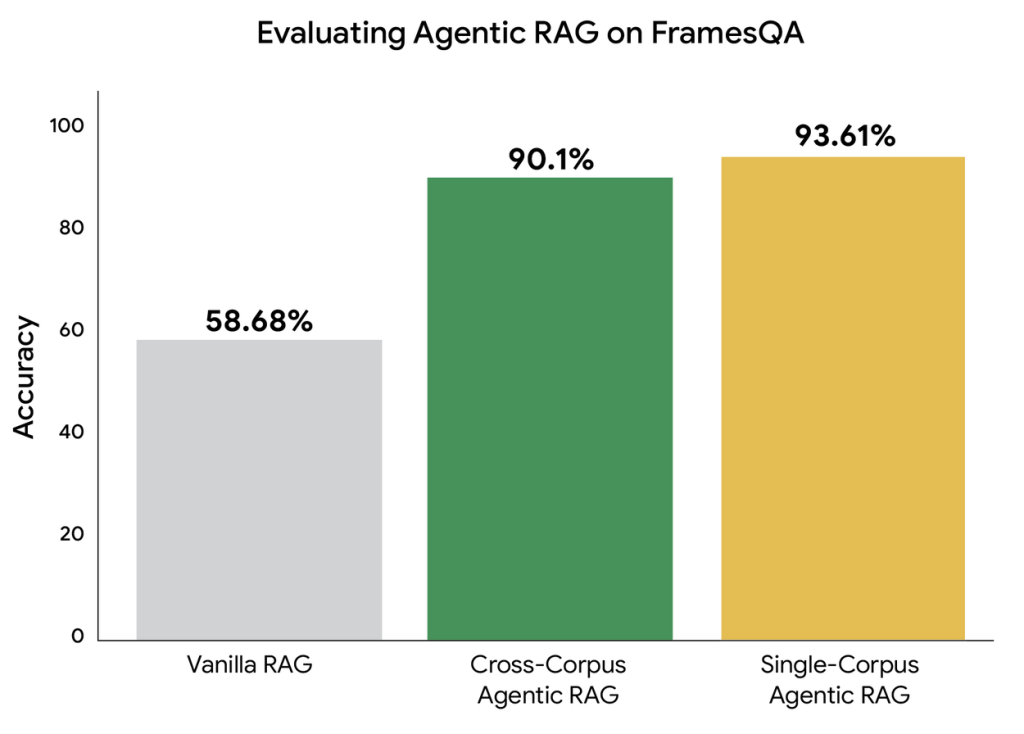
- FramesQAベンチマークの クロスコーパス設定 で90.1%の正解率を達成し、シングルコーパスとのレイテンシ差は平均3%以内に抑えられている
- Gemini Enterprise Agent Platformのパブリックプレビューとして現在利用可能である
詳細解説
従来のRAGが抱える「情報の孤島」問題
RAG(Retrieval-Augmented Generation)とは、LLM(大規模言語モデル)が回答を生成する前に、外部データベースから関連情報を検索して文脈として与える技術です。近年のビジネスシステムでは複数のデータベースや文書管理システムが並立しており、1つのクエリに答えるために複数のソースをまたいだ検索が必要になるケースが増えています。
Google Researchの発表によれば、従来の「バニラRAG」では「Project Xで使用したサーバーのスペックは?」というクエリを例にした場合、最初の検索でProject Xに関する文書は見つかってもサーバーIDしか記載されておらず、そのIDをもとに別のデータベースを再検索する動作は自動では行われません。結果として「情報が見つかりません」という不完全な回答が返ることになります。
マルチエージェント構成の役割分担
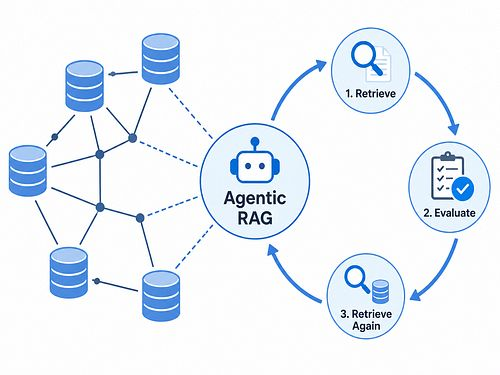
新フレームワークでは、複数のエージェントがそれぞれの役割を分担します。オーケストレーターがクエリ全体を評価してサブエージェントに委譲し、プランナーエージェントが必要な情報の探索経路を設計します。クエリリライターは「Project Xの状況は?」のような曖昧な質問を「Project X Q3ステータスレポート」「Project Xチームの主要な阻害要因」といった複数の検索クエリに変換します。サーチファンアウトエージェントがそれらのクエリを複数の検索ソースに並列投入し、収集した情報を最終的にLLMが統合して回答を生成します。
このような分業構造自体は他のマルチエージェントRAGフレームワークにも見られますが、Googleの新フレームワークが他と異なる点は「十分な文脈エージェント」の存在です。
「十分な文脈エージェント」による品質チェックと反復検索
十分な文脈エージェント(Sufficient Context Agent)は、回答生成前に「本当に必要な情報が揃っているか」を検証する品質管理の役割を担います。Google Researchの発表では、このエージェントが3つの観点から評価を行うと説明されています。
第1に、RAGエージェントが取得した実際のテキストスニペットを読み込み、クエリへの回答に必要な情報が含まれているかを確認します。第2に、システムが作成した「粗削りな下書き回答」と、検索で取得したスニペットを照合し、下書きが質問の全要素をカバーしているかを評価します。第3に、何が不足しているかを具体的に特定します。単に「情報が不足している」と示すだけでなく、「薬と食事制限の情報は取得できたが、入院中のアレルギー反応に関する情報が欠けている」のように、次の検索に向けた具体的なフィードバックを生成します。
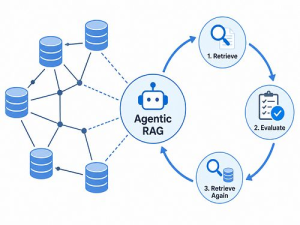
このフィードバックをもとにクエリリライターが新たな検索クエリを生成し、RAGエージェントが追加検索を実行します。必要な情報が揃うまでこのサイクルが繰り返され、十分な文脈エージェントが「回答可能」と判断した段階で最終的な合成回答が生成されます。
従来のRAGが1回の検索で回答を生成しようとするのに対し、このフレームワークは検索→評価→再検索というループを自律的に繰り返す点が根本的な違いだと言えます。
性能評価:FramesQAベンチマークの結果
Google Researchによれば、評価にはFramesQAを使用しました。FramesQAは824件のマルチホップ(複数ステップの推論を要する)クエリと、2,676件のPDF文書から構成されるベンチマークです。マルチホップとは、例えば「2024年6月時点で最も視聴された2つのテレビシーズンフィナーレはどちらが長く、どれだけ差があるか?」のように、複数の事実を段階的に調べて推論する必要があるクエリを指します。
比較は3条件で実施されました。バニラRAG(Google RAG Engine使用)、アジェンティックRAGのシングルコーパス設定(FramesQA文書のみ)、そしてクロスコーパス設定(FramesQA文書に加えて3つの無関係なデータセットを混在させた状態)です。クロスコーパス設定は、企業内で異なるチームが管理する複数のデータベースが存在する現実のユースケースを模擬しています。
結果として、バニラRAGと比較してファクチュアリティデータセットでの精度が最大34%向上しました。また、クロスコーパス設定でも90.1%の正解率を達成し、シングルコーパス設定との差はほぼなく、レイテンシの差も平均3%以内にとどまったとされています。企業のシステム設計においてレイテンシは重要な考慮点であり、精度向上と処理速度のバランスが保たれている点は実用上の強みと考えられます。
利用方法と現状
このフレームワークはGemini Enterprise Agent Platformのクロスコーパス検索機能として、現在パブリックプレビューとして提供されています。パブリックプレビューとは、正式リリース前の機能を一般ユーザーが試用できる段階を指します。Google Cloud上でのエンタープライズ利用を前提とした構成となっており、社内に複数のデータベースや文書管理システムを抱える企業が主な想定ユーザーだと思います。
まとめ
Googleのアジェンティックフレームワークが示すのは、「1回の検索で答えられない問いに、どう粘り強く向き合うか」というRAGの本質的な課題への一つのアプローチです。十分な文脈エージェントによる反復検索の仕組みが企業の業務システムでどこまで機能するか、今後の実運用事例が注目されます。RAGの基礎的な仕組みについては、過去記事でも複数のアプローチをまとめていますので、あわせてご覧いただければと思います。