はじめに
OpenAIが2026年6月30日、自社データインフラ「Rockset」で発生した原因不明のC++クラッシュを解明した技術ブログを公開しました。本稿では、ハードウェア障害と18年前から存在したライブラリのバグという2つの無関係な原因を「疫学的アプローチ」で分離・特定した調査の過程を解説します。
参考記事
- タイトル: Core dump epidemiology: fixing an 18-year-old bug
- 著者: OpenAI Engineering
- 発行元: OpenAI
- 発行日: 2026年6月30日
- URL: https://openai.com/index/core-dump-epidemiology-data-infrastructure-bug/
要点
- OpenAIのRocksetサービスで発生していた不可解なC++クラッシュは、ハードウェア障害とGNU libunwindのレースコンディションという2つの無関係なバグが混在していた
- 個別のコアダンプ解析(「医師モード」)では解明できなかった問題が、全クラッシュの集団データを整備・分析する「疫学モード」に切り替えることで構造が明確になった
- GNU libunwindの18年前から存在するバグは、例外アンワインド中にわずか1命令の間にシグナルが割り込むというナノ秒スケールの競合で発生する
- 修正策はlibgccのアンワインダーへの切り替えと、GNU libunwindへのパッチのアップストリーム提供の両方で対処した
- 高品質な集団データの整備が、「不可能に見える問題」を「診断可能な問題」に変える最重要ステップである
詳細解説
問題の発端——Rocksetで起きた不可解なクラッシュ
OpenAIのChatGPTデータインフラの一部であるRockset(同社が2024年に買収したクラウドネイティブな検索・リアルタイム分析システム)のC++実行レイヤーで、数ヶ月前から奇妙なクラッシュが続発しました。
通常のC++関数が正常に終了したはずなのに、その後「でたらめなアドレス」にリターンしてしまい、カーネルがプログラムを停止させるというものです。具体的には、スタックフレーム(関数の実行中に使われるメモリ領域)内の「リターンアドレス」がNULL(何もない場所を指すアドレス)になっているケースと、スタックポインタ(%rsp)と呼ばれるCPUレジスタの値が8バイトずれているケースが観察されました。
スタックポインタが通常のコードで8バイト変化するのは極めて異常です。通常コンパイラは、関数の入口(プロローグ)と出口(エピローグ)以外でこのレジスタを直接変更しないためです。考えられる原因をすべて検討しましたが、どの仮説にも強い反証がありました。
最初のアプローチとその限界——「医師モード」での個別診断
最初の調査では、いくつかのコアダンプ(クラッシュ時のプログラム状態のスナップショット)を詳細に調べる「医師モード」を取りました。コアダンプを使うと、クラッシュ時のレジスタ値やスタックの内容を検査できます。
Rocksetは -fno-omit-frame-pointer(デバッグ情報を残すコンパイルオプション)でビルドされているため、フレームポインタ(%rbp)を辿ることでコールスタックを再構築できます。また、Linux x86_64のABI(アプリケーション・バイナリ・インターフェース)では、スタックポインタより128バイト下の「レッドゾーン」と呼ばれる領域が保護されており、シグナルハンドラが上書きしない保証があります。この保護領域のおかげで、クラッシュ後もわずかな情報を読み取ることができました。
しかしこの方法には限界がありました。ログを使って全クラッシュを自動検出しようとしても、スタック自体が壊れているため偽陽性・偽陰性が多発し、信頼できるデータセットを構築できなかったのです。さらに、複数のリージョン・複数のハードウェアにまたがってクラッシュが発生していたため、この段階でハードウェア障害の可能性を(誤って)除外してしまいました。
転換点——「疫学モード」への切り替え
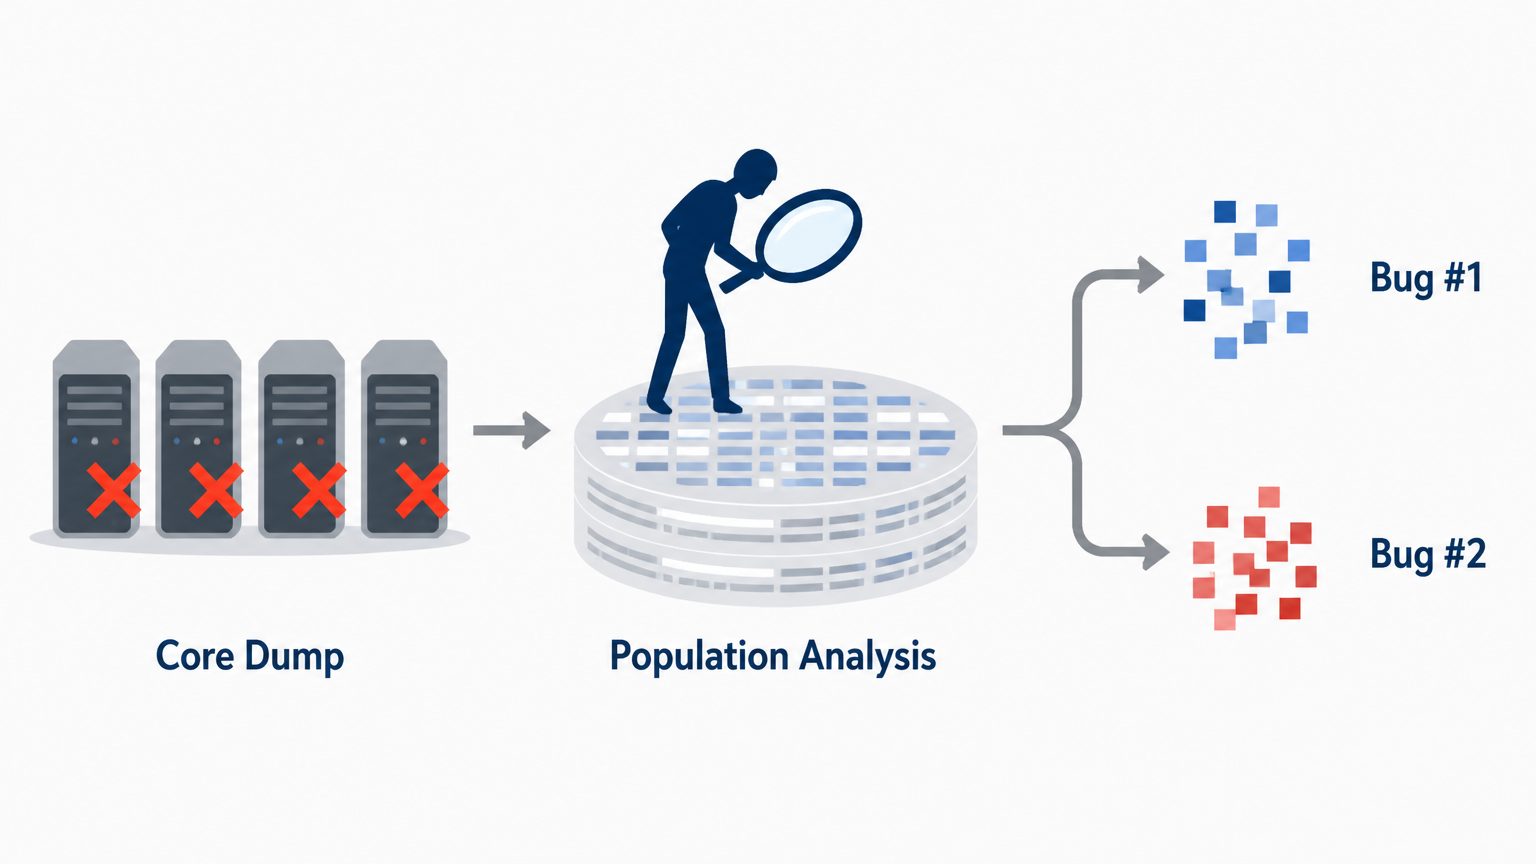
ブログのタイトルにもある「疫学」という比喩は、この調査の核心を表しています。医師が個々の患者を丁寧に診察するように個別のコアダンプを深掘りするのではなく、疫学者が集団レベルのパターンを分析するように、過去1年分のすべての本番コアダンプを自動解析するパイプラインを構築しました。
ChatGPTを使って、各コアファイルの先頭を取得してレジスタを抽出し、ログと照合して既知の偽陽性を除外し、クラッシュを「return-to-null(NULLへのリターン)」「misaligned-stack(スタック不整合)」「その他」に自動分類するスクリプトを作成しました。
このアプローチが転換点となりました。高品質な集団データを整備した瞬間、2つのクラッシュ集団が明確に分離されたのです。
- misaligned-stackクラッシュ:特定の1リージョンに集中し、明確な開始日があり、長時間稼働しているノードでは発生しない
- return-to-nullクラッシュ:複数のリージョンに分散し、開始日が曖昧で、最近頻度が上昇している
1つだと思っていた問題が、実は2つの無関係なバグだったのです。
バグ1——ハードウェアの不良ホスト
クリーンなデータセットにより、misaligned-stackクラッシュを特定の物理ホストまで追跡できました。そのホストをデニーリスト(利用禁止リスト)に追加したところ、この種のクラッシュは消滅しました。
CPUが演算を正しく実行しないという「サイレントハードウェア障害」はまれですが実在します。OpenAIはこの経験から、致命的シグナルハンドラにレジスタ状態を記録する機能を追加し、仮想マシンのライフサイクル管理を改善することで、同様の問題が再発しても即座に検出できる体制を整えました。
バグ2——GNU libunwindの18年前のレースコンディション
ハードウェア障害を分離したことで、残るreturn-to-nullクラッシュの分析が大幅に進みました。以前に「反証」として使っていたケースが実はすべて不良ハードウェアによるものだったと気づき、残りのクラッシュが C++例外のアンワインド(スタック巻き戻し)中に発生していた という事実が浮かび上がりました。
C++例外処理の仕組み
C++でthrow文が実行されると、ランタイムが以下の処理を行います。
- スタック上の関数フレームを検索して、対応するcatchブロックやデストラクタを探す
- 中間のスタックフレームを巻き戻す(アンワインド)
- catchブロックへ制御を移す
この処理は通常の関数呼び出しと戻りとは根本的に異なり、longjmp や setcontext に近い「動的な制御フロー変更」です。OpenAIのRocksetバイナリは、この処理のためにGNU libunwindを動的リンクで使用していました(libgccの実装より優先して選択されていました)。
問題のアセンブリコード
GNU libunwindの _Ux86_64_setcontext 関数の末尾6命令が問題の核心です。
74:    mov    UC_MCONTEXT_GREGS_RSP(%rdi),%rsp  ; %rspを新しい値に更新(レースウィンドウ開始)

75:

76:    /* push the return address on the stack */

77:    mov    UC_MCONTEXT_GREGS_RIP(%rdi),%rcx  ; ←ここが危険地帯

78:    push   %rcx

79:

80:    mov    UC_MCONTEXT_GREGS_RCX(%rdi),%rcx

81:    mov    UC_MCONTEXT_GREGS_RDI(%rdi),%rdi

82:    retq
%rdi は スタック上に確保された ucontext_t(レジスタ状態を保存する構造体)へのポインタです。74行目で %rsp を新しい値に更新した瞬間、%rdi が指す構造体は「アクティブなスタック」の外に出ます。
Linuxカーネルはシグナル(割り込み処理)を配信する際、%rsp-128 を起点にシグナルフレームを構築します。%rsp が更新された後、次の命令(77行目)が実行される前 というわずか1命令の間にシグナルが届くと、カーネルのシグナルフレームが %rdi の指す構造体を上書きし、リターン先のアドレス(%rip)がNULLに化けます。
なぜ今まで発覚しなかったのか
GNU libunwindのこのバグは18年以上前から存在していましたが、以下の3つの条件が重なったことで初めて実用レベルで顕在化しました。
- 例外発生頻度:RocksetはバックプレッシャーCP制御(過負荷時のフロー制御)に例外を多用しており、ピーク時は毎秒10,000回以上投げる
- シグナル配信頻度:OpenAI独自の coarse_thread_cputime_clock(CPUタイム計測の近似実装)が数ミリ秒ごとにSIGUSR2を送信
- シグナルハンドラのスタック使用量:今年初めに timer_getoverrun の呼び出しを追加したことでハンドラのスタック消費が増え、stale(古い)な ucontext_t 領域に届くようになった
フェルミ推定によれば、レースウィンドウは約100ピコ秒(10^-10秒)、SIGUSR2は10ミリ秒ごとに届くため、例外アンワインド1回あたりの競合確率は約10^-8。毎秒10,000回例外を投げるホストでは、数時間に1回クラッシュする計算になり、実際の観測頻度と一致します。
修正の内容
OpenAIは即時対応としてGNU libunwindからlibgccのアンワインダーへ切り替えました。libgccの実装はロック競合の低減に多くの改善が施されており、大規模VMでのスケーリングにも有利です。
また、再現環境と修正パッチをGNU libunwindのアップストリームに提供し、マージ済みとなっています。他のアンワインダーに同様の問題がないことも確認済みです。
教訓——高品質な集団データが「不可能な問題」を解く
このデバッグから得られた最大の教訓は、巧みなアセンブリ解読でも深い低レベル知識でもなく、高品質なデータセットの構築 だったとOpenAIは述べています。
2つの無関係なバグが混在していたため、個別の詳細分析ではどちらの仮説にも反証が生まれ、思考が行き詰まっていました。集団データを整備した瞬間に問題の構造が自明になり、あとは各クラスターを個別に解決するだけでした。
この考え方は疫学(感染症の集団的パターン分析)の手法に近く、インフラ信頼性の問題においても同様のアプローチが有効だと考えられます。詳細なインストルメンテーション(計測・記録の仕組み)、自動化された調査パイプライン、そして継続的な運用ツールの改善が、「再現不可能に見えるバグ」を「診断可能な問題」に変える鍵だと思います。
まとめ
OpenAIは、Rocksetで発生した不可解なC++クラッシュを、集団レベルのコアダンプ分析(「疫学的アプローチ」)によって解明しました。問題は「不良ハードウェアによるサイレント演算誤り」と「GNU libunwindの18年来のレースコンディション」という2つの無関係なバグで構成されていました。個別ケースの深掘りより、全クラッシュの高品質データ整備が突破口になったという点は、大規模インフラのデバッグに携わるエンジニアにとって参考になる事例だと思います。