はじめに
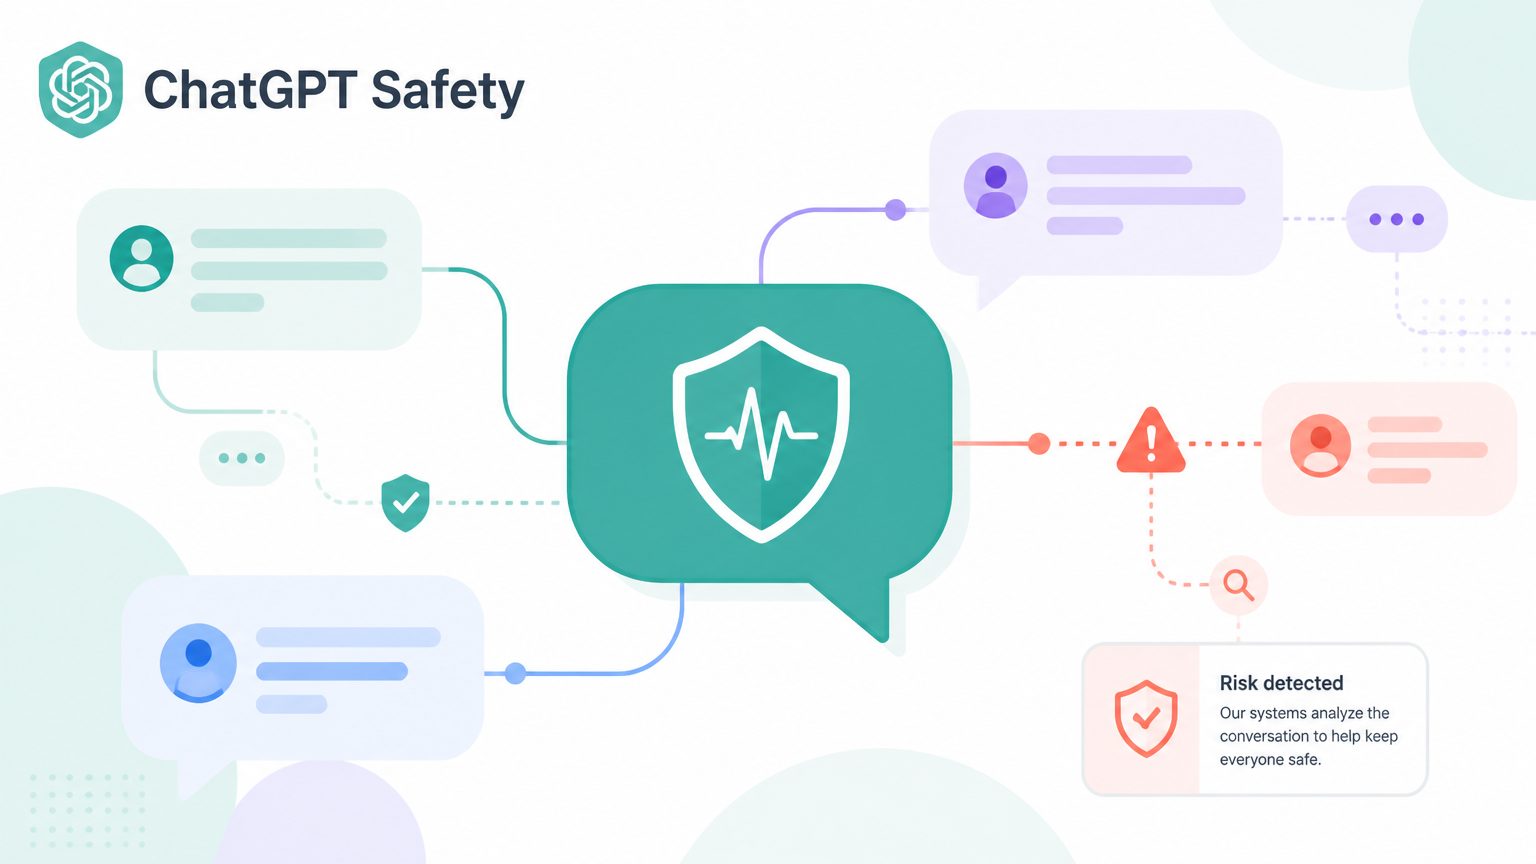
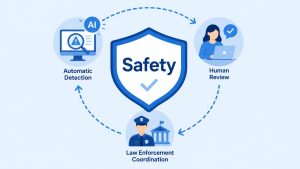
OpenAIが2026年5月14日、ChatGPTの安全性アップデートに関する詳細を公表しました。今回の更新では、単一メッセージだけでなく会話全体の流れや複数の会話をまたいだ文脈から危機サインを検出する仕組みが導入されています。本稿では、その技術的な仕組みと内部評価の結果を解説します。
参考記事
- タイトル: Helping ChatGPT better recognize context in sensitive conversations
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年5月14日
- URL: https://openai.com/index/chatgpt-recognize-context-in-sensitive-conversations/
関連記事
要点
- ChatGPTは会話の流れや複数の会話をまたいだ文脈から、自傷・自殺・他者への危害に関する危険サインを検出できるようになった
- 「セーフティサマリー」と呼ばれる安全関連の短い要約メモを保持し、後続の会話でリスク判断に活用する仕組みが新たに導入された
- 内部評価において、長い単一会話シナリオでの安全応答率が自殺・自傷ケースで50%、他者危害ケースで16%それぞれ向上した
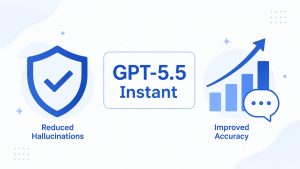
- GPT-5.5 Instantでは、複数会話シナリオで他者危害ケースの安全応答率が52%、自殺・自傷ケースで39%改善した
- 精神科医・心理士を含む専門家ネットワーク(Global Physicians Network)との2年以上にわたる協力のもと開発された
詳細解説
文脈を読む安全機能とは
ChatGPTへの問い合わせは日々数億件に上りますが、その中には苦悩や危機的状況を抱えた利用者との会話も含まれます。OpenAIによれば、センシティブな会話においては、1つのメッセージだけを見ると普通の質問に思えても、それ以前のやり取りと組み合わせると全く異なる意味を持つことがあるといいます。
今回のアップデートはこの「文脈の積み重ね」に対応するためのものです。対象となる高リスクシナリオは、自殺・自傷・他者への危害の3種類に絞られており、AIが段階的に高まるリスクシグナルを検知した際に、危険な情報の提供を拒否したり、危機支援リソースへの誘導やトーンダウンを図ったりできるよう訓練されています。OpenAIが強調するのは、こうした高リスクの場面はあくまで例外的であり、日常の膨大な会話に干渉しない設計を維持することだと思います。
複数会話をまたぐ「セーフティサマリー」
安全上の懸念が複数の独立した会話にまたがって現れるケースに対応するため、OpenAIは「セーフティサマリー(safety summaries)」という仕組みを導入しました。これは、過去の会話で検知された安全上の関連情報を短い事実メモとして保持し、後続の会話でリスク判断に活用するものです。
重要なのは、この仕組みが個人化や長期的なメモリとして使われるものではないという点です。OpenAIによれば、セーフティサマリーは深刻な安全リスクが想定される場面に限って作成され、保持期間も限定されており、一般的なパーソナライゼーションには使用されないとされています。4,000件超の評価では、安全関連性スコアが5点満点で4.93、事実正確性スコアが4.34という結果が報告されており、精度と正確性の両面で高い水準が示されています。また、この仕組みを加えても通常の会話の品質に有意な差は見られなかったと、内部テストの結果が示されています。
プライバシーとのバランスという観点では、保持期間の限定や用途の絞り込みがどの程度実効的かは、今後の運用を見守る必要があると考えられます。
精神科・心理士専門家との共同開発
今回のアップデートは、OpenAIの「Global Physicians Network」に参加する精神科医や心理士(法医学心理学・自殺防止・自傷専門)との2年以上にわたる協力をもとに開発されました。専門家たちは、セーフティサマリーをどのような場合に作成すべきか、どの範囲の文脈が関連するか、どの程度の期間にわたってモデルが文脈を考慮すべきかといった判断基準の策定に関与したとされています。
実臨床の知見を取り込んだ設計は、単純なキーワード検知とは一線を画すアプローチだと思います。一方で、AIが「文脈から意図を推定する」ことへの誤検知リスクや、利用者が監視されているという感覚を持つ可能性については、引き続き注視が必要な課題だと考えられます。
評価結果と今後の展開
OpenAIが公表した内部評価によれば、長い単一会話でのシナリオにおいて、自殺・自傷ケースの安全応答率が50%向上、他者危害ケースで16%向上しました。現在ChatGPTのデフォルトモデルとなっているGPT-5.5 Instantでは、複数会話シナリオで他者危害ケース52%・自殺自傷ケース39%の改善が確認されています。
今後は、自傷・他者危害以外の高リスク領域(生物学・サイバー安全など)への応用も検討するとされていますが、慎重なセーフガードを前提とした段階的な取り組みになる見通しです。
まとめ
今回のアップデートは、AIが「今この一文」だけでなく会話全体の流れを読んで安全に対応しようとする取り組みです。セーフティサマリーというメモ機能がプライバシーとのバランスをどう保つか、今後の運用が注目されます。AIの危機対応能力を複数モデルで比較した評価に興味のある方は、28モデルの安全性比較を取り上げた記事もあわせてご覧いただければと思います。