はじめに
マルチモーダルAIは画像・音声・テキストを横断して処理できますが、ひとつの入力への小さな細工が別の出力に影響を及ぼす「クロスドメイン敵対的転移」というリスクも抱えています。本稿では、IBMが2026年6月19日に公開した記事をもとに、この脅威の仕組みと対策について解説します。
参考記事
- タイトル: Hidden vulnerabilities in multi-modal AI: A cross-domain perspective
- 著者: Swathi R
- 発行元: IBM(IBM Think)
- 発行日: 2026年6月19日
- URL: https://www.ibm.com/think/insights/hidden-vulnerabilities-multi-modal-ai
関連記事
要点
- マルチモーダルAIは画像・音声・テキストなど異なる種類のデータを共通の表現空間(embedding space)に変換することで、統合的な理解を実現している
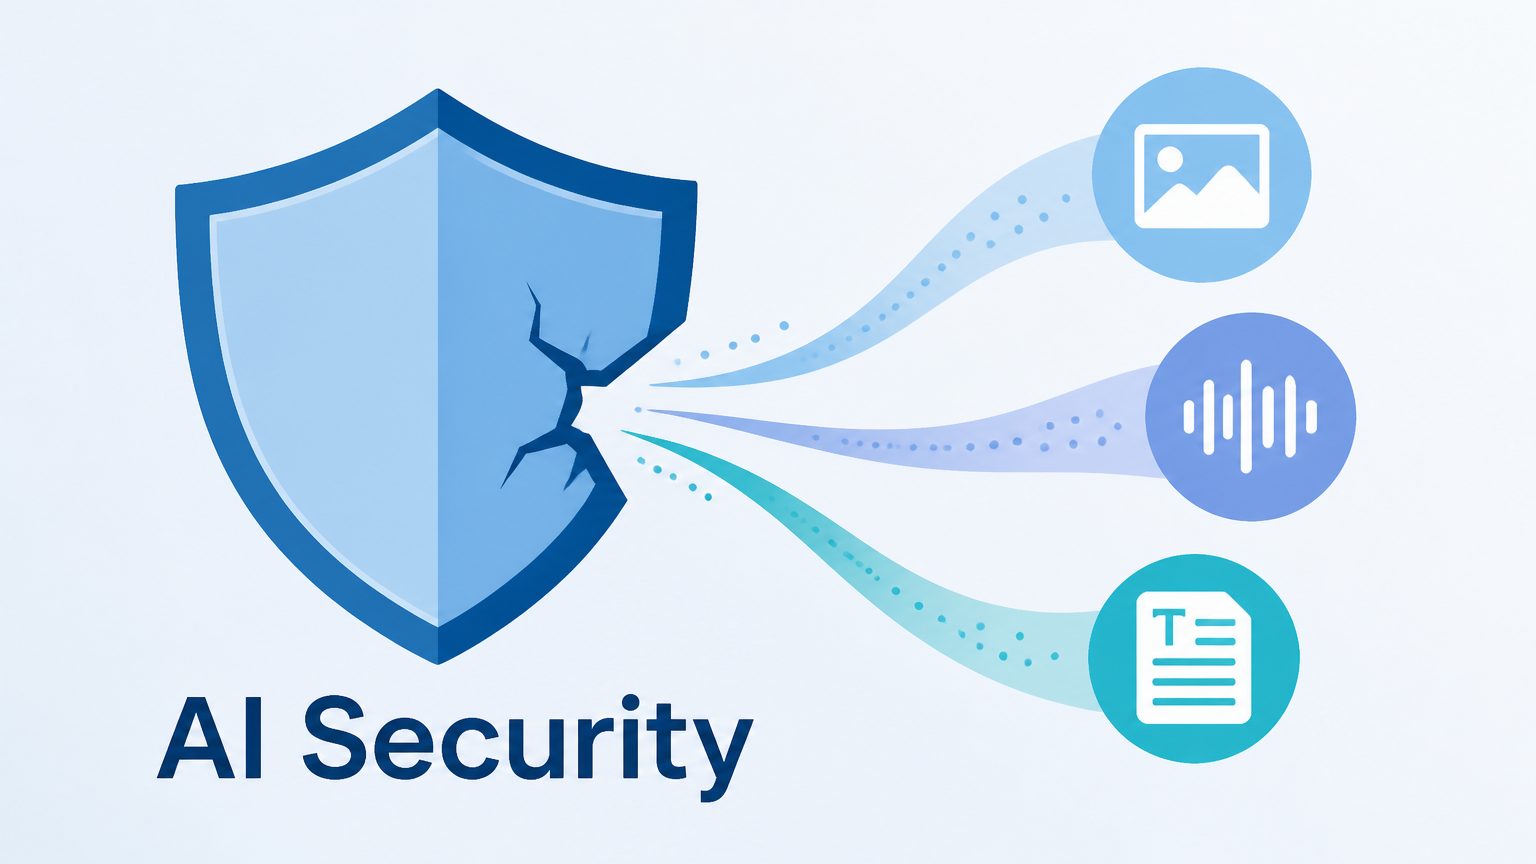
- 一方のモダリティに加えた微小な改変が、別のモダリティの出力に影響を及ぼす「クロスドメイン敵対的転移」と呼ばれる攻撃が存在する
- 自動運転車の標識誤認識、画像キャプションの誤生成、生成AIの安全フィルター回避、音声の誤変換など、実際の事例が複数報告されている
- 攻撃の発生源と影響箇所が異なるモダリティにまたがるため、従来の単一ドメイン向けセキュリティツールでは検出が難しい
- 対策として、複数モダリティを横断した敵対的サンプルでの学習、入力検証、モダリティ間の分離設計、説明可能性ツールの活用などが挙げられている
詳細解説
マルチモーダルAIを支える「共通表現空間」という仕組み
IBMの記事によれば、マルチモーダルAIは画像を見て文章で説明したり、音声を意味のある指示に変換したりと、異なる種類のデータをひとつの理解として結びつける仕組みを持っています。これを可能にしているのが、すべての入力を 共通表現空間(common representation space) と呼ばれる同じ空間にマッピングする手法です。
共通表現空間は、形式の異なるデータ間の関係性をモデルが理解できるようにする一方で、攻撃がドメインを越えて広がる単一の経路にもなり得ます。テキスト・画像・音声をひとつの空間で扱う設計そのものが、利便性とリスクの両面を併せ持っていると言えます。
「クロスドメイン敵対的転移」とは何か
敵対的攻撃(adversarial attack)とは、人間には気づかれない程度の微小な改変を入力に加え、AIの判断を誤らせる手法です。たとえば画像をわずかに加工するだけで、AIモデルがまったく異なる分類結果を出してしまうケースが知られています。
マルチモーダルシステムでは、この影響がひとつのデータ形式にとどまりません。IBMの記事では、改変された画像が誤ったテキスト出力を引き起こしたり、悪意のあるテキストプロンプトが有害な画像を生成させたりする現象が「クロスドメイン敵対的転移」と呼ばれています。すべてのデータ形式がモデル内部で相互に結びついているため、ひとつの入力への小さな変更が別ドメインの出力に影響を及ぼすという仕組みです。
なお、安全装置を回避する攻撃という観点では、「詩的」な文体に言い換えるだけで安全ガードレールを突破できるという報告もあり、入力の見た目を変えるだけでモデルの判断を揺るがす手法は、モダリティを問わず研究が進んでいる分野だと思います。
確認されている実際の事例
IBMの記事では、現実に起きている影響としていくつかの事例が紹介されています。研究者らは、道路標識に小さなステッカーを貼るだけで自動運転車のAIが標識を誤認識することを示しました。また、画像をわずかに加工するだけで、画像キャプショニングモデル(画像から説明文を生成するモデル)が誤った説明文を生成するケースも確認されています。
生成AIの分野では、巧妙に作られたテキストプロンプトによって安全フィルターを回避し、意図しない出力を引き出す手法も報告されています。音声システムにおいても、人間には気づきにくい微小なノイズによって誤った文字起こしや意図しないコマンドの実行が引き起こされる例があるとされています。
なぜ検出が難しいのか
クロスドメイン攻撃が厄介なのは、攻撃の発生源と影響箇所が異なるモダリティにまたがる点にあります。画像に仕込まれた問題がテキスト出力にしか現れない場合、原因を追跡することは容易ではありません。さらに、既存のセキュリティツールの多くは単一ドメイン向けに設計されており、クロスモーダルな脅威を効果的に検出できない場合があるとIBMの記事は指摘しています。
加えて、攻撃者がモデルへの完全なアクセス権を持たない場合でも、ブラックボックス攻撃と呼ばれる手法を使えば結果を操作できるとされており、標準化された検証フレームワークが整っていないことも検出の難しさに拍車をかけていると考えられます。
安全なマルチモーダルAIに向けた対策
IBMの記事は、リスクを抑えるための実践的な取り組みも紹介しています。複数のモダリティにまたがる敵対的サンプルを用いたモデルの学習、処理前に怪しいデータを除外する入力検証、モダリティ間の分離を高めたモデル設計、入力と出力の不整合を監視する仕組み、そして説明可能性ツールの活用などが挙げられています。
こうした対策は、医療・金融・自動運転・サイバーセキュリティなど、AIの自律的な判断が重要な意味を持つ領域ほど優先度が高いと考えられます。特にAI導入を検討する企業にとっては、性能だけでなく、モダリティを横断したリスクをどう評価するかも導入判断の材料になると思います。
まとめ
マルチモーダルAIは複数のデータ形式を統合できる高い利便性を持つ一方、クロスドメイン敵対的転移という見えにくいリスクも抱えています。AIエージェントが介在する場面では、間接的なプロンプトインジェクションのリスクも合わせて押さえておきたいところです。