はじめに
Google Researchは2026年3月16日、高温超電導という専門性の高い物理学分野を題材に、6種のLLMの回答品質を専門家が採点した研究論文を公開しました。本稿では、その評価手法と結果、今後の示唆について解説します。
参考記事
- タイトル: Testing LLMs on superconductivity research questions
- 著者: Subhashini Venugopalan、Eun-ah Kim
- 発行元: Google Research Blog
- 発行日: 2026年3月16日
- URL: https://research.google/blog/testing-llms-on-superconductivity-research-questions/
要点
- Google Researchとコーネル大学の共同研究として、GPT-4o・Perplexity・Claude 3.5・Gemini Advanced Pro 1.5・NotebookLM・カスタムRAGシステムの6種を高温超電導に関する専門的な設問で評価した
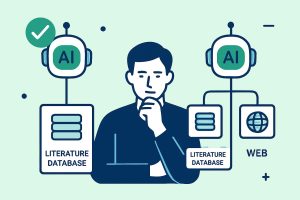
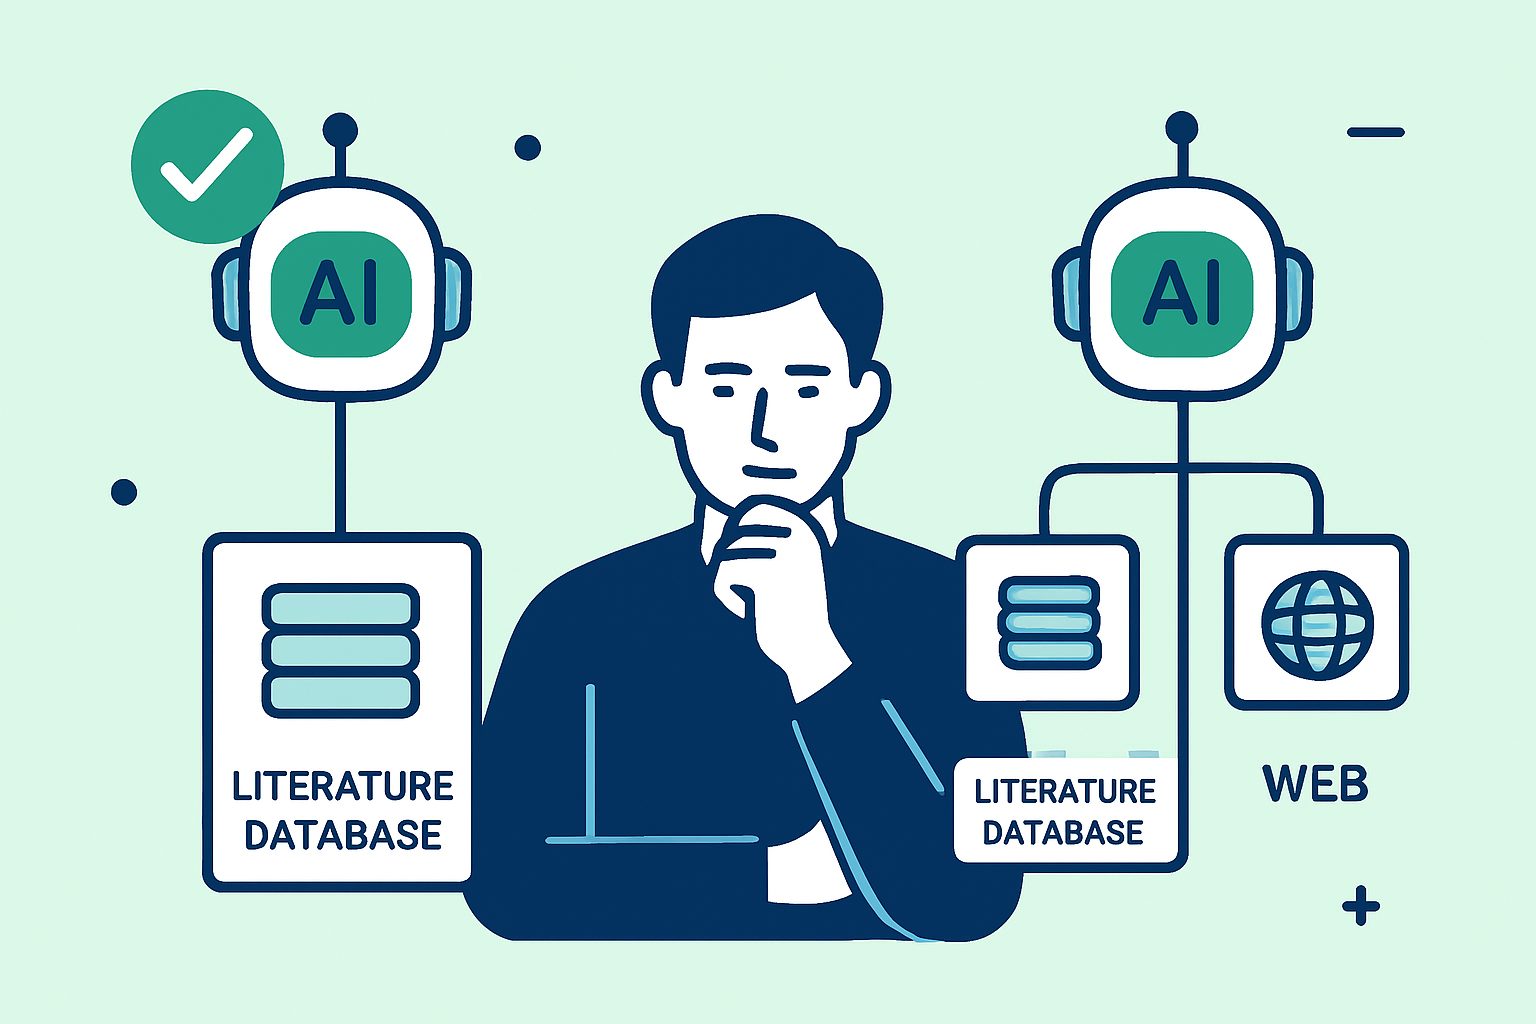
- 専門家が選定した査読済み文献のみを参照する「閉じたシステム」(NotebookLMとカスタムRAG)が、ウェブ全体にアクセスする4モデルより高い評価を得た
- ウェブベースのモデルは確立された理論と高度に推測的な仮説を混同する傾向が観察された
- 時系列・文脈理解の弱さや論文中の表・画像の解釈が、いずれのLLMにも共通する課題として確認された
- 結果は米国科学アカデミー紀要(PNAS)に掲載され、信頼性の高いAI研究ツールの開発に向けた指針を示している
詳細解説
研究の背景と目的
AIはメールの作成・画像編集・情報要約といった用途では広く活用されていますが、専門的な科学分野において高い精度と包括性を持って回答できるかどうかは、いまだ研究が進んでいる段階です。特に、複数の競合する理論が並立し、数千本にのぼる論文が蓄積されている分野では、情報の正確な取捨選択が求められます。
今回の研究は、Google ResearchとコーネルDot大学の共同チームが凝縮系物理学(condensed matter physics)の難題のひとつである高温超電導(High-Temperature Superconductivity)を題材に選び、LLMが専門家レベルの知識パートナーとして機能できるかを検証したものです。論文は『米国科学アカデミー紀要(PNAS)』に掲載されました。
高温超電導は、1987年のノーベル賞受賞につながる発見以来、そのメカニズムが完全には解明されていない開かれた研究課題です。銅を含むクプレート(cuprate)と呼ばれる化合物は、従来の超電導材料より高い温度(最高でおよそ−140℃)でゼロ電気抵抗を示しますが、なぜそうなるのかはいまだ諸説が競い合っています。このような分野に入る新世代の研究者にとって、中立的な視点を持つ知識パートナーが求められているという背景があります。
評価設計:閉じたシステムとウェブアクセス型の比較
評価では、参照データの種類に着目した比較が行われました。まず、高温超電導分野の国際的な専門家12名が査読論文15本を選定し、そこから引用された約3,300件の参考文献も収集されました。これらを実験論文と理論論文に分類し、計1,726件のソースが「閉じたシステム」に使用されました。
一方、ウェブアクセス型の4モデルは、公開論文765本(実験系)および1,553本(理論系)を含むインターネット全体にアクセスできる状態で評価されました。
その上で、専門家パネルが67問の設問を作成し、各LLMの回答を以下の6基準で0〜2点のスコアで評価しました:バランスある視点・包括性・簡潔さ・根拠の明示・画像の関連性・定性的フィードバック。採点にはマスクレビュー(どのモデルの回答かを評者に伏せる方式)が採用されています。
なお、RAG(Retrieval-Augmented Generation)とは、あらかじめ用意した文書データベースから関連情報を検索・取得し、その内容を踏まえて回答を生成する手法です。インターネット全体ではなく精査された文書群のみを参照させることで、回答の信頼性を高めることが期待されます。
評価結果:キュレーション済みソースの優位性
Google Researchの発表によれば、6モデルのうちNotebookLMが総合的に最も高い評価を得ました。NotebookLMはユーザーが提供した文書ライブラリをもとに回答するプロダクトで、今回は1,726件のソースが使用されました。次点は同じソースを用いたカスタムRAGシステムでした。
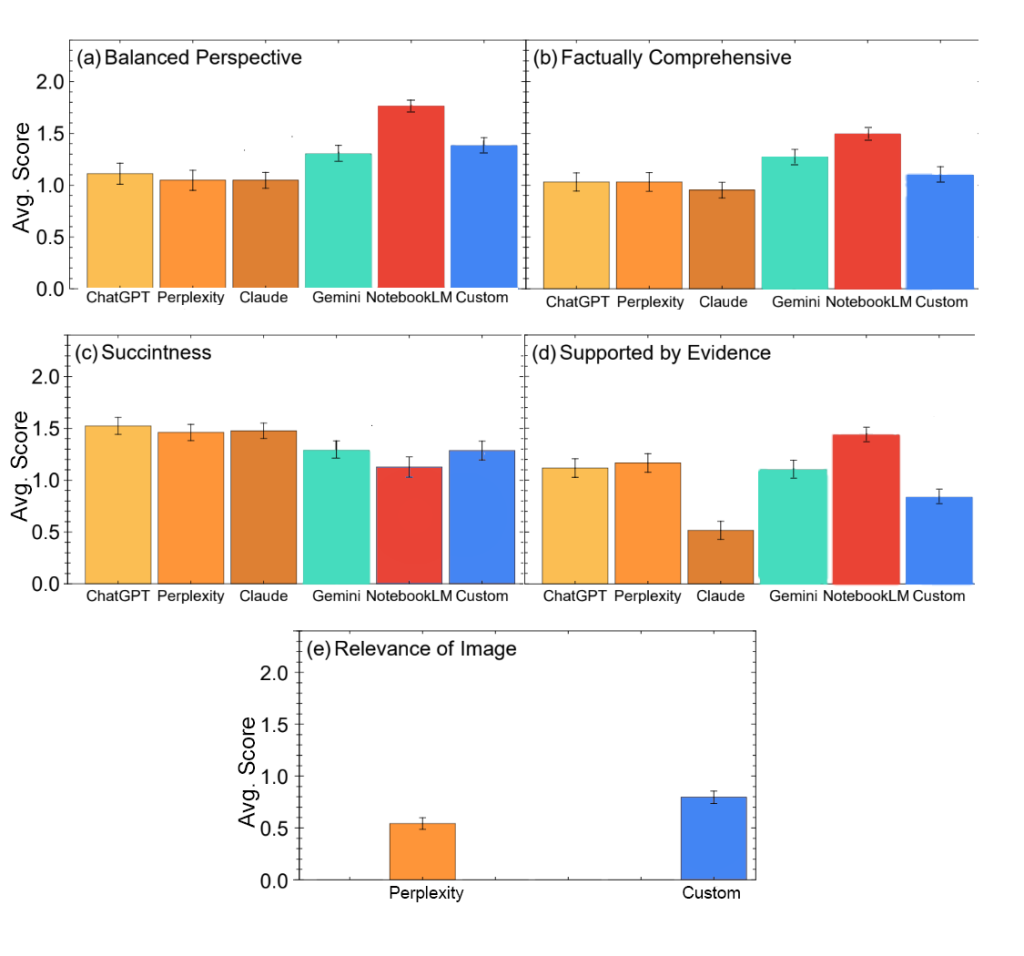
バランスある視点と包括性の項目では、NotebookLM・Gemini・カスタムRAGがトップ3を占めました。根拠の明示についてはNotebookLMが最高スコアを獲得しましたが、簡潔さでは最も低い評価となりました。画像の関連性については全モデルで総じてスコアが低く、画像を提供したモデルのうちカスタムRAGが最高評価を得ています。
ウェブベースのモデルには、確立された理論と高度に推測的な仮説を混同する傾向が見られたとのことです。専門的な文献をあらかじめ精査・選別せずに広くインターネットにアクセスする場合、情報の品質管理が難しくなる点は、AI活用を検討する際に考慮しておくべき要素と言えます。
共通する課題と今後の方向性
すべてのLLM(2024年12月時点で評価)に共通する弱点として、以下の2点が挙げられています。
第一に、時系列・文脈理解の弱さです。ある仮説が後に否定されたことを認識できず、過去の説を現在の定説として扱ってしまうケースが見られました。科学分野では理論の変遷が重要な意味を持つため、この点は信頼性に関わる課題と考えられます。
第二に、論文中の表・画像の解釈の限界です。科学論文は表やグラフを多用しますが、画像を参照したモデルも視覚的な分析よりも画像キャプションに依存する傾向が観察されました。視覚的推論(グラフの読み取りやスケールバーの解釈を含む)の強化が、今後の主要な改善方向として挙げられています。
Google Researchは引き続きこの分野の研究を進め、2026年4月開催のICLR 2026では、凝縮系理論のより厳密なLLM評価ベンチマーク「CMT-benchmark」を発表する予定です。
まとめ
今回の研究は、LLMが複雑な専門分野でも一定の能力を発揮できることを示しつつ、参照ソースの品質管理がAIの信頼性を左右する重要な要因であることを明確にしました。科学研究へのAI活用を検討する際の設計指針として、参考になる結果と思います。