はじめに
IBM Thinkが2026年2月5日、生成AIを企業システムに統合する際に考慮すべき実践的な要素について解説した記事を公開しました。本稿では、実験段階から本格運用への移行を検討する企業に向けて、コンテキスト管理、システム統合、運用手法など6つの重要ポイントを詳しく紹介します。
参考記事
- タイトル: Generative AI integration: Factors to consider
- 著者: Rina Diane Caballar、Cole Stryker
- 発行元: IBM Think
- 発行日: 2026年2月5日
- URL: https://www.ibm.com/think/insights/generative-ai-integration
要点
- 高品質なデータだけでなく、ファインチューニング、RAG、MCPといった手法でコンテキストを付与することが、生成AIモデルの性能向上に不可欠である
- 複雑な業務プロセスでは単一のLLMではなく、LLMオーケストレーションフレームワークを活用して複数のモデルを適切に管理する必要がある
- モデルへのアクセス方法には、セルフホスト、MaaS、サブスクリプションプランという3つの選択肢があり、それぞれに特徴がある
- 生成AI特有の要件に対応するため、従来のDevOpsに加えてMLOpsやLLMOpsの導入が運用の円滑化に寄与する
- ユーザー体験を重視した設計が組織内での生成AI導入を促進する鍵となる
- 将来的な事業拡大を見据えたインフラのスケーラビリティ確保が重要である
詳細解説
コンテキストの付与が性能を左右する
IBM Thinkによれば、高品質なデータは高性能な生成AIモデルにつながりますが、データ監査、統合、準備といった標準的なプロセスに加えて、関連するコンテキストを付与することで、データ品質がさらに向上し、より文脈を理解した出力が得られます。
コンテキストを含める方法の1つは、特定のドメインや実際のタスク、ユースケースに特化した小規模データセットで事前学習済みモデルをファインチューニングすることです。ファインチューニングとは、すでに大規模なデータで学習済みのモデルを、自社の業務データで追加学習させる手法を指します。この手法により、ゼロからモデルを訓練する場合に必要となる多大な時間、労力、コストを削減できます。
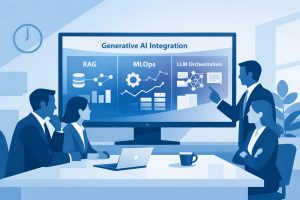
一方、RAG(Retrieval Augmented Generation)とMCP(Model Context Protocol)は、リアルタイムでコンテキストを組み込みます。RAGシステムは外部の知識ベースからデータを取得し、取得したデータから得た強化されたコンテキストでプロンプトを補強して応答を生成します。MCPも同様に機能しますが、RAGが生成前にコンテキストを追加するのに対し、MCPは生成中にコンテキストを統合する点が異なります。MCPは、AIアプリケーションが外部データソース、サービス、ツールに接続するための標準化されたレイヤーとして機能し、リアルタイムデータを活用します。
RAGは2023年頃から注目を集めている手法で、企業の内部文書や最新情報を参照しながら回答を生成できるため、幻覚(ハルシネーション)の低減にも効果があると考えられます。MCPはより新しい概念で、生成プロセス中に動的にコンテキストを取り込む点で、より柔軟な統合が可能になると期待されています。
既存システムとの調和を図る
統合プロセスでは、生成AIソリューションと既存システムの互換性を判断することが不可欠です。IBM Thinkは、AI開発チームがすでに、選択したLLMをCRM(顧客関係管理)やERP(企業資源計画)ソフトウェアと連携させるためのミドルウェアのようなコネクタを考案している可能性があると指摘しています。
ただし、単一のLLMでは不十分な場合もあり、特にビジネスプロセス自動化やワークフロー自動化における複雑なステップではその傾向が顕著です。例えば、人事部門が定期的な従業員アンケートからのフィードバックを分析するために言語モデルの自然言語処理機能を活用する場合を考えてみます。小規模言語モデル(SLM)は、個人情報を削除してアンケートを匿名化したり、主要なテーマを要約したりする単純なタスクに対応できます。一方、より強力なLLMは、センチメント分析や意思決定を支援する実行可能なインサイトの生成といった、より複雑で微妙なニュアンスを必要とするタスクを処理できます。
こうしたシナリオでは、LLMオーケストレーションが複数の言語モデルの管理を効率化します。LLMオーケストレーションフレームワークは、適切なモデルにタスクを割り当て、モデル間の相互作用を調整することで、効率性と有効性の両方を向上させます。
企業の業務では、定型的な作業から高度な判断を要する作業まで多岐にわたるため、タスクの性質に応じてモデルを使い分けることが実用的と考えられます。例えば、コスト効率を重視する場合、簡単なタスクには軽量なSLMを使い、複雑な分析には高性能なLLMを使うという使い分けが有効な選択肢になります。
モデルへのアクセス方法を選択する
IBM Thinkは、モデルの選択、動作のテスト、性能評価が生成AIソリューション統合の重要な部分であると指摘した上で、モデルのホスティングやアクセス方法も同様に重要であり、いくつかの選択肢があると説明しています。
セルフホストでは、予算、リソース、チームがあれば、オンプレミスまたはプライベートクラウドで生成AIモデルをホストできます。データを完全にコントロールでき、必要に応じてモデルをカスタマイズできます。セルフホスティングは、金融や医療など、厳格なデータプライバシーとデータセキュリティ要件がある分野に適していると考えられます。
MaaS(Model as a Service)では、機械学習モデルがクラウド上でホストされ、API経由でアクセスできます。特にLLMは、LLM API経由で利用可能になっています。MaaSは、独自のAIインフラを管理する必要がなく迅速に統合でき、従量課金制の料金体系により柔軟性が提供されます。
サブスクリプションプランでは、クラウドベースのプラットフォーム上で、サブスクリプションプランを通じて生成AIツールやアプリにアクセスします。一部のプロバイダーは、高度な機能、専任カスタマーサポート、強化されたサービスレベル契約、エンタープライズグレードのセキュリティおよびコンプライアンス機能を備えた企業向けプランを提供しています。
それぞれの選択肢には、導入コスト、運用負荷、セキュリティ要件、カスタマイズの柔軟性などでトレードオフがあります。自社の技術リソース、予算、データの機密性レベルなどを総合的に考慮して選択する必要があります。
MLOpsとLLMOpsで運用を円滑化
モデルの選択と評価の後は、モデルのデプロイが自然な次のステップとなります。しかし、IBM Thinkによれば、生成AI駆動のワークロードには、従来のDevOpsが提供するものよりも具体的なアプローチが必要になる場合があります。
ここでMLOps(Machine Learning Operations)とLLMOps(Large Language Model Operations)が登場し、生成AI統合プロセスをよりスムーズにします。MLOpsはDevOpsの原則を基盤としており、機械学習パイプラインを既存のCI/CDパイプラインに組み込むことで、継続的なモデル統合、デプロイ、モニタリング、可観測性、改善、ガバナンスを可能にします。LLMOpsはMLOpsの範囲内にありますが、ファインチューニングやLLMベンチマークを使用した評価など、LLMのライフサイクルと要件により適合しています。
DevOpsはソフトウェア開発と運用の統合を目指す手法ですが、機械学習モデルは通常のソフトウェアと異なり、データの変化に応じて性能が変動したり、定期的な再学習が必要になったりする特性があります。MLOpsはこうした機械学習特有の課題に対応するための運用手法として確立されてきました。LLMOpsは、さらに大規模言語モデル特有の要件、例えばプロンプトの管理やトークン使用量の最適化などにも対応します。
ユーザー体験を最優先に設計する
IBM Thinkは、ユーザー体験(UX)が生成AI統合の重要な要素であると強調しています。思慮深く、直感的で、ユーザーフレンドリーなインターフェースは、組織内での生成AI導入を促進するのに役立ちます。
IBM ThinkはUXを重視したヒントとして、以下を挙げています。特に生成AIプロトタイプを構築する際は、AI実装プロセスの開始時からUXデザイナーを参加させることが重要です。マルチモーダルAIモデルの場合は、チャットウィンドウやプロンプトバーを超えて、音声や画像などテキスト以外の入力タイプをサポートするスペースを確保します。特に多段階のワークフローや処理時間が長いタスクでは、タスクの進捗状況をユーザーに知らせるインジケータを採用します。異なるレベルのユーザー専門知識に対応するため、ガイド付きプロンプトやテンプレートを実装します。ユーザーの好みや以前のコンテキストを保持するメカニズムを提供します。生成AIアプリの機能を案内するインタラクティブなガイドやチュートリアルを作成します。
優れたUXは、技術的に優れたAIシステムの導入成功率を大きく左右します。特に、AI技術に不慣れなユーザーにとって、直感的なインターフェースは利用の障壁を下げる重要な要素になると考えられます。また、プロンプトの書き方に慣れていないユーザー向けにテンプレートを用意することで、AIの能力を最大限に引き出すことができます。
スケーラビリティを見据えたインフラ整備
IBM Thinkは、現在のITエコシステムを評価することが統合プロセスに不可欠であると指摘しつつ、評価は現在を念頭に置くだけでなく、将来を最優先に考えて行う必要があると強調しています。企業は、生成AIシステムの計算要求と自社の進化するビジネスニーズの両方に対応できるよう、インフラをスケールできることを確認する必要があります。
モデルのセルフホスティングを検討している場合、AIアクセラレータやその他のハイパフォーマンスコンピューティングリソースに投資することで、生成AI向けにハードウェアを最適化することを検討してください。高速で低レイテンシのデータ転送を処理できるようネットワーク機能をアップグレードすることも良い選択肢です。一方、クラウドベースまたはAPIベースのルートを選択する場合は、利用しているプラットフォームが生成AIワークロードを処理するのに十分堅牢であり、最新の生成AIの進歩に追いついているかを確認してください。
生成AIモデル、特にLLMは膨大な計算リソースを必要とします。例えば、GPUやTPUといった専用のAIアクセラレータは、従来のCPUと比較して生成AIタスクを数倍から数十倍高速に処理できると言われています。将来的に利用者数が増加したり、より高度なモデルに移行したりする可能性を考慮すると、初期段階からスケーラビリティを念頭に置いたインフラ設計が重要です。
まとめ
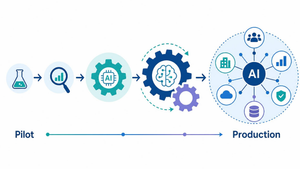
IBM Thinkは、生成AIの統合には、コンテキスト管理、システム調和、アクセス方法の選択、運用最適化、UX設計、スケーラビリティという6つの要素が重要であると解説しています。実験段階から本格運用への移行を検討している企業にとって、これらの実践的な視点は、技術的な成功だけでなく、組織全体での円滑な導入を実現する上で参考になる内容だと思います。