はじめに
Google Researchが2026年8月31日、時系列予測向けの基盤モデル「TimesFM-3」を公開しました。複数の系列や外部要因を同時に扱う多変量予測を、追加学習なしのゼロショットで実行できる点が特徴です。本稿では、モデルの構成とベンチマーク結果、実際に動かす手順を解説します。
参考記事
メイン記事:
- タイトル: TimesFM-3: A zero-shot foundation model for multivariate forecasting
- 著者: Ayush Jain、Rajat Sen(Research Scientists, Google Research)
- 発行元: Google Research Blog
- 発行日: 2026年8月31日
- URL: https://research.google/blog/timesfm-3-a-zero-shot-foundation-model-for-multivariate-forecasting/
関連情報:
- タイトル: google-research/timesfm(公式リポジトリ)
- 発行元: GitHub
- URL: https://github.com/google-research/timesfm
- タイトル: google/timesfm-3.0-pytorch(モデルカード)
- 発行元: Hugging Face
- URL: https://huggingface.co/google/timesfm-3.0-pytorch
関連記事
要点
- TimesFM-3は330Mパラメータの時系列基盤モデルであり、1兆点を超える実データと合成データの時系列コーパスで事前学習されている
- TimesFM-2.5までは単変量予測に限定されていたが、TimesFM-3は複数系列の同時予測に加え、過去共変量と過去・未来共変量をネイティブに扱える
- 時間方向の因果アテンションと系列間の全結合アテンションを交互に配置し、Contiguous Patch Maskingにより予測区間全体を1回のフォワードパスで生成する
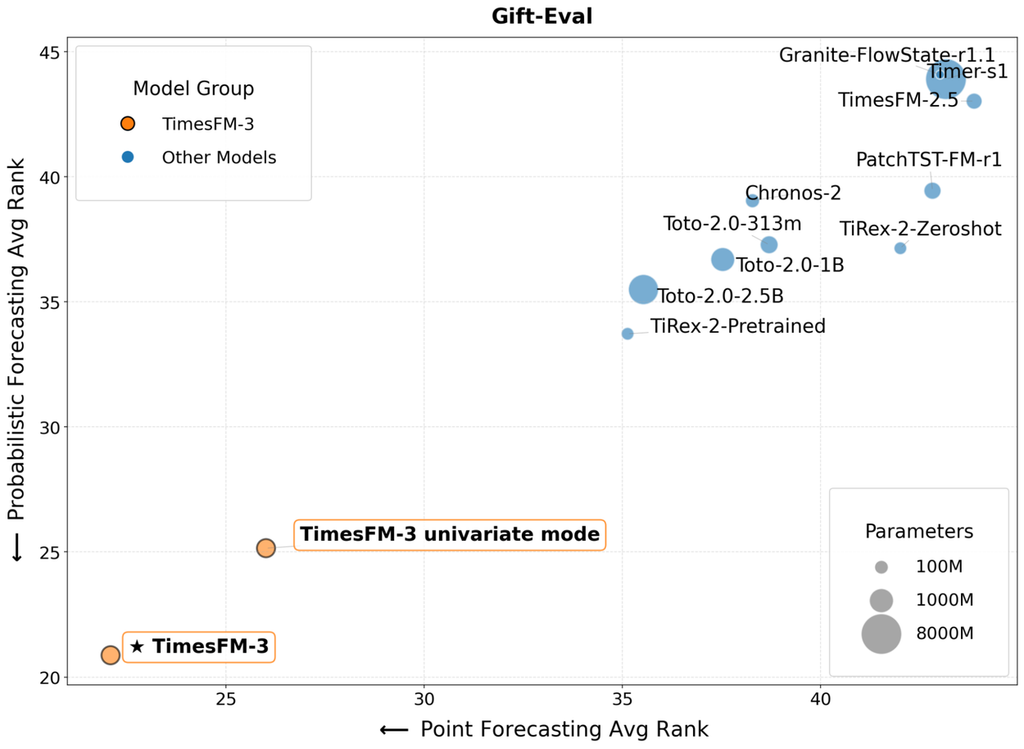
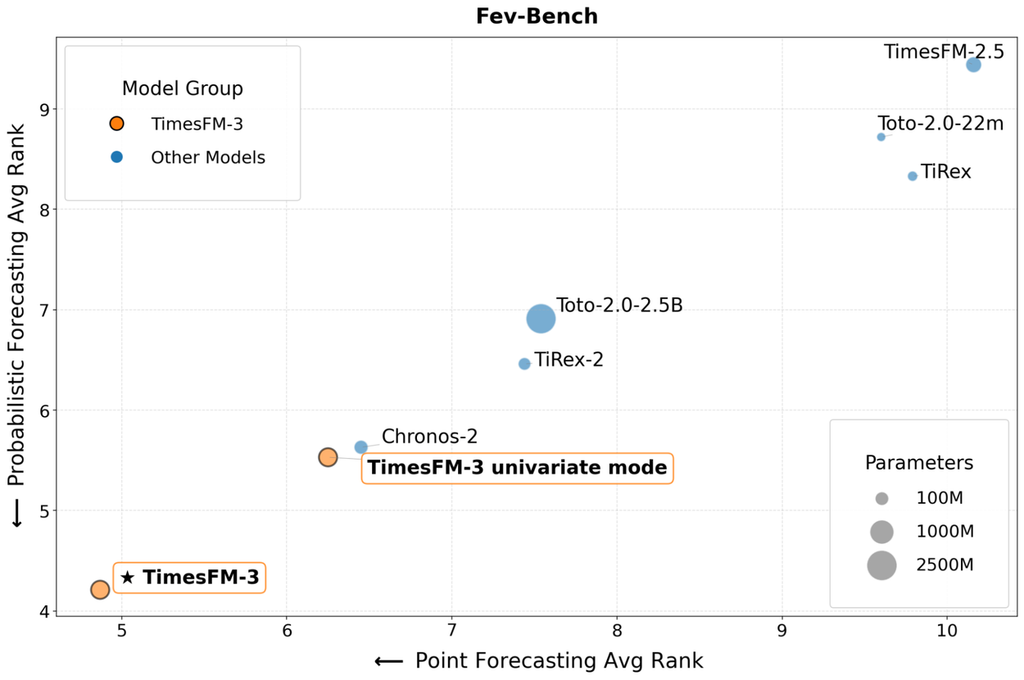
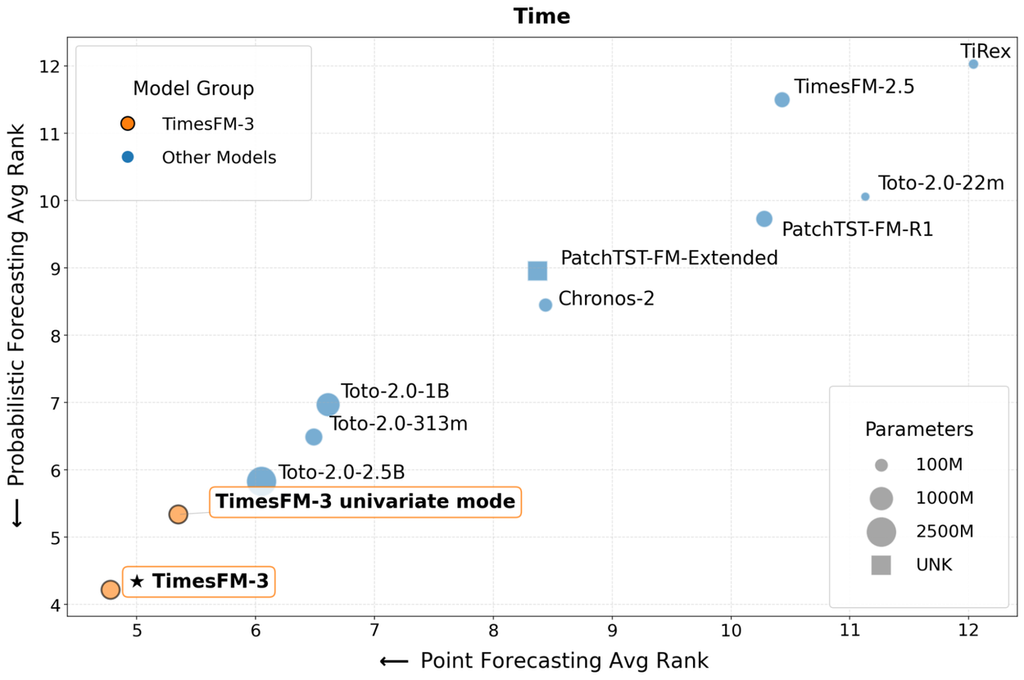
- GIFT-Eval、fev-bench、TIMEの3つの公開ベンチマークにおいて、点予測・確率予測の双方で事前学習済み基盤モデル中の最上位にランクした
- 推論コードはApache-2.0で公開されている一方、TimesFM 3.0の事前学習済み重みは非商用ライセンスで配布されており、商用・本番利用は認められていない
詳細解説
単変量から多変量へ——何が変わったのか
TimesFMは2024年に初代が公開された、時系列予測に特化した基盤モデルです。基盤モデル(foundation model)とは、大規模なデータで事前学習しておくことで、個別のタスクごとに学習し直さなくてもそのまま使えるモデルを指します。時系列の分野では、これは「手元の売上データで学習させることなく、いきなり将来値を予測できる」ことを意味します。
ただし、2025年9月に公開されたTimesFM-2.5までのモデルは、単変量予測に限定されていました。単変量予測とは、1本の時系列の過去の履歴だけを見て将来を予測する方式です。Google Researchはこの制約について、現実の予測課題の多くは本質的に多変量であると説明しています。小売チェーンのアイスクリーム売上を例に挙げると、過去の売上だけでは全体像はつかめず、関連商品(コーンやシロップ)の売上、来店客数の推移、さらには天気予報やセール、祝日といった「未来に起きることが分かっている情報」も予測に効いてくるという指摘です。
TimesFM-3は、この多変量シナリオをゼロショットで扱えるように設計されています。330Mパラメータを持ち、実データと合成データを合わせて1兆点を超える時系列コーパスで事前学習されました。ネイティブに対応する入力は、次の3種類です。
- 複数ターゲット : 関連する複数の時系列を同時に予測する(例: 複数ブランドのアイスクリームを一括で予測する)。すべてのターゲットについて点予測と分位点予測の両方に対応します。
- 過去共変量(past covariates) : 過去の値だけが分かっている補助変数(例: これまでの来店客数)。
- 過去・未来共変量(past-future covariates) : 未来の値も既知の補助変数(例: 計画済みの販促キャンペーンや天気予報)。
共変量(covariate)とは、予測したい対象そのものではないものの、その値に影響を与える外部の変数を指します。従来は共変量を扱うために回帰モデルを外付けするなどの工夫が必要でしたが、モデル側がネイティブに受け取れることで、前処理の設計が簡潔になると考えられます。Googleは表形式データ向けにもゼロショットの基盤モデル「TabFM」を公開しています。特定のデータ形式に対して「学習不要で使える汎用モデル」を用意していく流れが、時系列にも及んできたと言えます。
アーキテクチャ——交互アテンションと単一パス生成
TimesFM-3は、従来版と同じデコーダのみのTransformerアーキテクチャを基礎としています。時系列は連続する32ステップを1つのパッチ(patch、まとまり)にグループ化して処理され、系列ごとに正規化が適用されます。正規化は、スケールが大きく異なる系列(たとえば売上が数十件の商品と数万件の商品)を同じモデルで扱うための処理です。
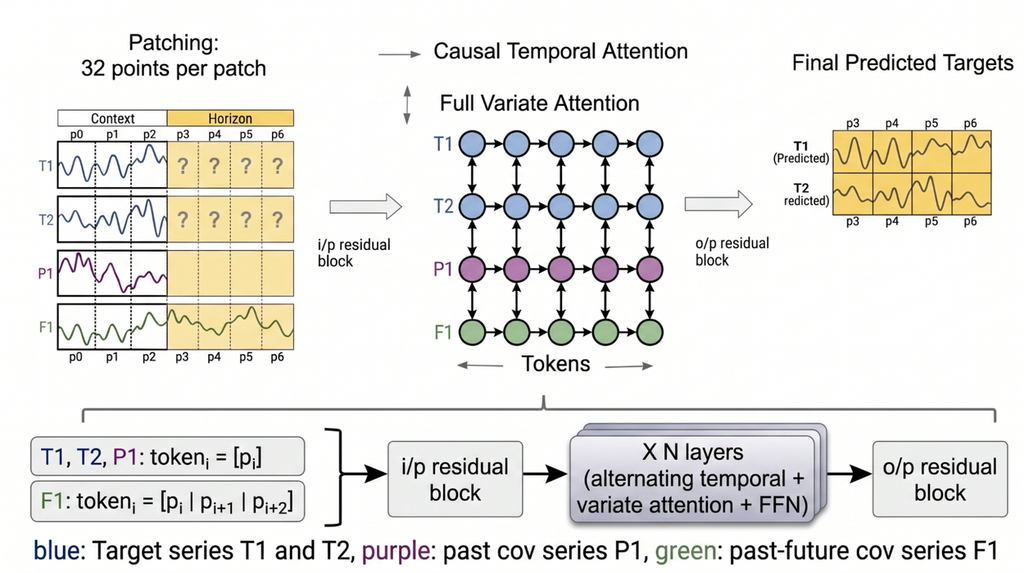
トークンの作り方には工夫があります。ターゲット系列と過去共変量は1つのパッチからそのままトークンを構成しますが、過去・未来共変量については「先読み(lookahead)」の方式が採られています。各トークンが現在のパッチと未来のパッチを連結して持つことで、モデルが既知の未来の信号を覗き見できる仕組みです。
トークン化されたパッチは入力残差ブロックを経て、2次元グリッドとして動作するTransformerスタックに入ります。ここで2種類のアテンションが交互に適用されます。
- 因果的な時間方向アテンション : トークンが時間軸に沿って水平方向に注意を向けます。データ漏洩を防ぐため厳密に因果的であり、あるトークンは自分自身の系列内の過去のトークンしか参照できません。
- 全結合の変量間アテンション : トークンが系列軸に沿って垂直方向に注意を向けます。任意の時点で他のすべての系列を参照できるため、系列をまたぐ相関(ある商品の販促が別の商品の売上に与える影響など)を学習できます。
もう1つの変更点が、非自己回帰デコードです。従来のTimesFMは1パッチずつ予測を生成しており、レイテンシ、誤差の累積、計算コストの増加を招いていました。TimesFM-3はContiguous Patch Masking(arXiv:2505.23719)という手法を用い、予測区間全体を1回のフォワードパスで生成します。観測済みのコンテキストに加えて未来区間ぶんのマスク済みプレースホルダートークンを並べ、ターゲットと過去共変量は未来区間をマスクする一方、過去・未来共変量は見えたままにしておく構成です。交互アテンション層を通すことで、マスクされた未来のパッチが一括で埋められます。出力は各ターゲット・各時点について10パーセンタイルから90パーセンタイルまでの9分位点であり、予測の不確実性を確率分布として受け取れます。
Hugging Faceのモデルカードによれば、実装は20層のTransformer(モデル次元1280、ヘッド数16)で、コンテキスト側のパッチ長は32、予測区間側のパッチ長は64とされています。事前学習データにはGiftEvalPretrain(fev-benchと重複するデータセットを除外)、Wikipediaのページビュー、Googleトレンドの上位クエリ、および合成・拡張データが用いられています。反復的な生成をなくした構成は、推論回数が読める点で運用上も扱いやすいと考えられます。
プロモーション計画で見る多変量予測の効き方
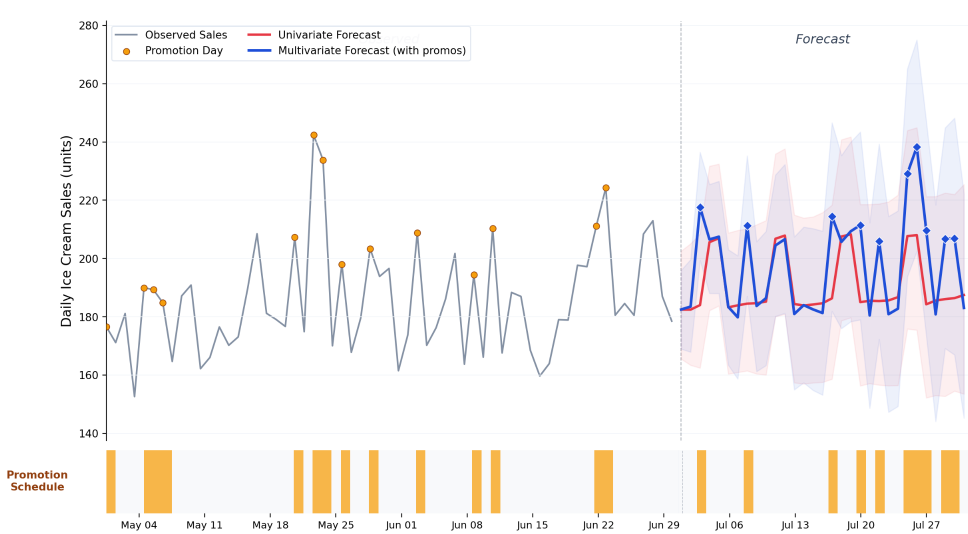
Google Researchは、アイスクリーム売上の例で多変量予測の効果を示しています。単変量モデルは過去の売上から週次のパターンを未来に投影するだけで、特定日の販促計画を知る手立てがありません。一方、TimesFM-3の多変量モードでは、販促スケジュールを過去・未来共変量として渡すことで、モデルが過去のコンテキストから「販促と売上増の関係」を学び取り、それを販促予定日に適用します。結果として、販促日ごとに約20%の売上増を織り込んだ予測が得られたと説明されています。
この差は1日単位では小さく見えても、月次の売上見込みでは無視できない差として積み上がっていきます。在庫計画や人員配置のように予測値をそのまま業務判断に流し込む用途では、既知の未来イベントを入力できること自体が精度以上に重要な要件になる場面もあると考えられます。
ベンチマーク結果
評価は、GIFT-Eval、fev-bench、TIMEの3つの公開ベンチマークで実施されました。Google Researchによれば、TimesFM-3は3つすべてにおいて、点予測・確率予測の両方の指標で事前学習済み基盤モデル中の最上位にランクしています。GitHubリポジトリの記載では、fev-benchでは100種類の実世界タスク全体で総合1位、TIMEベンチマークでは50のドメインデータセット・98の評価タスクで総合1位、GIFT-Evalでは全基盤モデル中1位とされています。比較対象には、多変量に対応するChronos-2やToto 2.0ファミリー、および前世代のTimesFM-2.5が含まれます。
注目したいのは、共変量や系列間情報を一切使わない「単変量モード」の結果です。各系列を独立に扱うこの設定でも、TimesFM-3は他の競合モデルに匹敵するか上回っており、多変量モードに切り替えるとさらに順位が上がったと報告されています。多変量対応が単変量性能を犠牲にしていないという意味で、既存の単変量パイプラインからの移行を検討しやすい結果だと思います。
なお、これらの指標はタスクをまたいだ平均ランクであり、特定のドメインや粒度で常に最良であることを保証するものではありません。導入時には自社データでのバックテストを行い、ベースライン(季節性ナイーブ法や既存の統計モデル)と比較したうえで判断することが重要だと思います。
前提条件・インストール
ここからは実際に動かす手順です。TimesFM 3.0のコード例はPyTorch版を前提としており、GPU(device="cuda")を想定しています。まず、Python(プログラミング言語)のバージョンを確認します。
# インストール済みのPythonのバージョンを表示するコマンドです
python --version
インストール方法は2通りあります。もっとも簡単なのはPyPI(Pythonの公式パッケージ配布サイト)からの導入です。
# pip(Pythonのパッケージ管理ツール)でPyTorch版のTimesFMを導入するコマンドです
# 角括弧の [torch] は「PyTorch向けの追加依存パッケージも一緒に入れる」という指定です
pip install timesfm[torch]
注意 : zshなど一部のシェルでは角括弧が特別な文字として解釈され、エラーになる場合があります。うまくいかないときは pip install "timesfm[torch]" のように引用符で囲んで実行してください。
リポジトリのコードを直接触りたい場合は、ローカルインストールを選びます。以下は公式READMEに記載されている手順です。
- リポジトリを手元に複製します。
# GitHubのリポジトリをローカルにダウンロードするコマンドです
git clone https://github.com/google-research/timesfm.git
- 複製したディレクトリに移動します。
# ダウンロードしたフォルダに移動するコマンドです
cd timesfm
- 仮想環境を作成し、PyTorch版として導入します。仮想環境は、プロジェクトごとにライブラリのバージョンを隔離しておくための仕組みで、他のプロジェクトとの依存関係の衝突を避けるために使います。
# uv(高速なPythonパッケージ管理ツール)で仮想環境を作成します
uv venv

# 作成した仮想環境を有効化します(Mac/Linuxの場合)
source .venv/bin/activate

# 現在のフォルダのコードを編集可能モード(-e)でインストールします
uv pip install -e .[torch]
注意 : Windowsで仮想環境を有効化する場合は、source .venv/bin/activate ではなく .venv\Scripts\activate を実行します。また、初回実行時にはHugging Faceからモデルの重みファイル(学習済みのパラメータ)がダウンロードされるため、数GBの通信と保存領域が必要になる点にご注意ください。
実装例1: 単変量予測(可変長の入力)
まずは基本となる単変量予測です。長さの異なる1次元のNumPy配列をまとめて渡すだけで予測できます。以下はGitHubのREADMEに掲載されているサンプルコードです。
import numpy as np
from timesfm3 import TimesFM3Evaluator, ModelConfig

# TimesFM 3.0 の初期化
config = ModelConfig(
    checkpoint_path="google/timesfm-3.0-pytorch",  # Hugging Face上のモデルID
    per_core_batch_size=32,                        # 1コアあたりのバッチサイズ
    device="cuda"                                  # 実行デバイス(GPU)
)
forecaster = TimesFM3Evaluator(config)

# 長さの異なる2本の単変量系列(100ステップと72ステップ)
ts1 = np.linspace(0, 1, 100).astype(np.float32)
ts2 = np.sin(np.linspace(0, 24, 72)).astype(np.float32)

# 予測を生成(点予測 + 9分位点: 0.1〜0.9)
outputs = list(forecaster.predict_batch([ts1, ts2], horizon=12, return_quantiles=True, use_symmetric_averaging=False))

print("Series 1 forecast shape:", outputs[0].forecast.shape)   # (12,)
print("Series 1 quantiles shape:", outputs[0].quantiles.shape) # (12, 9)

print("Series 2 forecast shape:", outputs[1].forecast.shape)   # (12,)
print("Series 2 quantiles shape:", outputs[1].quantiles.shape) # (12, 9)
horizon は何ステップ先まで予測するかの指定です。return_quantiles=True にすると、点予測に加えて9つの分位点が返ります。出力の形状が (12, 9) になっているのは、12ステップぶん × 9分位点という意味です。系列ごとに長さが違っていてもそのまま渡せる点は、欠損期間や導入時期がまちまちな商品データを扱う場面で扱いやすい仕様だと思います。
実装例2: 共変量つきの多変量予測
多変量予測では、(変量数, コンテキスト長) の形状を持つ2次元配列を渡します。あわせて、過去のみ既知の共変量と、過去・未来ともに既知の共変量を任意で指定できます。
import numpy as np
from timesfm3 import TimesFM3Evaluator, ModelConfig

# TimesFM 3.0 の初期化
config = ModelConfig(
    checkpoint_path="google/timesfm-3.0-pytorch",
    per_core_batch_size=16,
    device="cuda"
)
forecaster = TimesFM3Evaluator(config)

context_len = 128  # 過去データの長さ
horizon = 24       # 予測したい未来の長さ

# 3本のターゲット変量(過去コンテキスト): (3, 128)
target = np.random.randn(3, context_len).astype(np.float32)

# 過去のみ既知の共変量チャネル1本: (1, 128)
past_only_cov = np.random.randn(1, context_len).astype(np.float32)

# 過去・未来ともに既知の共変量チャネル2本: (2, 152) ※コンテキスト長 + 予測長
past_future_cov = np.random.randn(2, context_len + horizon).astype(np.float32)

# 3本のターゲット変量に対して同時に予測を生成
outputs = list(
    forecaster.predict_batch(
        contexts=[target],
        horizon=horizon,
        past_only_covariates=[past_only_cov],
        past_future_covariates=[past_future_cov],
        return_quantiles=True,
        use_symmetric_averaging=False,
    )
)

print("Multivariate forecast shape:", outputs[0].forecast.shape)   # (3, 24)
print("Multivariate quantiles shape:", outputs[0].quantiles.shape) # (3, 24, 9)
ここで押さえておきたいのは、配列の長さの違いです。past_only_cov はコンテキスト長(128)ぶんしかありませんが、past_future_cov はコンテキスト長 + 予測長(128 + 24 = 152)の長さを持ちます。 注意 : この長さが合っていないとエラーになるため、販促フラグや祝日フラグを渡す際は、未来の予測区間ぶんまで値を用意しておく必要があります。上記のコードは公式READMEのサンプルをもとにしており、乱数データを使った動作確認用の構成です。実データに置き換える際は、スケールや欠損の扱いを別途検討することになると思います。
ライセンスと提供形態
利用にあたって確認しておきたいのがライセンスです。GitHubリポジトリのソースコードはApache-2.0で、バージョン2.5までのモデル重みもApache-2.0のまま提供されています。一方、TimesFM 3.0の事前学習済み重みは「timesfm-non-commercial-license-v1.0」という別のライセンスで配布されており、現時点では非商用・非本番用途に限定されています。商用や本番環境での利用は認められていないため、業務システムへの組み込みを検討している場合は、この点を先に確認しておく必要があります。
提供形態としては、GitHubとHugging Faceで公開済みで、BigQueryとの統合は数週間以内に予定されているとGoogleは説明しています。それまでの間は、BigQueryの AI.FORECAST コマンドからTimesFM-2.5を単変量タスクで試せます。SQLだけで呼び出せるため、機械学習の専門知識がなくても挙動を確かめられる導線になっています。
まとめ
TimesFM-3は、複数系列と共変量をゼロショットで扱い、予測区間を単一パスで生成する時系列基盤モデルです。3つのベンチマークで上位を占めた一方、3.0の重みは非商用ライセンスである点は事前の確認が要ります。Googleが進める基盤モデル展開は、ウェアラブル向けのSensorFMなど他領域にも広がっています。