はじめに
Google Antigravityの開発チームが2026年8月27日、AIエージェントが提案と反証を重ねながら長時間の課題に取り組む基盤「Teamwork」の最新成果を公開しました。本稿では、この記事とGoogle公式ブログの発表をもとに、Teamworkの仕組みと3分野で報告された結果を解説します。
参考記事
メイン記事:
- タイトル: Teamwork: When AI Becomes a Research Partner
- 著者: The Antigravity Team
- 発行元: Google Antigravity Blog
- 発行日: 2026年8月27日
- URL: https://antigravity.google/blog/teamwork-when-ai-becomes-a-research-partner
関連情報:
- タイトル: Pairing Google Antigravity with Gemini 3.7 Flash solves notable multi-agent math and engineering problems
- 発行元: Google Blog
- 発行日: 2026年8月31日
- URL: https://blog.google/innovation-and-ai/technology/developers-tools/antigravity-teamwork-multi-agent/
関連記事
要点
- Teamworkは、AIエージェントが互いの成果物を批評しながら数時間から数日にわたって作業を進めるマルチエージェント基盤であり、Antigravityの有料プランで /teamwork-preview として提供されている
- Long Proofパターンにより、FOCSやJMLRなどで提起された未解決問題を含む7件の結果が報告され、うち5件はarXivで公開、Knuthの巡回予想に関する証明はLeanで形式検証された
- 7件はGemini 3.1 Proによる結果であり、そのうち3件はGemini 3.7 Flashでも再現された
- 理論計算機科学の評価セットTCSBenchでは、Gemini 3.7 Flashと3.1 Proの併用で71%を記録した
- Gemini 3.7 Flashを用いてサイクル精度のRISC-V CPUシミュレーターが構築され、OS「xv6」の起動と平均0.71%のサイクル誤差が報告された
詳細解説
Teamworkはどのような枠組みか
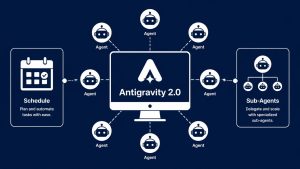
Teamworkは、2026年5月のGoogle I/Oで発表された開発者向け機能の系譜にあるマルチエージェント基盤です。エージェントが案を出し、互いに批評し、修正を重ねる過程を自律的に回します。Antigravityの記事によれば、現在は全有料プランで /teamwork-preview として利用でき、数時間から数日単位で動作する長期タスクを想定しています。
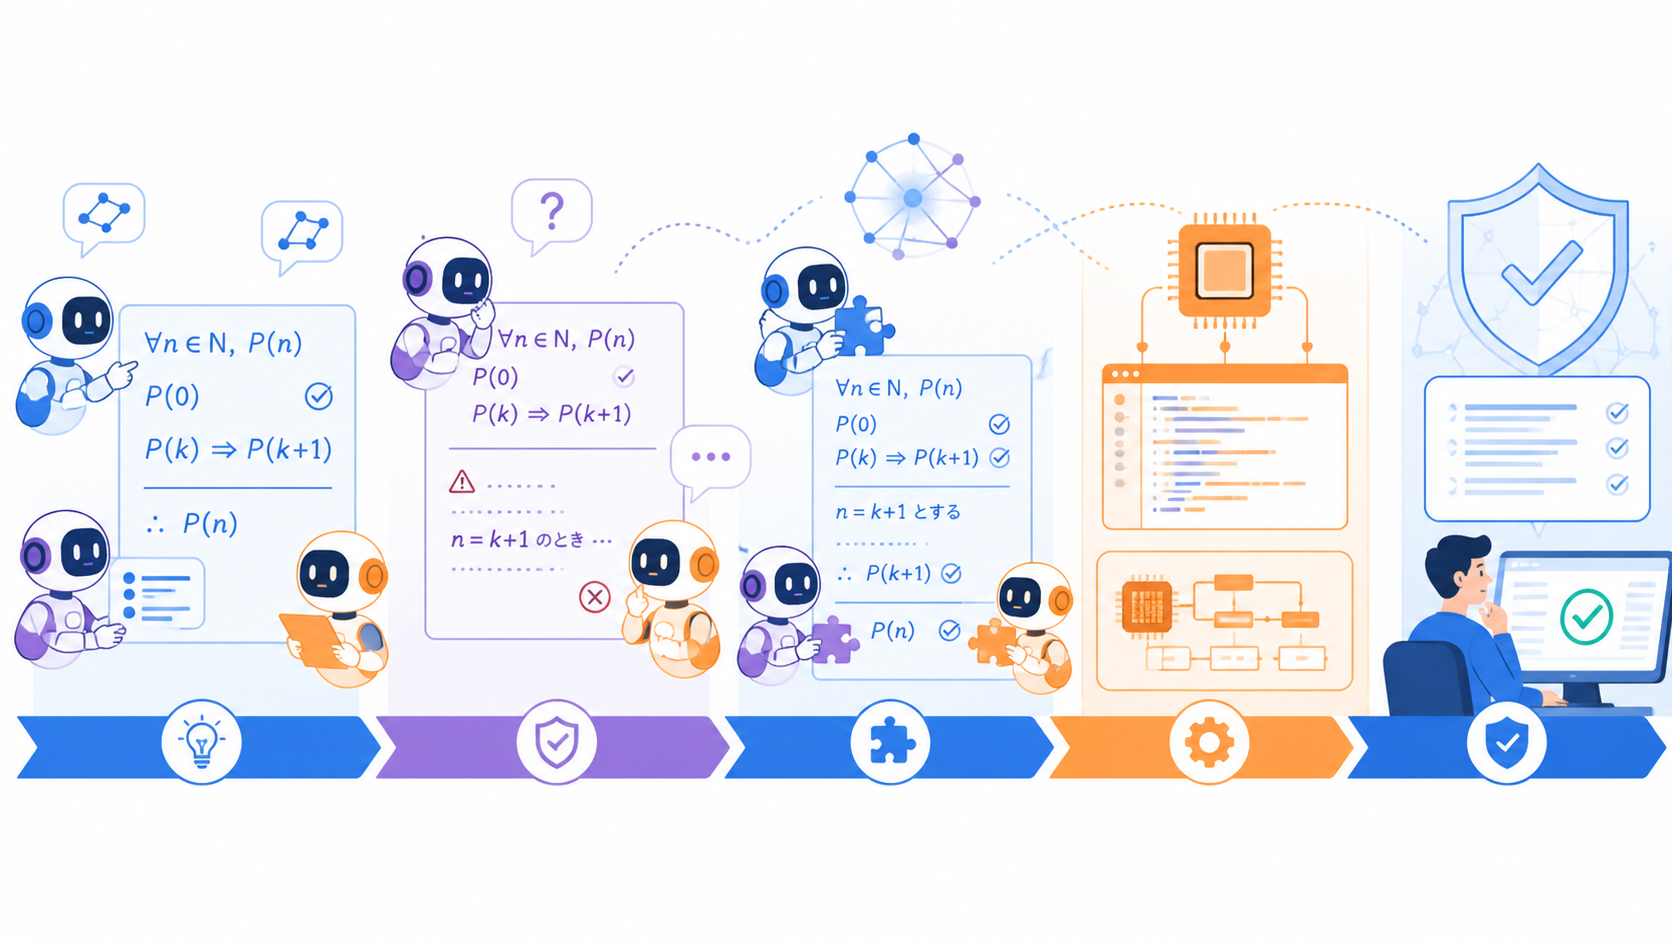
同チームは、単純なマルチエージェント構成の限界にも触れています。定型的な作業なら基本的な構成でも足りるものの、難易度の高い研究・工学課題では、緩く組織されたエージェントが早い段階の誤りに同調し、その上に自信を持って積み上げてしまうという問題が起きやすいとしています。多くの研究課題は「候補を生成し、負荷をかけて検証し、良い部分を統合する」という共通構造を持つため、Teamworkはこのループを設定可能な形で明示的に実装した枠組みだと説明されています。 検証を回すこと自体を設計に組み込んだ点 が、単にエージェントを並列に並べる構成との違いだと考えられます。
パターンという設計単位
Teamworkは単一の固定チームではなく、課題の性質ごとに異なる構成を「パターン」として定義します。パターンは、どのエージェントが参加し、どの役割を担い、作業が次段階へ進むための基準は何かを記述した設計図にあたります。ユーザーが /teamwork-preview を呼び出すと、Geminiがプロンプトを解析して適切なパターンを自動選択します。
現在提供されているのは、分割しにくい課題を「実装・テスト・改良」の密なループで解くIterative Coding、分割可能な工学課題を並列ワーカーに展開して批評役がレビューするDistributed Coding、数学・理論計算機科学向けのLong Proof、各段階で厳密な自己検証を行うSelf-Verification、論文や技術文書の構造的な分析を行うDocument Reviewの5種類です。
設計上の要点として、Antigravityチームはオーケストレーションのロジックとエージェントの記述が分離されている点を挙げています。パターンは実行プログラムではなく仕様であり、フレームワーク側がパターンを読み取ってタスクに応じたエージェントを起動します。そのため、敵対的な批評ループのような機構を、まったく異なる領域へ改変なしに移植できるとされています。エージェント数やチーム構成は実行中にも変化し、事前に決まった数ではなく課題の要求に応じて動的に決まります。この構成は、 必要な検証の量が事前に読めない研究課題 に対しては合理的な設計だと言えます。
Long Proofが未解決問題に取り組む仕組み
7件の成果を支えたLong Proofパターンは、証明を書くこと以上に「戦略の選定」に労力を割く設計になっています。未解決問題では有望に見えた方針が後になって破綻することが多く、しかもその欠陥は深く進むまで見えないためです。
中心となるのは競争的な戦略探索です。多数の候補戦略を並列に生成し、それぞれに「その戦略を壊すことだけを担当する反証者」を付けます。統合ツリーが候補と反証レポートを組み合わせ、否定された経路も反論を添えたまま残されます。壊れた経路にも有用な着想が含まれることがあるためです。選ばれた戦略は、目標と依存関係が明示された部分問題へ分解され、依存グラフに従って独立な部分問題は並列に、依存する部分問題は順序どおりに処理されます。
各部分問題は独自のトーナメント網を持ち、統合ツリーの各ノードが候補と批評を読み込んで改良版を作ります。統合結果が失敗した場合は、蓄積された反論とともに再実行されます。さらに、失敗した草稿は次の試行でも参照でき、検証者が見つけた指摘は答えに依存しない「落とし穴の記録」として蒸留されます。証明済みの結果や有用な観察、失敗した方針、関連文献は共有ディレクトリに記録されます。 失敗の記録を資産として引き継ぐ設計 は、長時間の探索で同じ誤りを繰り返さないための工夫だと考えられます。
数学・理論計算機科学で報告された結果
Antigravityチームによれば、Long Proofパターンを用いて理論計算機科学の未解決問題に取り組み、7件の結果が得られました。内訳は、ℓp部分空間近似のコアセット構成(FOCS 2025で提起)、疎な最小二乗目的に対する条件数の条件付き下界(JMLR 2021で提起)、単一・複数ベクトル埋め込みにおけるChamfer類似度の計算量、証明可能なHadamard量子化(第2段階の量子化を不要にし主要定数を約5.93倍改善)、Erdősの単位距離問題(インターネット接続なしで既存の突破口を独立に再現)、prefix行列分解のほぼ最適な下界、そしてKnuthの巡回予想(偶数の場合の2つの簡易な構成に対する初の証明、40ページ超および70ページ超)です。
検証の扱いは明確に区別されています。Knuthの巡回予想を除く結果は人間の専門家によって正しさが確認され、Knuthの結果についてはLeanで形式検証されました。5件はarXivで公開されています。また、これらはGemini 3.1 Proで得られた結果であり、そのうち3件がGemini 3.7 Flashでも再現されたとされています。Antigravityチームは、適切なオーケストレーション枠組みのもとでFlash層のモデルがこの水準の数学研究を生み出したのは初めてだと説明しています。一部の結果では既定より高い並列度が使われており、Antigravityで提供される版はコストと能力のバランスを取った設定になっているとのことです。
ベンチマークについても数値が示されています。Google社内で独自に開発された理論計算機科学の評価セットTCSBenchにおいて、Gemini 3.7 Flashと3.1 Proを併用したLong Proofパターンは71%を記録しました。TCSBenchの論文でGemini 3.6 Flashと3.1 Proの組み合わせが報告した67.7%からの上積みで、社内テストでの最高値だとしています。FlashとProを組み合わせる機能は今後の更新で提供予定です。数ポイントの差ではありますが、 同じモデル系列でオーケストレーションを変えた比較 である点は、評価を読むうえで押さえておきたい部分だと思います。
なお、Self-Verificationパターンは、今年発表された数学研究向けエージェント「Aletheia」に着想を得たものだと説明されています。生成・検証・修正を反復しながら数学的な議論を組み立てる方式です。
システム設計とオープンソースへの貢献
Gemini 3.7 Flashを用いた事例として、サイクルレベルのアウトオブオーダー実行RISC-V CPUシミュレーターをゼロから構築した例が報告されています。教育用OSとして知られるxv6をシェルまで起動し、100件以上のRISC-V標準ベンチマークを実行できたとされています。作業は、アウトオブオーダーパイプラインやリオーダーバッファなどの中核ロジックを組み上げる「機能的正しさ」の段階と、性能特性を厳密なタイミング基準に合わせる「サイクルレベルの検証」の段階に分けられました。BOOMハードウェアの実行結果を正解として照合したところ、未知のテスト負荷で平均0.71%のサイクル整合誤差だったと報告されています。
興味深いのは、この課題の難所として挙げられた「静かな実行のずれ」という考え方です。マイクロアーキテクチャの状態が最大で数百サイクルにわたり静かに乖離し、その後にようやくアーキテクチャ上の失敗として表面化する、という現象を指します。Teamworkは、隔離されたSpikeリファレンスシミュレーターと歩調を合わせた継続的な協調シミュレーションでこの問題に対処しました。不正な近道を防ぐため、Spikeのソースコードは参照できない状態に置かれています。 検証環境そのものを設計対象に含めている点 は、エージェントに長時間の自律作業をさせる際の実務的な示唆を含んでいると考えられます。
オープンソースへの貢献も2件報告されています。線形代数ライブラリEigenでは、行列が単一の行または列を持つ場合のGeMV演算に非効率な実装が見つかり、直接データアクセスと4方向のアキュムレータ展開を伴うSIMD処理による専用の高速経路が実装されました。Gemini 3.6 Flashの支援を受けてコードレビュー工程を通し、上流に取り込まれています。並行ハッシュテーブルParlayHashに対しては、Swiss Tableの最適化を取り入れた「Swiss Parlay」の着想に貢献し、64スレッドでの初期挿入で2倍、シングルスレッド全体で1.5倍のスループット、要素あたり25%少ないメモリでの逐次性能を達成したとされています。いずれも外部のメンテナが通常のレビュー工程を経て受け入れた変更であり、ベンチマーク上の数値にとどまらない点が強調されています。
まとめ
Teamworkは、候補生成・反証・統合のループを明示的に組み込み、数学・ハードウェアシミュレーション・OSS最適化の3分野で外部検証を伴う結果を出しました。人間の確認や形式検証、上流への取り込みという検証経路が示されている点が要点だと思います。Aletheiaについては、過去記事でも整理していますので、あわせてご覧ください。