はじめに
Googleの研究者らが2026年4月16日、合成データ生成フレームワーク「Simula」を紹介する論文を発表しました。個別サンプルの最適化ではなくデータセット全体を「機構設計」として捉え直すことで、カバレッジ・複雑さ・品質を独立して制御できる点が特徴です。本稿では、その仕組みと実験結果、実用事例について解説します。
参考記事
- タイトル: Designing synthetic datasets for the real world: Mechanism design and reasoning from first principles
- 著者: Tim R. Davidson, Hamza Harkous
- 発行元: Google Research Blog
- 発行日: 2026年4月16日
- URL: https://research.google/blog/designing-synthetic-datasets-for-the-real-world-mechanism-design-and-reasoning-from-first-principles/
関連記事
要点
- Simulaは合成データ生成を「機構設計」として再定義したフレームワークであり、シードデータ不要・エージェンティックな設計が特徴である
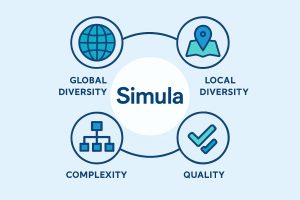
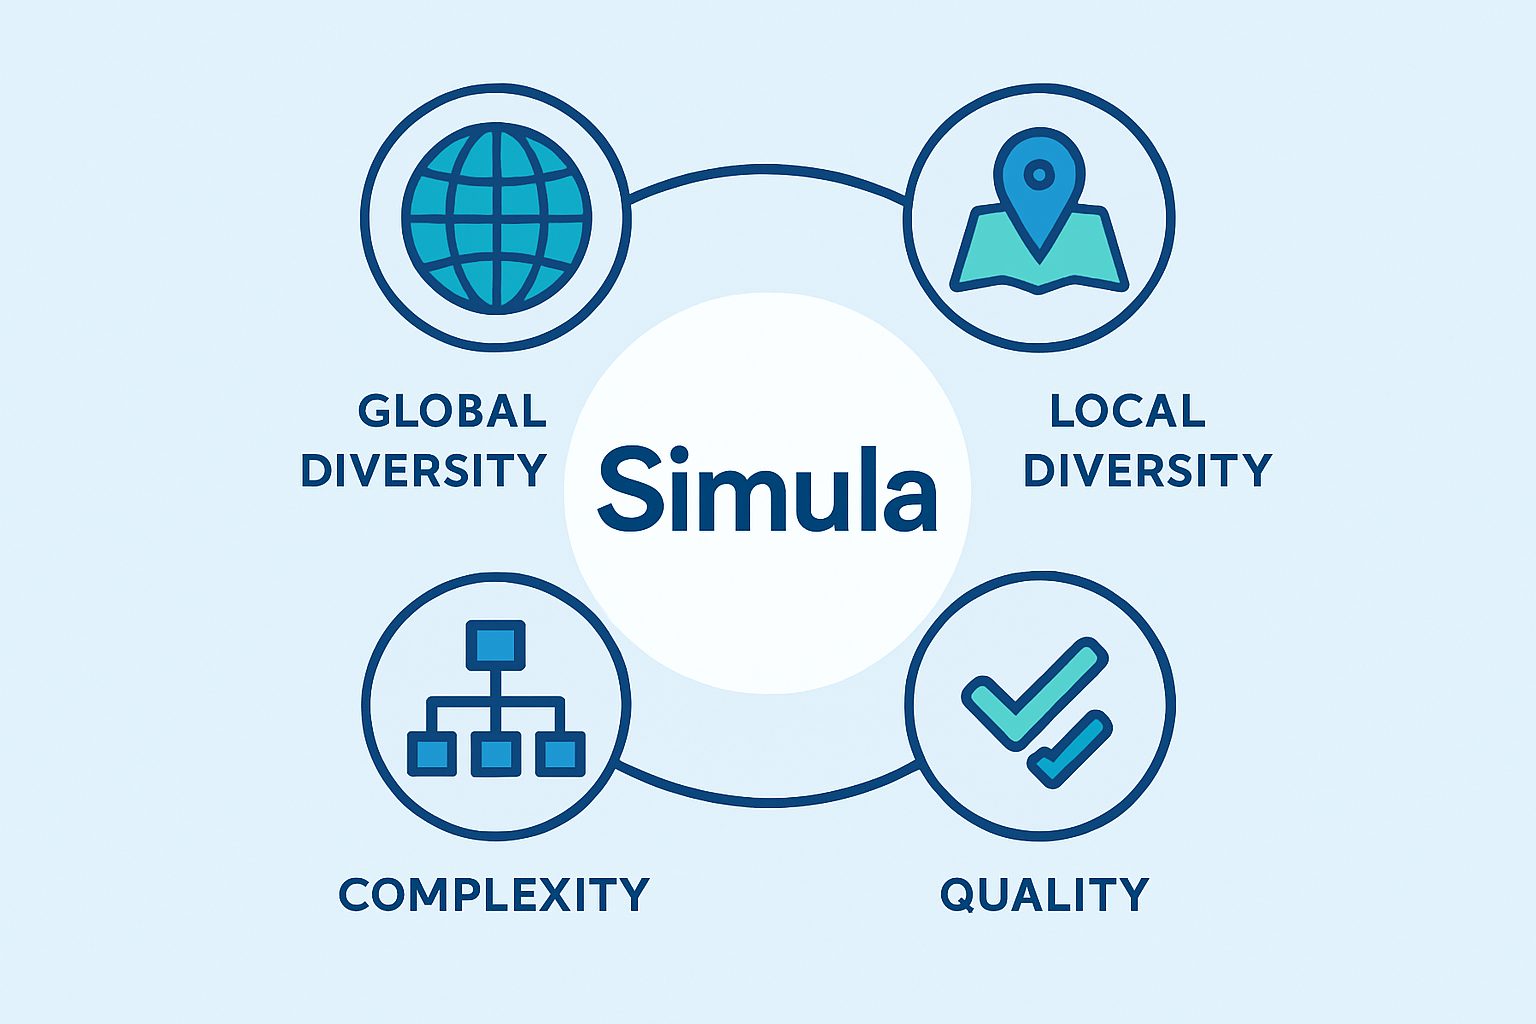
- データ生成プロセスをグローバル多様化・ローカル多様化・複雑化・品質チェックの4軸に分解し、それぞれを独立して制御できる
- 数学推論では複雑化による10%の精度向上が確認された一方、法律推論では逆効果となるなど、最適な設定はドメインによって異なる
- より少ないサンプル数で高い下流性能を達成し、「データの質が量に勝る」というスケーリング則の傾向が示された
- ShieldGemma・FunctionGemma・MedGemmaを含むGemmaエコシステムや、AndroidのAI詐欺検知・スパムフィルタリングにも実用展開されている
詳細解説
合成データが必要な理由と既存手法の課題
汎用AIの急速な進化はインターネット上の大量データに支えられてきましたが、サイバーセキュリティ・医療・法律などの専門領域への展開では、プライバシー保護や希少性の観点から実世界データの収集に限界があります。Googleの論文によれば、実世界データへの依存は3つの問題をもたらします。第一に専門データセットの手動作成は高コストかつエラーが生じやすいこと、第二に静的なデータが開発サイクルの遅延を招くこと、第三にシステム障害が起きてから対策を講じる「リアクティブなアプローチ」の問題です。合成データを使えば、実際には発生していないエッジケースも事前に生成してシステムを強化できると論文は指摘しています。
一方、既存の合成データ生成手法にも課題があるとされています。手動プロンプト・進化的アルゴリズム・ターゲット分布からのシードデータに依存する多くの手法は、スケーラビリティ・説明可能性・制御性の面で限界があります。さらに重要な問題として、これらの手法のほとんどはサンプル単位の最適化にとどまっており、データセット全体を設計する視点が欠けているとGoogleは指摘しています。
「機構設計」としての合成データ生成——Simulaの全体像
Googleが論文誌 Transactions on Machine Learning Research に発表したSimulaは、合成データ生成を「機構設計(Mechanism Design)」として捉え直したフレームワークです。シードデータを必要とせず、推論モデルの能力が高まるにつれて生成能力も自然に向上する「推論優先(Reasoning-first)」の設計が特徴です。
Simulaはデータ生成プロセスを4つの独立した軸に分解します。
第1軸:グローバル多様化(Global Diversification)
推論モデルがターゲットドメインの概念空間を深い階層型タクソノミー(分類体系)にマッピングします。候補サブカテゴリを「提案→評価→統合→絞り込み」するループを繰り返す「propose-and-refine」プロセスにより、人間のシードデータに依存せず密度の高い分類体系を自動構築します。これがデータセットのサンプリング土台となり、ドメインの長尾部分(レアな事例)まで網羅する基盤を提供します。
第2軸:ローカル多様化(Local Diversification)
タクソノミーのノードからシナリオ記述「メタプロンプト」を生成し、そこから複数の異なるインスタンスを出力することでモード崩壊を防ぎます。たとえば「SQLインジェクション」という概念が同一の繰り返しではなく多様なシナリオとして表現されるよう制御します。
第3軸:複雑化(Complexification)
メタプロンプトの設定可能な割合を、より精緻で難度の高い形式へ変換します。この軸はデータセットの意味的カバレッジを変えることなく難易度分布だけを独立して調整できる点が特徴です。
第4軸:品質チェック(Quality Checks)
独立した2つのクリティクモデルが出力の正誤を検証する「デュアルクリティク」ループを採用します。LLMが尤もらしい出力に同調しやすい傾向(Sycophancy・迎合性)を緩和し、高品質なラベルを確保します。
新しい評価指標:タクソノミーカバレッジとEloスコア
Googleによれば、合成データの評価は標準的な指標では実用的な改善指針が得にくいという構造的な難しさがあります。そこでSimulaでは推論ベースの2つの独自指標を導入しています。ひとつはデータセットがドメインの分類体系をどの程度網羅しているかを測る タクソノミーカバレッジ、もうひとつはLLMによるバッチ比較でチェスのレーティングに似たEloスコアをデータポイントに付与する キャリブレーション複雑度スコアリング です。これにより多様性と難易度の両面をより精緻に捉えられると考えられます。
5ドメインにわたる評価実験——「固定レシピは存在しない」
Googleによれば、評価実験ではGemini 2.5 FlashをTeacherモデル、Gemma-3 4BをStudentモデルとして使用しました。サイバーセキュリティ(CTIBenchのCTI-MCQ・CTI-RCM)、法律推論(LEXam)、数学(GSM8k)、多言語学術知識(Global MMLU)の5ドメインで、各ドメインに最大51万2,000件のデータポイントを生成して評価を実施しています。
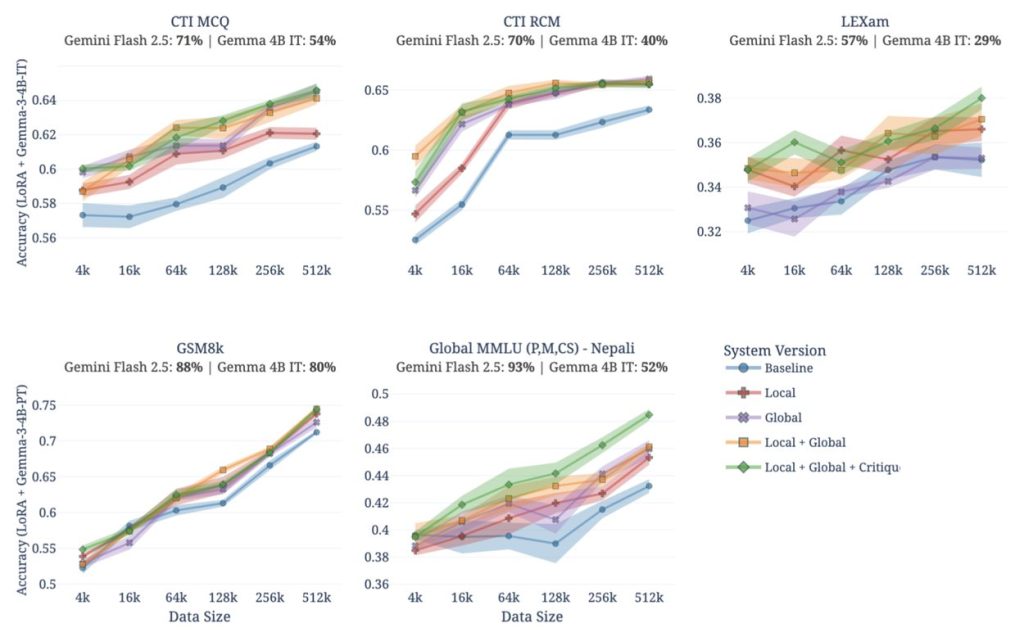
実験から得られた主な知見は3点です。第一に、全ドメインでSimulaの完全システムがシンプルなベースラインを一貫して上回ったこと。第二に、最適なデータ設定に固定レシピは存在しないことで、数学推論では複雑化によって10%の精度向上が得られた一方、法律推論ではTeacherモデルの能力がドメインに対して十分でなかったため複雑化が逆効果になったとされています。第三に、Simulaはベースラインより少ないサンプル数でより高い下流性能を達成しており、スケーリング則がデータ量だけでなくデータ特性によって駆動されるという傾向が示されました。
「最適な設定はモデルとドメインの組み合わせによって大きく変わる」というこの知見は、合成データを実用展開する際に慎重なチューニングが必要だということを示していると思います。
Google社内プロダクトへの実用展開
Simulaはベンチマーク評価にとどまらず、Google社内の本番システムに組み込まれています。GemmaエコシステムではShieldGemma(安全性フィルタリング)、FunctionGemma(関数呼び出し特化)、MedGemma(医療特化)などの学習データ基盤として活用されているほか、Geminiのオンデバイス・サーバーサイド双方の安全性分類器の主要なデータソースにもなっています。エンドユーザー向けには、AndroidのAI詐欺電話検知機能やGoogleメッセージのスパムフィルタリングにも展開されています。また、企業セキュリティ向けの現実的な攻撃シナリオ合成や、AIが地図を読む能力を習得するための構造化データセット生成など、新たな応用研究も進んでいるとされています。
まとめ
Simulaは合成データ生成を「サンプルの積み上げ」から「データセット全体の機構設計」へと転換するフレームワークです。カバレッジ・複雑さ・品質を独立して制御できる設計とシードデータ不要の推論優先アーキテクチャは、プライバシーやデータ希少性の制約が大きい専門領域のAI開発において有効な選択肢になると思います。Gemmaエコシステムへの活用事例については、本ブログの関連記事もあわせてご覧いただければと思います。