はじめに
GitHubは2026年8月4日、コーディングエージェントが生成する巨大なプルリクエストを、レビューしやすい単位に分割する「スタックPR」の活用法を公式ブログで解説しました。本稿ではgh-stack CLIを使った具体的な運用フローを紹介します。
参考記事
- タイトル: Turn one giant AI-generated pull request to a reviewable stack
- 著者: Julia Muiruri
- 発行元: GitHub Blog
- 発行日: 2026年8月4日
- URL: https://github.blog/engineering/turn-one-giant-ai-generated-pull-request-to-a-reviewable-stack/
関連記事
要点
- GitHubは巨大なAI生成プルリクエストを「スタックPR」で分割レビューする手法を2026年8月4日付のブログで解説した
- スタックPRは機能を依存関係のあるレイヤーに分解し、各レイヤーを独立してレビュー・マージできる仕組みである
- gh-stack CLIエクステンションと専用スキルをコーディングエージェントに導入することで、エージェント自身がスタックの作成・管理を行える
- レビューは「上から下へ読み、下から上へレビューする」進め方が推奨されており、下位レイヤーの修正はgh stack rebase/gh stack syncで上位に伝播できる
- Web UI上のリバースボタンはコミッターが変更され署名なしコミットになるため、署名必須の環境では注意が必要である
詳細解説
コーディングエージェント時代に肥大化するプルリクエスト
GitHubによれば、コーディングエージェントは非常に生産性が高く、Gartnerの調査では2028年までにソフトウェア開発ライフサイクルの各段階で50%の生産性向上をもたらすと予測されています。しかし、エージェントにプルリクエストの構造化そのものを委ねることはできず、人間が意思決定する必要性はむしろ高まっていると説明されています。
記事では、既存のショッピングアシスタントに商品検索機能を追加する例が紹介されています。データモデル、APIルート、UI配線までを1つのエージェントに任せると、1,000行を超える巨大な差分が一度に生成されます。レビュアーが「1,721行変更、説明も薄い。後で見る」と後回しにしてしまい、コンテキストを失ったままレビュー品質が落ち、マージがさらに遅れるという悪循環が生じると指摘されています。
この問題は、コードの生成速度が上がるほど、レビューという人間側の工程がボトルネックになりやすいことを示していると考えられます。
スタックPRという解決策
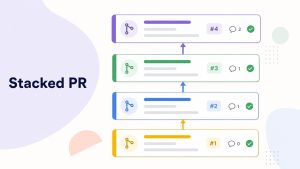
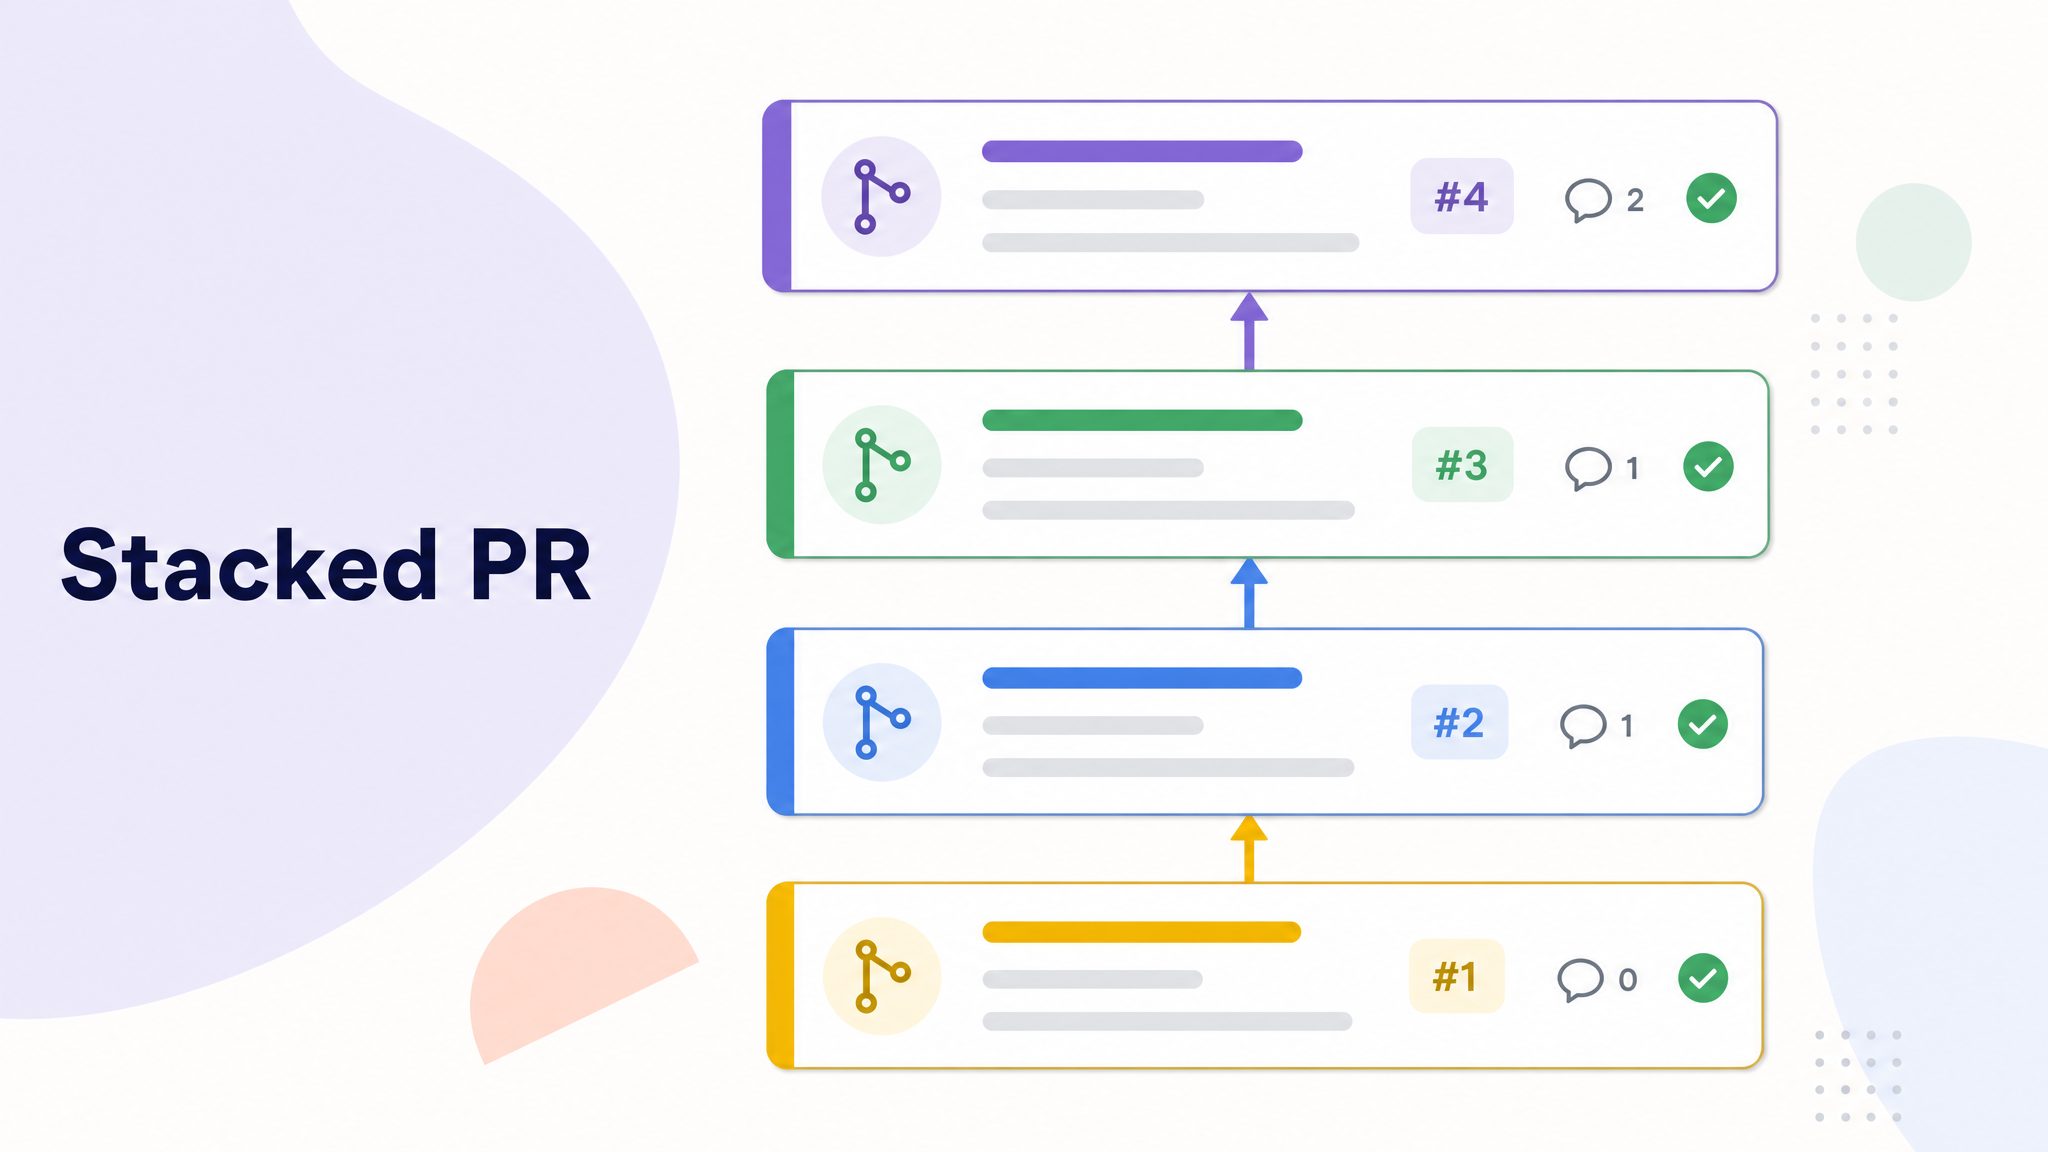
スタックPRの考え方はシンプルで、1つの巨大なプルリクエストを目指すのではなく、機能を論理的なレイヤーに分解し、依存関係の連鎖として積み上げるという発想です。GitHubの例では、商品検索機能を以下の4層に分解しています。
| レイヤー/ブランチ | 内容 | 依存先 |
| L1 (feat/catalog-data) | 型付きカタログとシードデータ、検証、データアクセス層 | main(スタックの土台) |
| L2 (feat/search-api) | 検証済みの/api/products/searchエンドポイント | feat/catalog-data |
| L3 (feat/chat-grounding) | チャットがAPIを呼び出し、実データに基づいて回答 | feat/search-api |
| L4 (feat/grounded-ui) | 商品引用カードとその状態管理 | feat/chat-grounding |
この分解により、データ・API・チャット連携・UIという関心が分離され、レイヤーごとに異なるレビュアー(データ担当者、UI担当者など)を割り当てられるようになります。専門領域に応じてレビュー対象を絞れる点は、レビュー負荷を実質的に下げる効果があると考えられます。
CLI拡張とエージェント向けスキルの導入
GitHubのスタックPR機能はプルリクエストのUIから利用できるほか、ターミナルからはgh stackというCLI拡張で操作できます。導入は次のコマンドで行います。
まず、スタックPRを操作するCLI拡張機能(gh、GitHubの公式コマンドラインツール、の追加機能)をインストールします。
gh extension install github/gh-stack次に、コーディングエージェントにスタックPRの作成・管理方法を学習させる「スキル」を導入します。スキルとは、エージェントに特定の作業手順やツールの使い方を教えるための定義ファイル群です。
gh skill install github/gh-stacknpm経由でスキルを追加したい場合は、以下のコマンドでも同じスキルを取得できます。
npx skills add github/gh-stack 記事の例では、データモデラー・バックエンド・フロントエンドという役割ごとに異なるエージェントを割り当て、各エージェントがgh init stack(新しいスタックを開始するコマンド)やgh stack add(既存スタックの上に新しいレイヤーを追加するコマンド)を使って、L1からL4までのブランチを順に作成していく流れが説明されています。すべてのレイヤーの検証が通った時点で、gh stack pushでリモートに反映し、gh stack submitでスタック内の各プルリクエストをまとめて作成します。
なお、参考記事のサンプルコマンドをもとにしており、実際の挙動は利用するgh-stackのバージョンによって変わる可能性があるため、導入前に公式ドキュメントで最新の仕様を確認することをおすすめします。
レビューと更新のワークフロー
スタックが提出されると、各プルリクエストの上部に「スタックマップ」というレイヤー間を1クリックで移動できるナビゲーションが表示されます。GitHubは、レビューの進め方として「上から下へ読み、下から上へレビューする」という方向性を推奨しています。まず最上位のプルリクエストを見て全体のゴールを把握し、その後最下位のレイヤーから順にレビューしていくという流れです。
最下位レイヤーで修正依頼が発生した場合、修正が反映されてmainが更新されると、GitHubは他のレイヤーが「分岐しており再構成(リベース)が必要」であることを自動的に検知し、スタックとしてのマージをブロックします。
ここで注意が必要な点として、GitHubのプルリクエストUI上に表示される「Rebase stack」ボタンは、GitHubのサーバー上でリベースを実行するため、コミッターがボタンを押した人物に変わり、結果として生成されるコミットは署名なしになります。ブランチ保護ルールで署名付きコミットを必須にしている場合、このボタン操作によって意図せずルールに抵触する可能性があると考えられます。より安全な方法として、ターミナルからgh stack rebaseを実行し、自分のGit設定を使ってローカルでリベースを行い、その後gh stack pushで反映する手順が案として示されています。
残りのレイヤーへの反映はgh stack syncで一括して行えます。このコマンドは、originからのフェッチ、変更のあったブランチより上位すべてのリベース、リベース後のブランチのプッシュ、GitHub側のプルリクエスト状態の同期までを一度に実行するとされています。手動でレイヤーごとに同期作業を行う必要がなくなる点は、スタックPR運用の実用面での利点だと思います。
まとめ
巨大なAI生成PRをレビューしやすい単位に分割する取り組みは、コーディングエージェントの活用が広がるほど重要な論点になっていくと考えられます。コードレビューのルール設計に関心のある方は、こちらの記事もあわせてご覧ください。