はじめに
Google DeepMindが2026年3月10日、テキスト・画像・音声・動画・ドキュメントを単一の埋め込み空間に統合できるモデル「Gemini Embedding 2」をパブリックプレビューとして公開しました。本稿では、その機能と対応モダリティ、性能、実装方法について解説します。
参考記事
- タイトル: Gemini Embedding 2: Our first natively multimodal embedding model
- 著者: Min Choi(Product Manager, Google DeepMind)、Tom Duerig(Distinguished Engineer, Google DeepMind)
- 発行元: Google Blog
- 発行日: 2026年3月10日
- URL: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-embedding-2/

要点
- Gemini Embedding 2は、テキスト・画像・動画・音声・PDFを単一の埋め込み空間にマッピングする、Geminiアーキテクチャを基盤とした初の本格的マルチモーダル埋め込みモデルである
- テキストは最大8192トークン、画像は1リクエストあたり最大6枚、動画は最大120秒、PDFは最大6ページに対応しており、複数モダリティを1リクエストで混在入力できる
- Matryoshka Representation Learning(MRL)により出力次元を柔軟に調整でき、デフォルトの3072から1536・768へのスケールダウンが可能である
- テキスト・画像・動画タスクのベンチマークで既存モデルを上回る性能を記録しており、音声の埋め込みにも対応する
- Gemini APIおよびVertex AI経由でパブリックプレビューとして提供されており、LangChainやLlamaIndexなど主要フレームワークからも利用できる
詳細解説
マルチモーダル埋め込みモデルとは
埋め込み(Embedding)とは、テキストや画像などのデータを高次元の数値ベクトルに変換し、意味的な類似性を計算可能にする技術です。検索エンジンやRAG(Retrieval-Augmented Generation)、レコメンデーションシステムなど、幅広いAIアプリケーションの基盤として使われています。
従来の埋め込みモデルの多くはテキスト専用か、モダリティごとに別々のモデルを用意する構成でした。Gemini Embedding 2はGeminiアーキテクチャを活用し、テキスト・画像・動画・音声・ドキュメントをひとつの統一された埋め込み空間にマッピングすることで、この分離を解消しています。異なるモダリティ間での意味的な類似度計算や横断検索が、単一のモデルで実現できる点が大きな特徴と言えます。
対応モダリティと入力仕様
Google DeepMindの発表によれば、Gemini Embedding 2が対応する入力は次のとおりです。
- テキスト: 最大8192トークンの長文コンテキストに対応し、100言語以上の意味的理解をサポート
- 画像: 1リクエストあたり最大6枚、PNG・JPEGフォーマットに対応
- 動画: 最大120秒、MP4・MOVフォーマットに対応
- 音声: 中間的なテキスト書き起こしを介さず、音声データをそのまま埋め込みに変換
- ドキュメント: 最大6ページのPDFを直接処理
さらに、これらの複数モダリティを1つのリクエストに混在させたインターリーブ入力が可能です。たとえば、画像とテキストを組み合わせて送信することで、両者の複雑な関係を捉えた埋め込みを得られます。単純な「テキスト+画像」の組み合わせでは捉えにくいニュアンスを扱う場合に有効と考えられます。
Matryoshka Representation Learningによる柔軟な次元調整
出力ベクトルの次元数は、Matryoshka Representation Learning(MRL) という技術によって柔軟に調整できます。MRLは情報を「入れ子構造」で表現することで、次元数を削減しても品質をなるべく保持できる仕組みです。
デフォルトの出力次元数は3072で、1536・768へのスケールダウンが推奨されています。次元数が小さいほどストレージコストや計算コストを抑えられるため、用途やリソースに応じたトレードオフの選択が可能です。大規模なデータセットを扱う場合には、精度とコストのバランスを確認しながら次元数を決定することが重要だと思います。
ベンチマーク性能と実導入事例
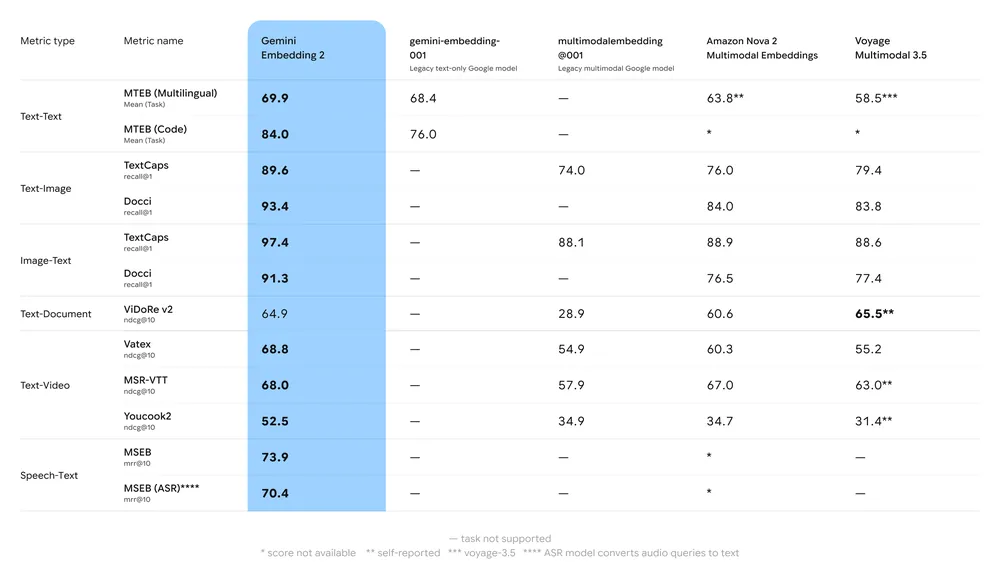
Google DeepMindによれば、Gemini Embedding 2はテキスト・画像・動画タスクの複数ベンチマークで既存の主要モデルを上回る性能を記録しており、音声埋め込みにも対応した点で新たな性能水準を示しています。
実導入事例として、法律テクノロジー企業のEverlawが訴訟における証拠開示プロセスでの活用を紹介しています。同社CTOのMax Christoff氏は、数百万件の記録を対象とした精度・再現率の向上に加え、画像や動画を含む新たな検索機能が実現できたと述べています。法的文書のような高精度が求められる場面での活用可能性を示す事例と言えます。
実装方法と対応エコシステム
Gemini Embedding 2は、Gemini APIおよびVertex AI経由でパブリックプレビューとして利用できます。Pythonでの基本的な使い方は以下のとおりです。
from google import genai
from google.genai import types

client = genai.Client()

with open("example.png", "rb") as f:
    image_bytes = f.read()

with open("sample.mp3", "rb") as f:
    audio_bytes = f.read()

result = client.models.embed_content(
    model="gemini-embedding-2-preview",
    contents=[
        "What is the meaning of life?",
        types.Part.from_bytes(data=image_bytes, mime_type="image/png"),
        types.Part.from_bytes(data=audio_bytes, mime_type="audio/mpeg"),
    ],
)

print(result.embeddings)
主要なフレームワーク・ベクトルデータベースとの統合も整備されており、LangChain、LlamaIndex、Haystack、Weaviate、QDrant、ChromaDB、Vertex AI Vector Searchから利用できます。既存のRAGパイプラインやセマンティック検索システムに組み込む際、これらのエコシステムを通じて比較的スムーズに導入できると考えられます。また、動作を確認したい場合は、公式のマルチモーダルセマンティック検索デモ(findmemedia.lmm.ai)が公開されています。
まとめ
Gemini Embedding 2は、テキスト・画像・音声・動画・PDFを単一の埋め込み空間に統合し、モダリティをまたいだ検索や分類を1つのモデルで実現します。RAGや大規模データ管理への応用が見込まれ、今後の活用事例の広がりが注目されます。