はじめに
Googleは2026年3月3日、Gemini 3シリーズの新モデル「Gemini 3.1 Flash-Lite」を発表しました。同シリーズで最速・最低コストを実現したこのモデルは、大量処理ワークロードを抱える開発者向けに設計されています。本稿では、発表内容をもとに性能・コスト・活用シナリオを解説します。
参考記事
- タイトル: Gemini 3.1 Flash-Lite: Built for intelligence at scale
- 著者: The Gemini Team
- 発行元: Google Blog
- 発行日: 2026年3月3日
- URL: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-1-flash-lite/
要点
- Gemini 3.1 Flash-LiteはGemini 3シリーズで最速・最低コストのモデルで、大量処理ワークロード向けに設計されている
- 価格は入力100万トークンあたり$0.25、出力100万トークンあたり$1.50で、前世代の2.5 Flashより2.5倍速く最初のトークンを出力できる(Artificial Analysis調べ)
- GPQA Diamondで86.9%、MMMU Proで76.8%を記録し、同価格帯の競合モデルを上回る性能を持つ
- 「シンキングレベル」を標準搭載し、タスクの複雑さに応じてモデルの推論量を開発者が調整できる
- Google AI StudioおよびVertex AI経由でプレビュー提供が開始されている
詳細解説
Gemini 3.1 Flash-Liteとは
Googleが2026年3月3日に発表した「Gemini 3.1 Flash-Lite」は、Gemini 3シリーズにおける最速・最低コストのモデルです。高頻度・大規模なワークロードを抱える開発者を主な対象として設計されており、Google AI StudioおよびVertex AIを通じてプレビュー提供が開始されています。
Geminiシリーズでは用途や処理能力に応じて複数のモデルが展開されており、Flash-Liteというポジションは「コスト効率を優先しながらも一定の品質を維持する」という位置づけです。前世代の2.5 Flash-Liteと比較して、今回は推論能力と処理速度の両面で改善が図られています。
コスト効率と処理速度
Googleによれば、価格設定は入力100万トークンあたり$0.25、出力100万トークンあたり$1.50です。Artificial Analysisのベンチマークでは、前世代の2.5 Flashと比較して最初のトークンが出力されるまでの時間(Time to First Answer Token)が2.5倍短縮され、出力速度も45%向上しています。
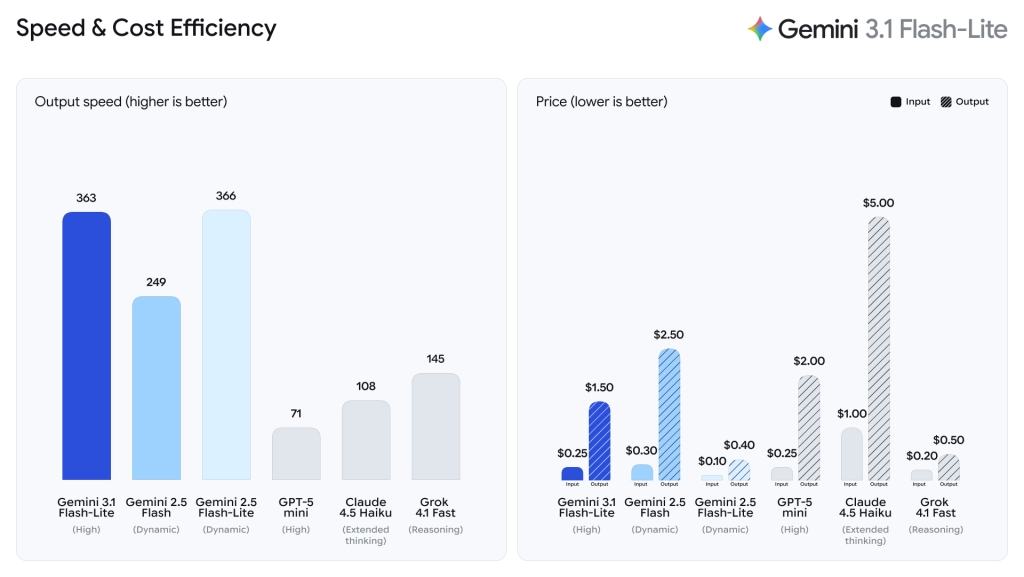
この低レイテンシの特性は、ユーザーの操作に即座に応答することが求められるリアルタイムアプリケーションや、大量のリクエストを処理するサービスにとって重要な要素と考えられます。翻訳やコンテンツモデレーションのような高頻度タスクでは処理速度と単価の両方が運用コストに直結するため、今回の改善は実用上の意義が大きいと言えます。
ベンチマーク性能
Arena.aiリーダーボードではEloスコア1432を記録しています。Googleの発表によれば、GPQA Diamondで86.9%、MMMU Proで76.8%を達成しており、同価格帯の競合モデルを上回るだけでなく、前世代の大型モデルである2.5 Flashをも超えています。
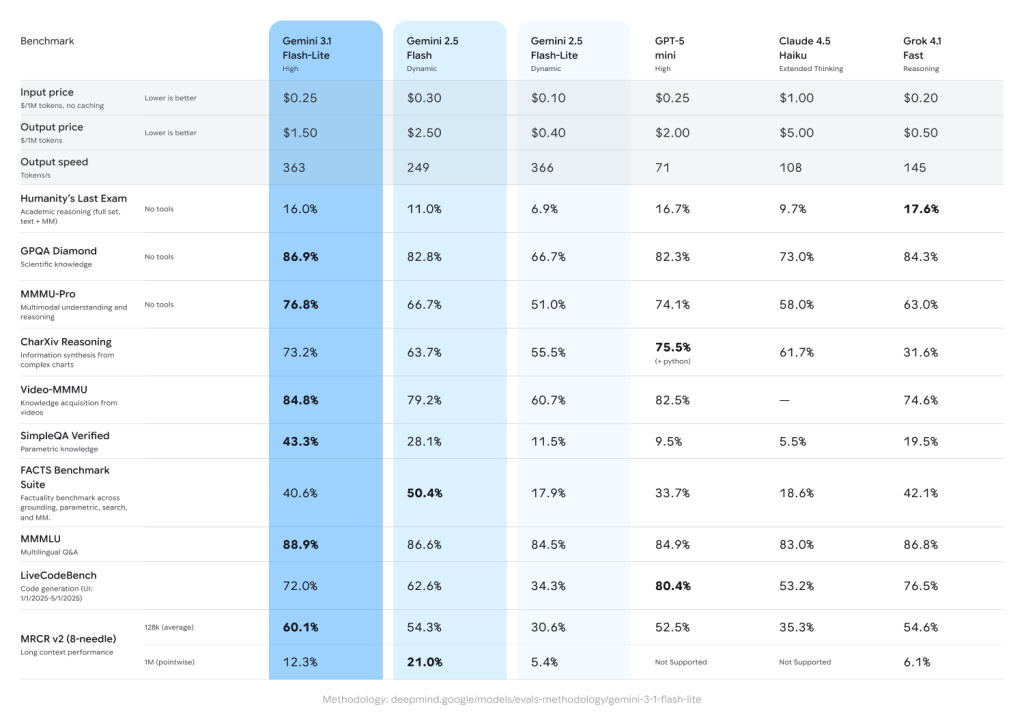
GPQA Diamondは大学院レベルの科学的推論を問う評価指標で、単純な情報検索ではなく多段階の論理的思考を要します。MMMU Proはテキストと画像を組み合わせた多モーダル理解を測る指標です。軽量モデルとしてはいずれも高い水準の結果であると考えられますが、ベンチマークの数値が実際の業務タスクにそのまま当てはまるとは限らないため、用途ごとの検証が重要だと思います。
「シンキングレベル」機能と活用シナリオ
3.1 Flash-Liteには、AI StudioおよびVertex AIで「シンキングレベル」機能が標準搭載されています。これはモデルが「どの程度考えるか」を開発者が調整できる仕組みで、シンプルな処理では素早く回答を返し、複雑な処理ではより多くの推論ステップを踏むという使い分けが可能になります。コスト管理の観点からも、思考量を適切にコントロールできることは高頻度ワークロードにおいて有用と考えられます。
Googleが想定するユースケースは多岐にわたります。大量翻訳やコンテンツモデレーションといったコスト優先の処理から、UIやダッシュボードの自動生成、シミュレーションの作成、複雑な指示への対応まで、幅広い用途が挙げられています。すでにLatitude、Cartwheel、Wheringなどの企業が早期アクセスで利用しており、Googleによれば「大規模モデルに匹敵する精度で複雑な入力を処理できる」という評価も寄せられているとのことです。
まとめ
Gemini 3.1 Flash-Liteは、コスト効率と処理速度を重視しながら推論力も引き上げた軽量モデルです。シンキングレベルによる柔軟な制御も加わり、大量処理が前提の開発環境における選択肢として注目されます。実際の業務への適合度は検証が必要ですが、今後の活用例が増えるにつれてその実力がより明確になると思います。