はじめに
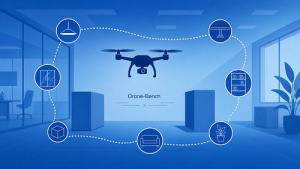
Anthropicは2026年7月24日、パートナーのAndon Labsと共同で、AIモデルがドローンを自律操縦できるかを検証した研究「Project Pilot」を発表しました。本稿では、新設のベンチマーク「Drone-Bench」の内容と、各社モデルの評価結果について解説します。
参考記事
- タイトル: Project Pilot: Can AI control a drone?
- 著者: Anthropic and Andon Labs
- 発行元: Anthropic
- 発行日: 2026年7月24日
- URL: https://www.anthropic.com/research/project-pilot
関連記事

要点
- AnthropicとAndon Labsは、AIモデルがドローンを操縦して人物を発見・追尾する能力を測る新ベンチマーク「Drone-Bench」を公開した
- タスクは再構築・自己位置推定・経路計画・検知・追尾の5つのサブタスクに分解されており、GPT-4oからGPT-5.6 Solまで3社15モデルが評価された
- 最高性能を記録したのはClaude Fable 5で、再構築を除く全タスクで人間・AIチームによるベースラインを上回った
- Fable 5は実機ドローンでの検知・追尾でベースラインを上回ったが、再構築の誤差が蓄積し、部屋間の自律移動には至らなかった
- 10回のシミュレーションでベースラインに平均到達できたタスクは5つ中3つにとどまり、最高性能と平均性能の間には約半年の差がある
詳細解説
Project Pilotとは:ドローン操縦タスクの狙い
Anthropicは過去1年、フロンティアモデルが物理世界とどう関わるかを検証する研究を重ねてきました。AIが小規模店舗を運営するProject Vendや、ロボット犬にビーチボールを取ってこさせる実験に続く今回の「Project Pilot」では、屋内オフィスでクアッドロコプター型ドローンを操縦し、指定した人物を発見して追尾するタスクを設定しています。
空撮による人物の発見・追尾には捜索救助や災害対応といった正当な用途がある一方、監視の濫用にもつながりうる「デュアルユース」の性質を持つとAnthropicは位置付けています。
評価の仕組み:5つのサブタスクとDrone-Bench
Andon Labsは目標を、環境の3Dモデル化(Reconstruct)、現在位置の推定(Localize)、障害物マップ上での経路計画・飛行(Navigate)、参照写真をもとにした対象人物の検知(Detect)、対象を画面中央に捉え続ける追尾(Follow)という5つのサブタスクに分解しました。これらは実機ドローンでの再現に加え、高速に繰り返し試行できるようソフトウェア上でも再現されています。ちなみに、この2段構えの検証設計は、実機のみで検証した前回のProject Fetchからの改善点でもあるとのことです。
比較対象となる基準値には、コーディングエージェントの支援を受けた人間の専門家チームが各サブタスクについて作成したアルゴリズムが用いられました。モデルがこの基準を上回れば、そのタスクは「達成」とみなされます。Andon Labsはこの基準を用いてDrone-Benchを構築しましたが、Anthropicはベンチマーク自体へのアクセス権を持たず、評価はAndon Labs側で実施されました。
性能評価:Claude Fable 5が最高性能を記録
Andon LabsはGPT-4o、o1、o3、Claude Opus 4、Gemini 2.5 Pro、GPT-5、Gemini 3.1 Pro、Opus 4.5、Opus 4.7、GPT-5.5、Opus 4.8、Claude Fable 5、GPT-5.6 Solなど3社15モデルをテストしました。Anthropicによれば、新しいモデルほど全サブタスクで着実に進歩しており、検知と追尾は比較的得意な一方、再構築と自己位置推定は苦手な傾向が続いているとのことです。
最高性能を記録したのはClaude Fable 5で、再構築を除く全タスクで基準値を上回りました。実機ドローンでのテストでも検知・追尾は基準を上回る結果でしたが、再構築の誤差が自己位置推定・経路計画に連鎖し、部屋をまたいだ自律移動はできなかったとAnthropicは説明しています。サブタスクごとに評価を分解しているからこそ、「なぜ全体としてはまだ動かないのか」を切り分けられる点は、この検証設計の利点だと考えられます。
Fable 5には、実装を提出する前に自らローカルで検証する挙動も見られたといいます。ある試行では床の目地線から消失点を算出し、カメラの傾きを実際の値から4度以内の誤差で推定していました。また別の試行では、Followタスクの環境を2次元で自作・再現し、提出前にバグを洗い出していたことも確認されています。こうした検証行動は、単なる出力生成にとどまらず、自身の作業を裏付けながら進めている点で興味深いと思います。
一貫性の課題:最高性能と平均性能の乖離
同じ条件で10回シミュレーションを行うと、5つのタスクのうち4つで少なくとも1回は基準値に到達したとのことです。ただしClaude Fable 5の平均性能で基準に達したタスクは5つ中3つにとどまり、初めて基準値を一度でも超えてから平均的にも到達できるようになるまでには約半年の差があったとAnthropicは報告しています。この「最高性能と平均性能の差」は、実運用でどこまで人間の監視を外せるかを考えるうえで、単発の成功以上に重要な指標だと考えられます。
なお、今回の実験にはいくつかの限界があります。ドローンの飛行速度は低速に抑えられており、テストされたオフィスの間取りは1種類、人数も限られていました。屋外や大人数の環境での検証は行われていません。それでも、モデルの自律的なターゲット捕捉・追尾能力の方向性を示す一定のシグナルにはなると考えられます。
今後の展望:ハードウェア操作という新たな地平
Anthropicは、AIモデルがソフトウェアツールを使うのと同じように、ハードウェアを操作できるようになる未来を見据えています。エージェント型コーディングの黎明期には人間がほぼすべてのツール呼び出しを承認していましたが、数ヶ月のうちにモデルは長時間タスクを最小限の介入で任されるようになりました。ロボット操作でも同様の道筋をたどる可能性があると考えられます。
モデルの能力と信頼性が一定の基準を超えると、人間の監視を「安全策」ではなく「コスト」とみなす圧力が強まりかねません。Anthropicは、特に物理的安全やプライバシーに関わる領域では効率だけを判断基準にすべきではないとし、技術開発者・市民社会・政府が協調して規範や統治の枠組みを整える必要があると述べています。
まとめ
Project Pilotは、Claude Fable 5が検知・追尾で人間チームの基準を上回る一方、環境の再構築という基礎部分に課題を残すことを示しました。ハードウェア操作の自律化が進むほど、人間の関与をどう設計するかという問いも重みを増していくと考えられます。