はじめに
OpenAIが2026年5月28日、同社の安全性・セキュリティ管理の実践が法的要件とどのように対応しているかを説明した公式文書「Frontier Governance Framework(フロンティアガバナンスフレームワーク、以下FGF)」を公開しました。本稿では、このFGFが定める4つのリスク領域・段階評価システム・ガバナンス体制の内容を解説します。
参考記事
- タイトル: OpenAI’s Frontier Governance Framework
- 著者: OpenAI
- 発行元: OpenAI公式
- 発行日: 2026年5月28日
- URL: https://openai.com/index/openai-frontier-governance-framework/
関連情報:
- タイトル: Frontier Governance Framework(全文PDF)
- 発行元: OpenAI
- 発行日: 2026年5月28日
- URL: https://cdn.openai.com/pdf/e37d949b-8c9f-4d76-b99e-4272f4631a7e/openai-frontier-governance-framework.pdf
関連記事
要点
- OpenAIは既存の「Preparedness Framework」を補完する形で、法的義務を対外的に文書化した「Frontier Governance Framework」を公開した
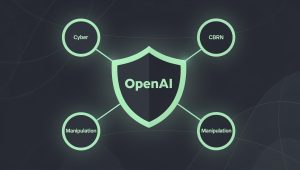
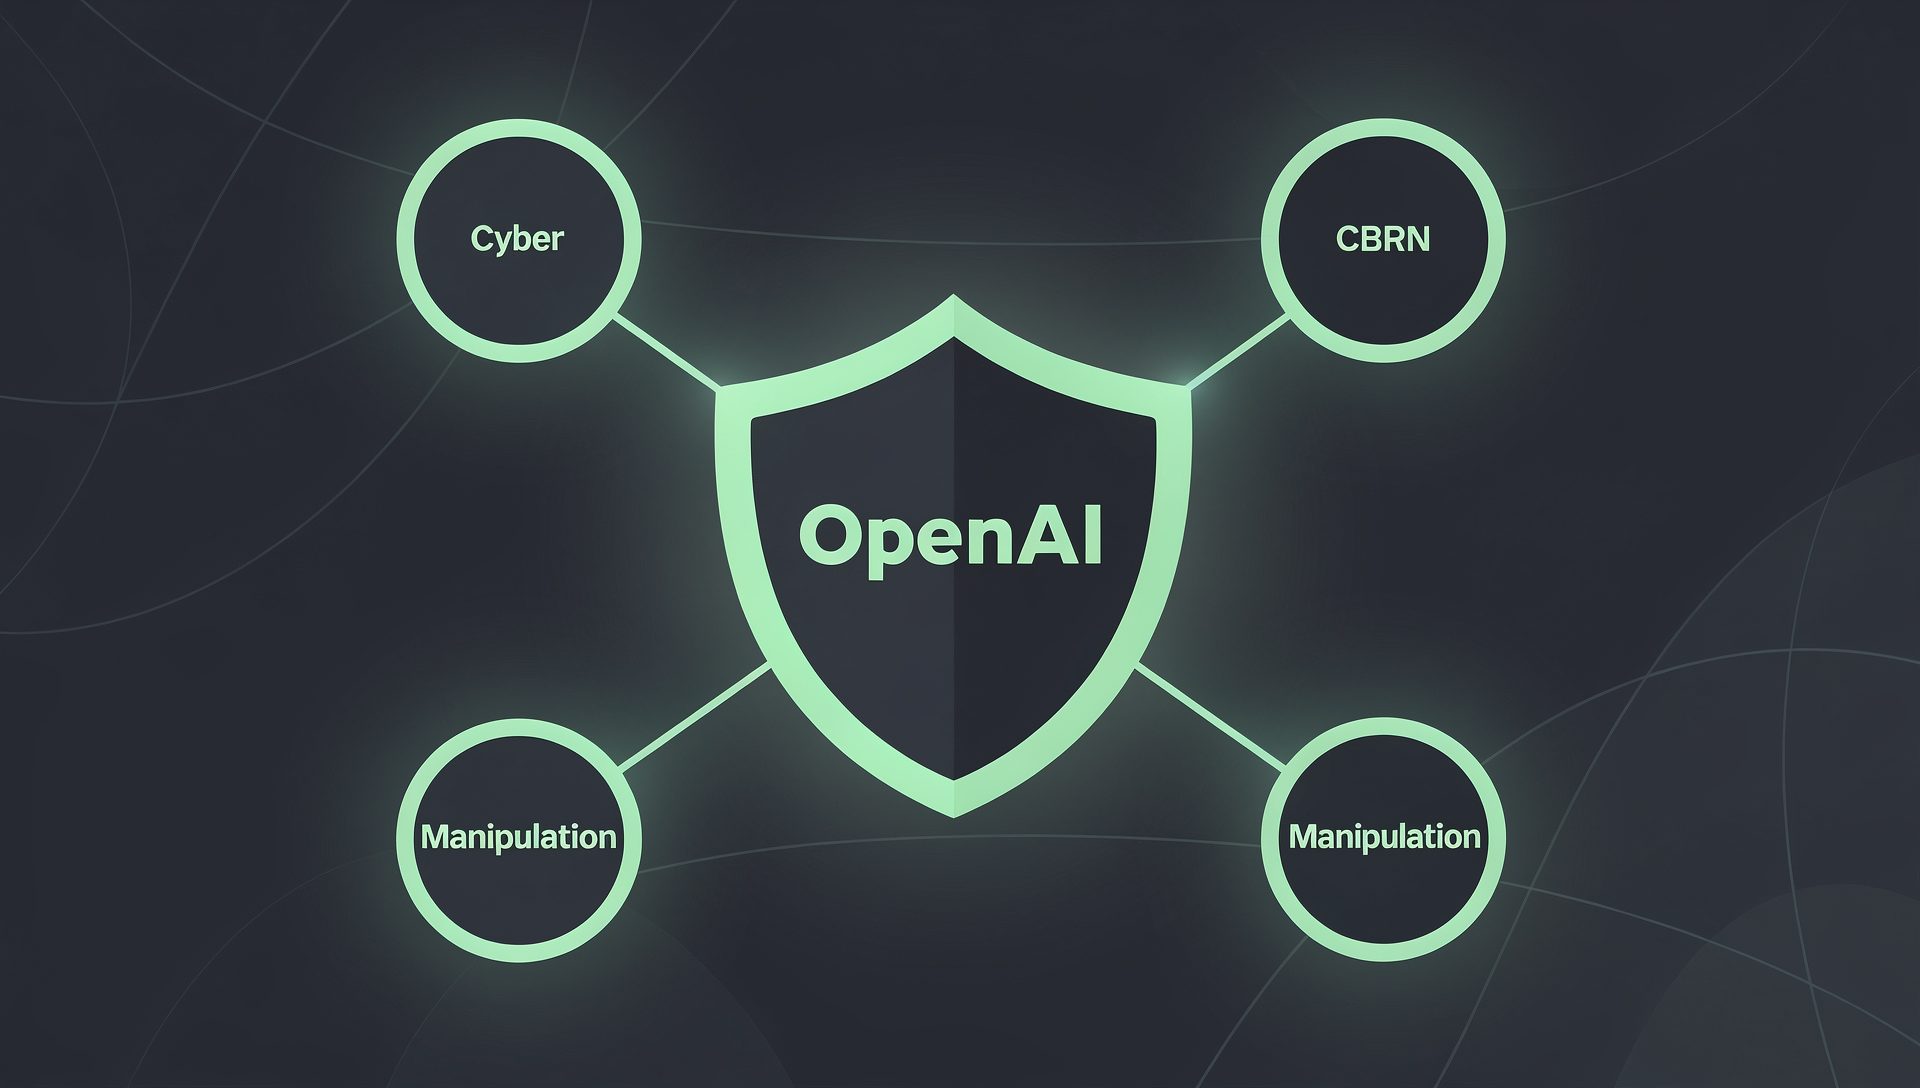
- 対象リスクは「サイバー攻撃支援」「CBRN(化学・生物・放射線・核)」「有害な操作・影響工作」「制御喪失」の4領域で、それぞれ3段階のリスク層で評価される
- 米カリフォルニア州「Transparency in Frontier AI Act(TFAIA)」とEU AI法の「汎用AIモデルの実践規範(Code of Practice)」双方に対応した文書として設計されている
- モデル展開前にリスクが許容範囲を超えると判断された場合は、追加の緩和策なしに展開しないと明記されている
- 外部専門家からの意見収集、年1回以上のフレームワーク評価、重大な変更は30日以内に公表という更新体制も定められている
詳細解説
FGFの位置づけ——Preparedness Frameworkとの関係
OpenAIによれば、FGFは既存の「Preparedness Framework(PF)」と重複する部分を持ちながら、異なる目的で機能します。PFは社内における最も深刻なリスクへの対処方法を定義・運用するための内部文書であり、法的要件を超えた独自基準を含みます。一方FGFは、その内容を対外的な規制文書として整理したものと説明されています。
具体的には、FGFはカリフォルニア州TFAIAにおける「Frontier AI Framework」、そしてEU AI法における「安全・セキュリティフレームワークの公開サマリー」として機能します。規制ごとに対応文書を個別に作成するのではなく、1つの統合文書で複数の法的要件を満たす設計となっている点が特徴的だと思います。
4つのリスク領域と3段階評価
FGFが管理の対象とするシステミックリスク(制度的・社会的規模の重大リスク)は以下の4つです。
サイバー攻撃支援(Cyber offense):大規模な高度サイバー攻撃を可能にするリスク。攻撃者への参入障壁を大幅に下げたり、攻撃の影響を増大させたりする能力が評価されます。
CBRN:化学・生物・放射線・核兵器の開発や使用を支援するリスク。OpenAIによれば、生物・化学脅威を優先的に評価しており、特に生物脅威を最も深刻なカテゴリとして位置づけています。核・放射線については情報へのアクセス制限や物理的障壁が大きいため、引き続き脅威モデルの研究を継続する方針とされています。
有害な操作(Harmful manipulation):世論操作・選挙干渉・民主的プロセスの破壊といった、人間の行動を戦略的に歪めるリスク。OpenAIはこの領域をまだ探索段階と位置づけており、モデル展開前の評価よりも展開後のモニタリングで対処する方針を示しています。
制御喪失(Loss of control):モデルの修正・停止・制御ができなくなるリスク。自律的な行動や人間への欺瞞行為、開発者の管理から逃れる能力などが評価されます。
これらの各リスクカテゴリに対し、Tier 1〜Tier 3の3段階で能力レベルが定義されています。サイバー攻撃支援を例に取ると、Tier 1が「公開情報の提供や既知の攻撃手法への支援」、Tier 2が「ゼロデイ脆弱性の自動発見や組織的サイバー攻撃の自動化への支援」、Tier 3が「堅牢なシステムへの完全自律的な新規サイバー攻撃の実行」に相当します。これらのティアは、リスクが「許容範囲か否か」を判断する基準として機能し、展開判断の根拠となります。
リスク評価と展開判断のプロセス
OpenAIによれば、リスク評価はモデルのライフサイクル全体——開発中・展開後——を通じて実施されます。評価には、モデルのベンチマーク試験のほか、外部研究者の知見、過去の展開モデルから得られた情報、重大インシデントの調査などが含まれます。
特に注目されるのは、閾値判断に関する方針です。「新しいリスク層に達していないとは言い切れない」という状況では、直接的な証拠がなくても閾値を超えたとみなして対処すると明記されています。一時点での評価結果は能力の「下限」であり「上限」ではないという前提に立ち、現実の利用・悪用の中でより高い能力が発現しうると考えている点は、安全マージンの取り方として堅実だと思います。
評価の結果、リスクが許容レベルを超えると判断されれば、追加の緩和策を実装するまでモデルは展開されません。また、残留リスクが許容範囲内であっても、「その判断が成立しなくなる条件」を文書化しておくことが求められています。
セキュリティ管理とモデル報告
セキュリティ面では、ISO 27001をはじめとする情報セキュリティ標準への準拠が明記されています。モデルの重み(パラメータ)は暗号化・アクセス制御・継続的モニタリングで保護され、ペネトレーションテストやSOC 2 Type II監査なども実施されています。
モデル報告については、対象モデルのリスク評価結果を「Safety and Security Model Report」として文書化します。OpenAIによれば、最も能力の高いフロンティアモデルについては少なくとも6か月に1度の更新を行い、能力の大幅変化や重大インシデントが発生した場合には随時更新するとされています。
ガバナンス体制と更新プロセス
FGFの更新・承認プロセスについても、詳細が定められています。重要な変更は取締役会の安全・セキュリティ委員会に報告され、承認後30日以内に公表するという体制です。また、年1回以上の「フレームワーク評価」を実施し、法規制の変化・モデル能力の変化・業界ベストプラクティスの更新などを反映させることとされています。
責任の帰属については、米国でのTFAIA対応はOpenAI OpCo LLCが、EU AI法対応はOpenAI Ireland Limitedが担うという組織的な割り当ても明示されています。
まとめ
OpenAIのFGFは、社内基準として運用してきた安全性管理を、カリフォルニア州法とEU AI法という具体的な法的枠組みに対応させた公式文書です。4領域のリスクを3段階で評価し、閾値を超えた場合の展開停止ルールや定期的な文書更新体制を定めている点で、他社の安全性フレームワークとの比較においても注目に値する内容だと思います。AI規制が各国で具体化していく中で、こうした対外的な透明性確保の動きが今後どのように広がるか、引き続き注目していきたいところです。