はじめに
NVIDIAは2026年4月2日、GoogleのオープンモデルファミリーGemma 4をNVIDIA GPU向けに最適化したことを発表しました。本稿では、対応モデルの種類と特徴、ローカル環境への導入方法、そしてエージェントAI活用の可能性について解説します。
参考記事
- タイトル: From RTX to Spark: NVIDIA Accelerates Gemma 4 for Local Agentic AI
- 著者: Michael Fukuyama
- 発行元: NVIDIA Blog
- 発行日: 2026年4月2日
- URL: https://blogs.nvidia.com/blog/rtx-ai-garage-open-models-google-gemma-4/
要点
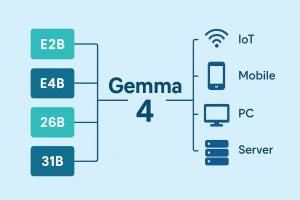
- Gemma 4ファミリーはE2B、E4B、26B、31Bの4バリアントで構成され、エッジデバイスからハイパフォーマンスGPUまで幅広い環境に対応している
- GoogleとNVIDIAが共同でGemma 4をNVIDIA GPU向けに最適化し、RTX PC、DGX Spark、Jetson Orin Nanoなどで効率的に動作する
- 推論、コーディング、エージェント(関数呼び出し)、マルチモーダル(画像・動画・音声)、35言語以上の多言語対応など多岐にわたる機能を備えている
- Ollama、llama.cpp、Unslothを通じてローカル環境への導入が可能で、Unslothはday-oneサポートを提供している
- OpenClawと組み合わせることで、個人のファイルやワークフローを参照するローカルエージェントの構築が可能になる
詳細解説
Gemma 4ファミリーの構成
Gemma 4ファミリーにはE2B、E4B、26B、31Bの4つのモデルバリアントが含まれています。E2BとE4Bはエッジデバイス向けに設計された超低遅延・超効率モデルで、Jetson Nanoモジュールを含む多くのデバイス上で完全オフライン動作が可能です。ほぼゼロレイテンシでの推論が実現されており、クラウドへのアクセスが難しい環境でも安定して機能します。
一方、26Bと31Bモデルは高性能な推論と開発者中心のワークフローを念頭に設計されており、エージェントAIの用途に適しているとされています。NVIDIAによれば、これらのモデルはRTX GPUとDGX Spark上で効率よく動作し、開発環境、コーディングアシスタント、エージェント駆動のワークフローを支えます。モデルサイズとユースケースをこのように分類する設計は、デプロイ先のリソースに応じて最適なモデルを選択できるという点で実用的と考えられます。
対応する機能とマルチモーダル対応
Gemma 4の新世代モデルが対応するタスクは多岐にわたります。NVIDIAのブログでは以下の機能が挙げられています。
- 推論: 複雑な問題解決における高い性能
- コーディング: 開発ワークフロー向けのコード生成・デバッグ
- エージェント: 構造化されたツール利用(関数呼び出し)のネイティブサポート
- ビジョン・動画・音声: 物体認識、自動音声認識、ドキュメント・動画解析
- インターリーブドマルチモーダル入力: テキストと画像を任意の順序で1つのプロンプト内に混在させることが可能
- 多言語対応: 35言語以上をすぐに利用でき、140言語以上で事前学習済み
関数呼び出し(Function Calling)は、AIエージェントが外部ツールやAPIを自律的に呼び出す際に必要な機能です。これがネイティブでサポートされることにより、ローカル環境でのエージェント構築において柔軟な設計が可能になると思います。
NVIDIA GPUでの最適化の仕組み
NVIDIAによれば、Gemma 4をNVIDIA GPU上で実行することで最適なパフォーマンスが得られます。その主な理由として2点が挙げられています。1点目は、NVIDIA Tensor CoreがAI推論ワークロードを高速化し、ローカル実行においてより高いスループットと低いレイテンシを実現することです。2点目は、CUDAソフトウェアスタックが主要なフレームワークやツールとの広範な互換性を確保しており、新しいモデルを初日から効率的に動かすことができることです。
この組み合わせによって、Gemma 4はJetson Orin NanoからRTX PC、ワークステーション、DGX Sparkまで、大規模な追加最適化なしにスケールできるとしています。Tensor CoreはNVIDIA GPUに搭載された演算ユニットで、行列演算を高速処理することでAI推論の効率を高める役割を担っています。
ローカル環境への導入方法
Gemma 4をローカルで利用するための主な方法として、NVIDIAはOllamaおよびllama.cppと連携し、各モデルに対して最適なデプロイ体験を提供しています。具体的には、Ollamaをダウンロードしてモデルを実行する方法と、llama.cppをインストールしてHugging FaceのGemma 4 GGUFチェックポイントと組み合わせる方法があります。
加えて、Unslothはday-oneサポートとして最適化・量子化済みモデルを提供しており、Unsloth Studioを通じた効率的なローカルファインチューニングとデプロイが可能です。OllamaはターミナルからシンプルなコマンドでLLMを管理できるツールであり、llama.cppはCPU・GPU双方で動作する軽量な推論エンジンです。これらのツールにより、専門的なインフラ構築の知識がなくても試しやすい環境が整っていると思います。
OpenClawとローカルエージェントAIの活用
NVIDIAのブログでは、ローカルエージェントAIの具体的な活用事例も紹介されています。OpenClawはRTX PC、ワークステーション、DGX Spark上で常時稼働するAIアシスタントを実現するアプリケーションで、Gemma 4の最新モデルと互換性があります。個人のファイル、アプリケーション、ワークフローからコンテキストを取得してタスクを自動化するローカルエージェントの構築が可能です。
同ブログではGTC 2026での関連発表も紹介されています。ローカルエージェント向けの新オープンモデルとして、NVIDIA Nemotron 3 Nano 4BおよびNemotron 3 Super 120Bが公開されました。また、OpenClaw体験をセキュリティ強化とローカルモデル対応によって最適化するオープンソーススタック「NVIDIA NemoClaw」も発表されています。さらに、Accomplish.aiが発表したAccomplish FREEは、APIキー不要でNVIDIA GPUを活用してオープンウェイトモデルをローカル実行できるデスクトップAIエージェントで、ハイブリッドルーターがローカルRTXとクラウド間のワークロードを動的に調整する仕組みを持っています。
まとめ
GoogleとNVIDIAの協力によって、Gemma 4ファミリーはRTX PCからエッジデバイスまでローカルで動作するようになりました。OllamaやUnslothによる手軽な導入環境とエージェント・マルチモーダル機能の充実により、ローカルAI活用の選択肢が広がっています。