はじめに
Metaが2025年12月16日、複雑な音声から特定の音を分離する統合AIモデル「SAM Audio」を公開しました。テキスト・映像・時間範囲という3種類の直感的なプロンプトで音を指定でき、技術エンジン「PE-AV」や評価フレームワーク「SAM Audio Judge」もあわせて公開されています。
参考記事
メイン記事:
- タイトル: Introducing SAM Audio: The First Unified Multimodal Model for Audio Separation
- 著者: Meta AI
- 発行元: Meta AI Blog
- 発行日: 2025年12月16日
- URL: https://ai.meta.com/blog/sam-audio/
関連情報:
- タイトル: SAM-Audio — GitHub Repository
- 発行元: Facebook Research (GitHub)
- 発行日: 2025年12月16日
- URL: https://github.com/facebookresearch/sam-audio
- タイトル: Perception Models: Powerful Models for Image, Video, and Audio Perception
- 発行元: Facebook Research (GitHub)
- 発行日: 2025年12月16日
- URL: https://github.com/facebookresearch/perception_models
要点
- SAM Audioは、テキスト・視覚・時間範囲の3種類のプロンプトを組み合わせて複雑な音声混合から特定の音を分離できる、初の統合マルチモーダル音声分離モデルである
- 技術エンジンにはPE-AV(Perception Encoder Audiovisual)が採用されており、1億本以上の動画を用いた大規模マルチモーダル対照学習で学習されている
- モデルのサイズは500Mから3Bパラメータで提供され、リアルタイムより高速(RTF ≈ 0.7)な処理が可能である
- 音声分離の品質を人間の知覚に近い形で評価する「SAM Audio Judge」と、実環境に即した評価ベンチマーク「SAM Audio-Bench」も同時公開された
- Segment Anything Playgroundから誰でも試用でき、GitHubでモデルとコードも公開されている
詳細解説
SAM Audioとは——音を「切り抜く」統合モデル
SAM Audioは、Metaが開発した音声分離のための統合AIモデルです。2023年に画像・動画のセグメンテーション分野を変えた「Segment Anything Model(SAM)」の音声版に相当する位置づけで、複雑な音声混合から任意の音を取り出す作業をより直感的かつ高精度に実現することを目指して開発されました。
従来の音声分離ツールは、楽器抽出・声の分離・環境音除去といった用途ごとに専用ツールが存在しており、単一の用途にしか対応できないものが多い状況でした。SAM Audioはこうした課題を解決するために、複数のタスクと複数のプロンプト形式をひとつのモデルで統合的に扱える設計になっています。
3種類のプロンプト方式
Metaの発表によれば、SAM Audioは以下の3つの方法でターゲット音を指定できます。
テキストプロンプト:「dog barking」「singing voice」のように、自然言語で取り出したい音を指定します。ポッドキャスト録音中の犬の鳴き声をすべて除去する、といった用途に使えます。
視覚プロンプト:動画内で話している人物や音を出している物体をクリックすることで、その音源の音声を分離します。バンド演奏の映像でギターをクリックするだけでギターの音だけを取り出せる、といった使い方が想定されています。
スパンプロンプト:ターゲット音が出現している時間範囲を指定するプロンプト方式で、Metaによれば業界初の試みとされています。動画全体ではなく特定の区間だけを対象とした音声処理を一括で行えるため、編集作業の効率化に貢献すると考えられます。
これら3種類のプロンプトは単独でも組み合わせても使用でき、Metaの評価では混合モダリティ(テキスト+スパンなど)での利用が単一モダリティを上回る精度を示しています。
モデルアーキテクチャと学習データ
SAM Audioのコアアーキテクチャには、フロー・マッチング拡散トランスフォーマー(flow-matching diffusion transformer)が採用されています。これは音声混合と各種プロンプトを受け取り、共通の表現空間にエンコードしたうえで、ターゲット音と残余音を別々に生成する仕組みです。拡散モデルを音声生成に応用するアプローチは近年注目されており、高品質な音声合成・変換での実績が積み重なっています。SAM Audioはこの仕組みを音声分離の方向に応用した点で、技術的に興味深い設計と言えます。
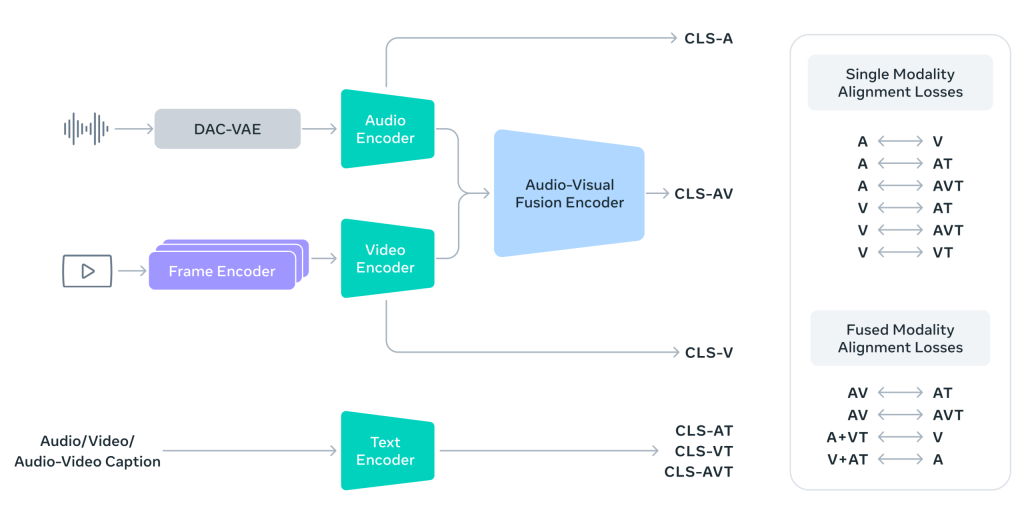
学習データの面では、大規模かつ多様なデータセットを確保するための独自のデータエンジンが構築されています。高度な音声ミキシング、自動マルチモーダルプロンプト生成、擬似ラベリングパイプラインを組み合わせ、現実的なシナリオに対応できる学習データを生成しています。モデルは音声・音楽・一般音響を含む実音源と合成ミックスの両方を含む多様なデータセットで学習されています。
提供されるモデルサイズはsmall・base・largeの3種類で、それぞれ500Mから3Bパラメータの範囲に対応しています。視覚プロンプト向けに特化したバリアント(sam-audio-*-tv)も用意されており、GitHubリポジトリから取得できます。GitHubで公開されているモデルの主観評価スコア(5点満点)を見ると、largeモデルでは楽器分離(プロ環境)で4.49、音楽分離で4.22、音声分離で4.03を記録しています。
技術エンジン:PE-AV(Perception Encoder Audiovisual)
SAM Audioの性能を支えているのが、PE-AV(Perception Encoder Audiovisual)です。Metaが2025年4月に公開したオープンソースの視覚エンコーダ「Perception Encoder(PE)」を拡張し、音声処理能力を追加した位置づけのモデルです。
PE-AVはビデオフレームの特徴量と音声表現を整合させ、視聴覚情報に時刻情報を付与します。この時間的アライメントが、画面内の話者や楽器など視覚的に確認できる音源の正確な分離を可能にしています。また、画面外の出来事についても周囲の映像文脈から推論できる設計になっており、より柔軟な音声分離を実現しています。
GitHubのリポジトリによれば、PE-AVは1億本以上の動画を用いた大規模マルチモーダル対照学習で学習されており、PyTorchVideo(動画処理)やFAISS(大規模意味検索)なども組み合わせて活用されています。PE-AVはSAM Audioの内部コンポーネントとして機能するほか、SAM Audio Judgeのバックボーンとしても使用されています。
AudioCapsやClothoなど複数の音声検索ベンチマークでの評価では、largeモデル(pe-av-large)の平均検索スコアが51.6を記録しており、音声・映像・テキストの統合的な表現学習において高い汎化性能を示しています。
SAM Audio JudgeとSAM Audio-Bench
Metaはモデル本体に加え、音声分離の品質評価に特化した2つのフレームワークも同時公開しています。
SAM Audio Judgeは、参照音源がなくても音声分離の品質を評価できる自動評価モデルです。従来の評価指標は分離音と参照音源を比較する方式が主流でしたが、現実の場面では参照音源が得られないケースも多くあります。SAM Audio Judgeは、想起率・精度・忠実度・総合品質を含む9つの知覚的次元を定義し、5段階評価の人間アノテーションデータをもとに学習されています。音楽・音声・効果音など異なる音声ドメイン間でのモデル比較や品質評価に活用できます。
SAM Audio-Benchは、音声・音楽・一般効果音のすべての主要音声ドメインと、テキスト・視覚・スパンの各プロンプト形式をカバーする包括的な評価ベンチマークです。合成音声ミックスや限定的な音源のみを対象とした従来のデータセットとは異なり、実際の音声・映像素材を活用して構築されています。各10秒サンプルには、人間が描いた視覚マスク・時間マーカー・テキスト説明など豊富なマルチモーダルプロンプトが付与されており、参照音源なしでの評価も可能です。
性能と制限
Metaの発表によれば、SAM Audioは複数のベンチマークで従来の音声分離モデルを上回る性能を記録しており、音楽・音声・一般音響のすべてのカテゴリでドメイン特化型モデルと同等の性能を達成しています。処理速度はリアルタイム比(RTF)約0.7と、リアルタイムを上回る効率で動作します。
一方でいくつかの制限も明示されています。現時点では音声そのものをプロンプトとして使うことはできません。また、プロンプトなしでの全自動音声分離には対応していません。さらに、合唱団から特定の歌手の声を取り出す、オーケストラから単一楽器を分離するといった、非常に類似した音源間の分離は難しい課題として残っています。実際の導入を検討する場合は、これらの制約と用途の適合性を事前に確認することが重要と思います。
アクセス方法と活用展開
SAM AudioはSegment Anything Playgroundから誰でも試用できます。自分の音声・動画ファイルをアップロードして各プロンプト方式を体験できるほか、SAM 3・SAM 3Dといった最新モデルもあわせて使用できます。
開発者向けには、GitHubリポジトリからモデルとコードが公開されています(SAMライセンス)。利用にはHugging FaceリポジトリへのアクセスリクエストとHFアカウントでの認証が必要です。Python 3.10以上とCUDA対応GPUが推奨環境とされています。
また、MetaはアメリカA最大の補聴器メーカーであるStarkey社、および障害を持つ起業家向けスタートアップアクセラレーター2gether-Internationalとのパートナーシップも発表しており、SAM Audioの技術がアクセシビリティ分野への応用についても探索が進められています。
まとめ
MetaのSAM Audioは、テキスト・映像・時間指定という直感的な操作で任意の音を分離できる統合モデルとして、音声処理の実用性を大きく広げる可能性があると思います。PE-AVや評価フレームワークのオープン公開と合わせ、今後の研究・応用事例にどのような展開が生まれるか注目されます。