はじめに
OpenAIが2026年3月5日、プロフェッショナルな業務向けに設計した最新フロンティアモデル「GPT‑5.4」を発表しました。ChatGPT、API、Codexの各プラットフォームで順次提供が開始されており、推論・コーディング・エージェント機能を1つのモデルに統合した点が大きな特徴です。
参考記事
- タイトル: Introducing GPT‑5.4
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年3月5日
- URL: https://openai.com/index/introducing-gpt-5-4/
要点
- GPT‑5.4は推論・コーディング・エージェントワークフローを統合した汎用フロンティアモデルで、ChatGPT・API・Codexで利用可能である
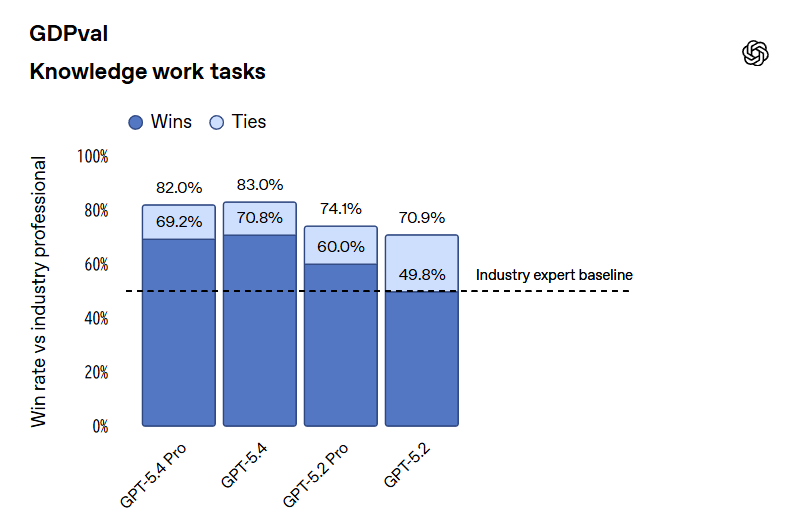
- GDPvalベンチマークで83.0%を達成し、44職種にわたる知識労働タスクで業界プロフェッショナルを上回る水準を記録した
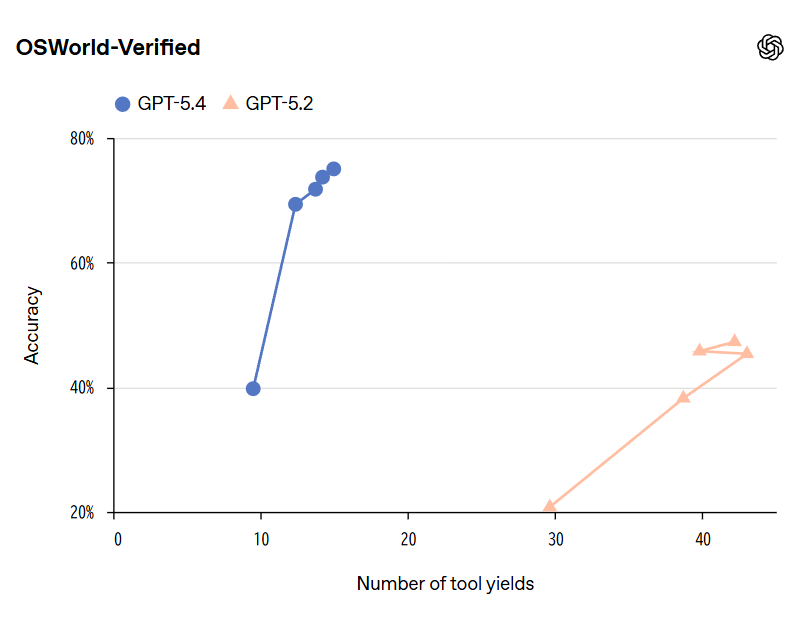
- デスクトップ操作を評価するOSWorld-Verifiedで75.0%の成功率を達成し、初の汎用コンピューター使用機能を搭載する
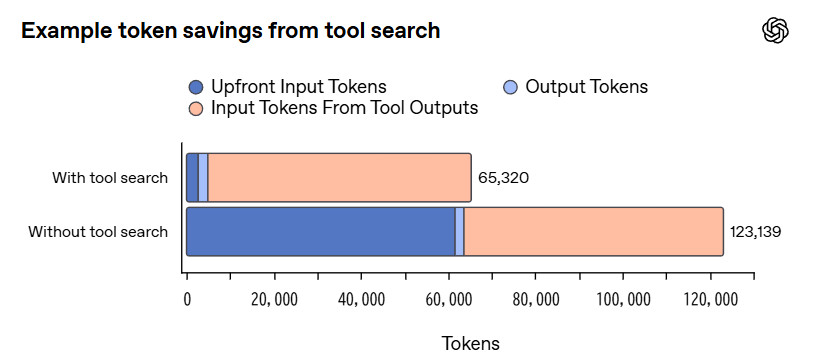
- Tool Searchにより多数のツールを扱うワークフローでのトークン消費量を47%削減できる
- ChatGPTのGPT‑5.4 ThinkingはPlus・Team・Proユーザーから提供開始され、APIでは入力$2.50/Mトークンで利用可能である
詳細解説
知識労働・ドキュメント作成の強化
OpenAIはGPT‑5.4を「プロフェッショナル業務向けの最も高性能かつ効率的なフロンティアモデル」と位置づけています。44職種にわたる知識労働タスクの品質を評価するベンチマーク「GDPval」では、業界プロフェッショナルとの比較で83.0%の勝率または同等評価を達成しており、前世代のGPT‑5.2(70.9%)から大きく向上しています。
| GPT-5.4 | GPT-5.3-Codex | GPT-5.2 | |
|---|---|---|---|
| GDPval (wins or ties) | 83.0% | 70.9% | 70.9% |
| SWE-Bench Pro (Public) | 57.7% | 56.8% | 55.6% |
| OSWorld-Verified | 75.0% | 74.0%* | 47.3% |
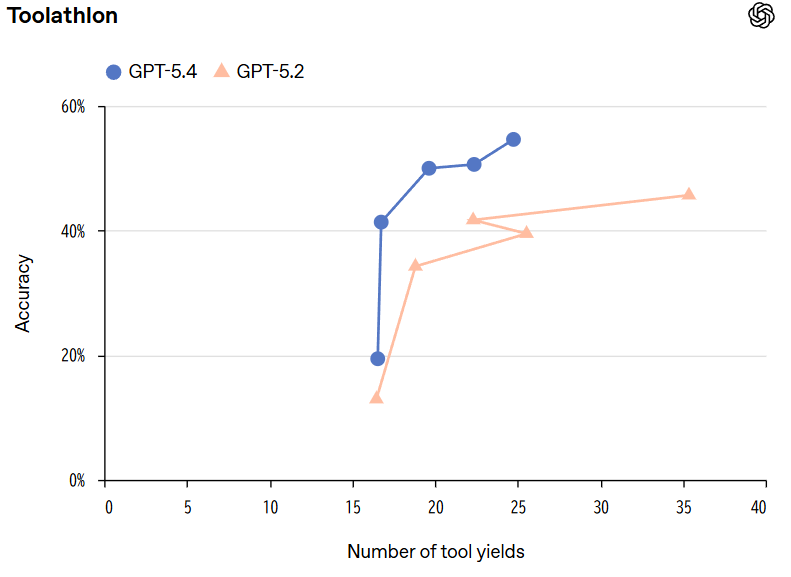
| Toolathlon | 54.6% | 51.9% | 46.3% |
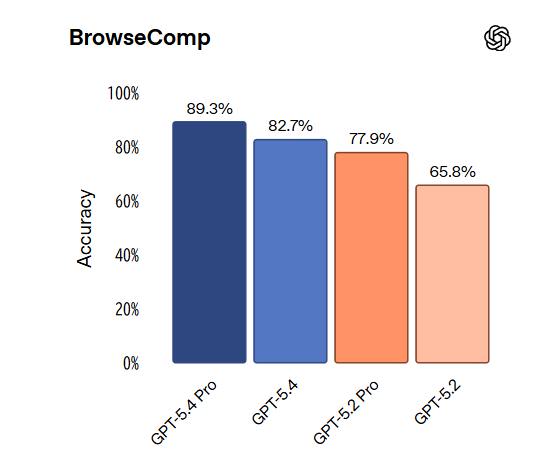
| BrowseComp | 82.7% | 77.3% | 65.8% |
スプレッドシート・プレゼンテーション・ドキュメントの作成・編集にも重点が置かれており、投資銀行のジュニアアナリストが行うような財務モデリングタスクの内部ベンチマークではGPT‑5.4が87.3%の平均スコアを記録し、GPT‑5.2の68.4%を大幅に上回りました。プレゼンテーション評価でも、デザインの審美性・ビジュアルの多様性・画像生成の活用といった観点から、68.0%の割合でGPT‑5.2よりも高く評価されています。また、法律分野の評価基準「BigLaw Bench」では91%というスコアが報告されており、長文契約書の処理や複雑な取引分析に対する適性も示しています。
ハルシネーション対策にも進展があります。ユーザーが事実誤りを報告したプロンプトを使った検証では、GPT‑5.4の個別主張が誤りである確率はGPT‑5.2比で33%低下し、回答全体に誤りが含まれる確率は18%低下しました。
コンピューター使用機能と視覚認識
GPT‑5.4はOpenAIとして初めて、コンピューター操作機能を標準搭載した汎用モデルです。スクリーンショットを解析してマウス・キーボード操作を指示するだけでなく、PlaywrightなどのライブラリによるコードベースのUI操作も得意とします。開発者はモデルの安全動作を確認ポリシーとして細かく設定できる点も特徴です。
デスクトップ環境でのタスク遂行能力を測るOSWorld-Verifiedでは75.0%の成功率を達成しており、これは人間の72.4%を上回り、GPT‑5.2の47.3%から大幅に改善しています。ブラウザ操作を評価するWebArena-Verifiedでも67.3%、Online-Mind2Webでは92.8%を記録しました。デスクトップ・ウェブの両環境で高い水準を示しており、実務的なワークフロー自動化への応用範囲が広がると考えられます。
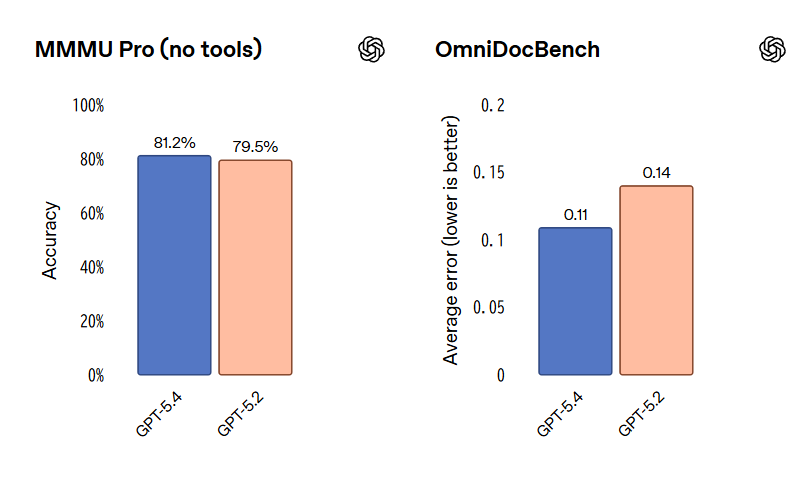
視覚認識性能も向上しており、MMMU-Proでは81.2%(GPT‑5.2は79.5%)を達成しています。また、高解像度画像への対応として最大1,024万ピクセルまたは6,000ピクセルの最大辺長に対応する「original」入力詳細レベルが新設されました。このような高精度な視覚処理が、コンピューター操作精度の向上を支えていると言えます。
コーディング機能
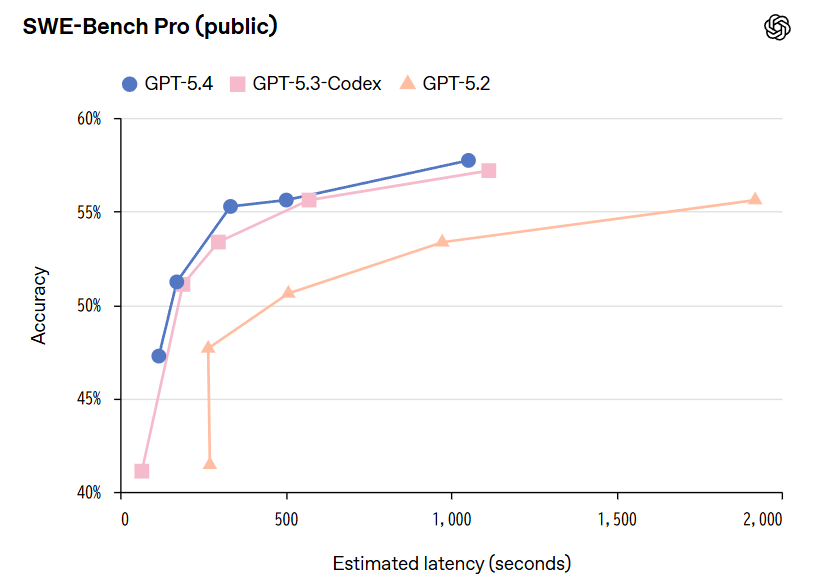
GPT‑5.4はGPT‑5.3-Codexのコーディング性能を受け継ぎつつ、知識労働・コンピューター使用能力と組み合わせることで、長時間稼働するタスクへの対応力を高めています。ソフトウェアエンジニアリングの実課題を評価するSWE-Bench Proでは57.7%を達成し、GPT‑5.3-Codexの56.8%と同水準以上を維持しています。
Codexでは「/fast mode」を有効にすることで、同じモデル・同じ品質のまま最大1.5倍のトークン生成速度が得られます。また、実験的スキル「Playwright (Interactive)」により、Codexが開発中のウェブアプリを視覚的にデバッグ・テストすることも可能になりました。1Mトークンのコンテキストウィンドウも試験的にサポートされており、長期間にわたるタスクの計画・実行・検証が可能になっています。
ツール使用の改善:Tool Searchと精度向上
GPT‑5.4では、多数の外部ツールを扱う際の効率を大きく改善する「Tool Search」が導入されました。従来はすべてのツール定義をリクエストのたびにプロンプトへ含める必要があり、数万トークンもの追加コストが発生していました。Tool Searchでは、モデルが必要なタイミングで該当ツールの定義を検索・取得する仕組みとなり、36のMCPサーバーを使った250タスクでの検証では、精度を維持したままトークン消費量が47%削減されています。
多段階のツール使用タスクを評価するToolathlonでも54.6%を達成し、GPT‑5.2の45.7%から改善しています。ウェブ検索能力を評価するBrowseCompでは82.7%(GPT‑5.2は65.8%)を記録しており、特定の情報を複数ソースから収集・統合する「ニードル・イン・ア・ヘイスタック」型の調査タスクへの適性が高まっています。
操作性(ステアラビリティ)と安全性
ChatGPTにおいてGPT‑5.4 Thinkingは、長い処理を開始する前に作業計画を提示するようになりました。ユーザーはモデルが回答を生成している最中に指示を追加・修正でき、求めるアウトプットへの軌道修正を追加ターン不要で行えます。この機能はchatgpt.comおよびAndroidアプリで利用可能で、iOSアプリにも順次展開予定です。
安全性については、OpenAIの準備フレームワークに基づきGPT‑5.4を「High cyber capability」として分類し、相応の保護措置を講じています。推論の透明性に関する研究も継続されており、モデルが意図的に推論を隠蔽できるかを測る新しいオープンソース評価「CoT controllability」が公開されました。GPT‑5.4 ThinkingはCoT制御能力が低いという結果が確認されており、推論の監視が引き続き有効な安全手段であることが示されています。
提供形態と価格
ChatGPTではGPT‑5.4 ThinkingがPlus・Team・Proユーザーから順次提供され、GPT‑5.2 Thinkingを置き換えます。GPT‑5.2 Thinkingは2026年6月5日まで「Legacy Models」として引き続き選択可能です。EnterpriseおよびEduプランは管理者設定から早期アクセスを有効化できます。
| API model | Input price | Cached input price | Output price |
| gpt-5.2 | $1.75 / M tokens | $0.175 / M tokens | $14 / M tokens |
| gpt-5.4 | $2.50 / M tokens | $0.25 / M tokens | $15 / M tokens |
| gpt-5.2-pro | $21 / M tokens | – | $168 / M tokens |
| gpt-5.4-pro | $30 / M tokens | – | $180 / M tokens |
APIの価格は、入力$2.50/Mトークン(キャッシュ済み$0.25/M)、出力$15/Mトークンで、GPT‑5.2の入力$1.75/M・出力$14/Mから引き上げられています。ただし、トークン効率の改善により多くのタスクで実際のトークン消費量は減少するとOpenAIは説明しています。バッチ処理・Flex処理は標準レートの半額、Priority処理は2倍の価格で利用できます。
まとめ
GPT‑5.4は、推論・コーディング・コンピューター操作・ツール使用を一体化した汎用モデルとして、特に業務利用での活用幅が広がると考えられます。ドキュメント作成の精度向上やTool Searchによるコスト効率の改善など、現場導入を検討するうえで注目すべき変化が多く含まれています。