はじめに
Googleの研究者らが2026年2月17日、AIに地図上の経路をたどる能力を教えるための合成データ生成パイプライン「MapTrace」を発表しました。本稿では、この研究の背景と仕組み、ファインチューニングによる性能改善の結果、および公開されたデータセットとコードの概要を解説します。
参考記事
メイン記事:
- タイトル: Teaching AI to read a map
- 著者: Artemis Panagopoulou(Student Researcher)、Mohit Goyal(Senior Software Engineer)
- 発行元: Google Research Blog
- 発行日: 2026年2月17日
- URL: https://research.google/blog/teaching-ai-to-read-a-map/
関連情報:
- タイトル: MapTrace: Scalable Data Generation for Route Tracing on Maps(論文プロジェクトページ)
- 発行元: Google XR / University of Pennsylvania
- URL: https://artemisp.github.io/maptrace/
- タイトル: MapTrace GitHub Repository
- 発行元: google-research(GitHub)
- URL: https://github.com/google-research/MapTrace
- タイトル: MapTrace Dataset(HuggingFace)
- 発行元: Google(HuggingFace)
- URL: https://huggingface.co/datasets/google/MapTrace
・本稿中の画像に関しては特に明示がない場合、引用元記事より引用しております。
・記載されている情報は、投稿日までに確認された内容となります。正確な情報に関しては、各種公式HPを参照するようお願い致します。
・内容に関してはあくまで執筆者の認識であり、誤っている場合があります。引用元記事を確認するようお願い致します。
要点
- マルチモーダル大規模言語モデル(MLLM)は、地図上で壁を通り抜けるような無効な経路を生成してしまうなど、細粒度の空間推論が苦手である
- Googleは合成データを自動生成する4段階パイプライン「MapTrace」を開発し、200万件の経路アノテーション付きデータセットをオープンソースで公開した
- MapTraceデータでファインチューニングしたGemini 2.5 Flashは、経路誤差指標NDTW(正規化動的時間伸縮法)が1.29から0.87へと32.5%改善し、最高性能を達成した
- オープンソースモデルGemma 3 27Bも成功率が6.4ポイント向上し、ファインチューニング前よりはるかに安定した経路生成が可能になった
- データセット(210GB)、論文、ファインチューニング用コードはすべて公開されており、研究者や開発者が自由に活用できる
詳細解説
課題:AIは地図の「ルール」を知らない
人間はショッピングモールや動物園の地図を見ると、どの線が壁でどこが通路かを直感的に理解し、目的地までの経路をすぐに把握できます。しかし、現在のマルチモーダル大規模言語モデル(MLLM:テキストと画像の両方を処理できる大型AIモデル)は、この「当然の空間感覚」を持ち合わせていないとGoogleの研究者らは指摘しています。
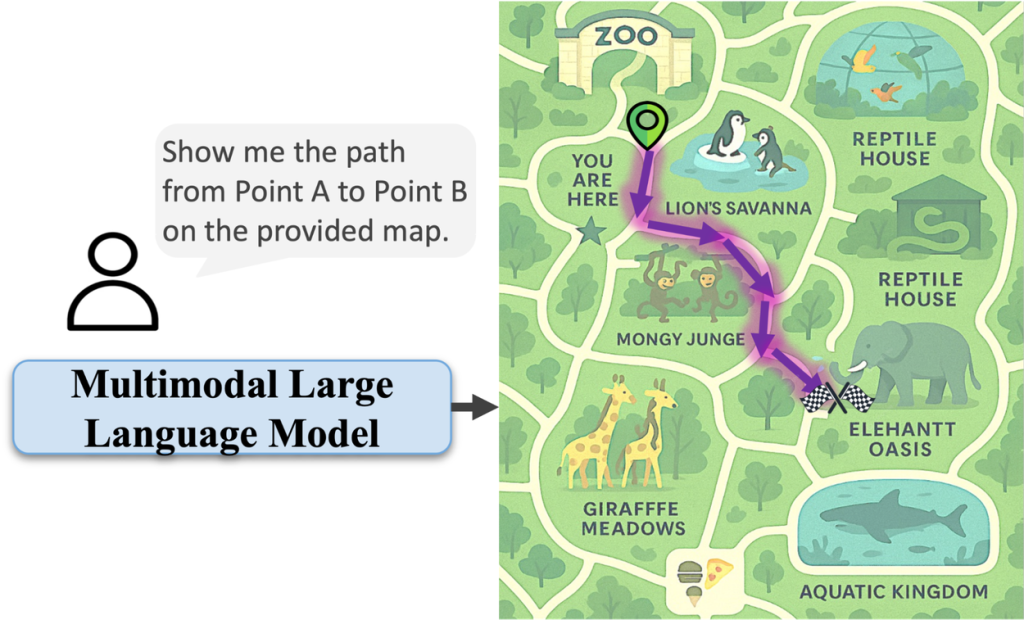
MLLMは画像の中に何があるかを認識することは得意ですが、「壁を通り抜けてはいけない」「経路は連続していなければならない」といった空間の制約を守ることが難しいとされています。これは主にデータの問題です。大量の画像とテキストから学習するMLLMは、ナビゲーションのルールを明示的に教えるような教師データを十分に見ていません。一方、実際の地図に対してピクセル単位で経路を手作業でアノテーション(注釈付け)することは、非常にコストと時間がかかります。また、ショッピングモールや美術館などの詳細な地図は著作権で保護されている場合が多く、大規模に収集することも現実的ではありませんでした。
解決策:AIがAIを評価する4段階の合成データ生成パイプライン
この課題に対してGoogleが提案したのが、AIモデル自身を活用して大量の地図と経路データを自動生成するパイプラインです。Gemini 2.5 ProとImagen-4を組み合わせ、次の4段階で動作します。
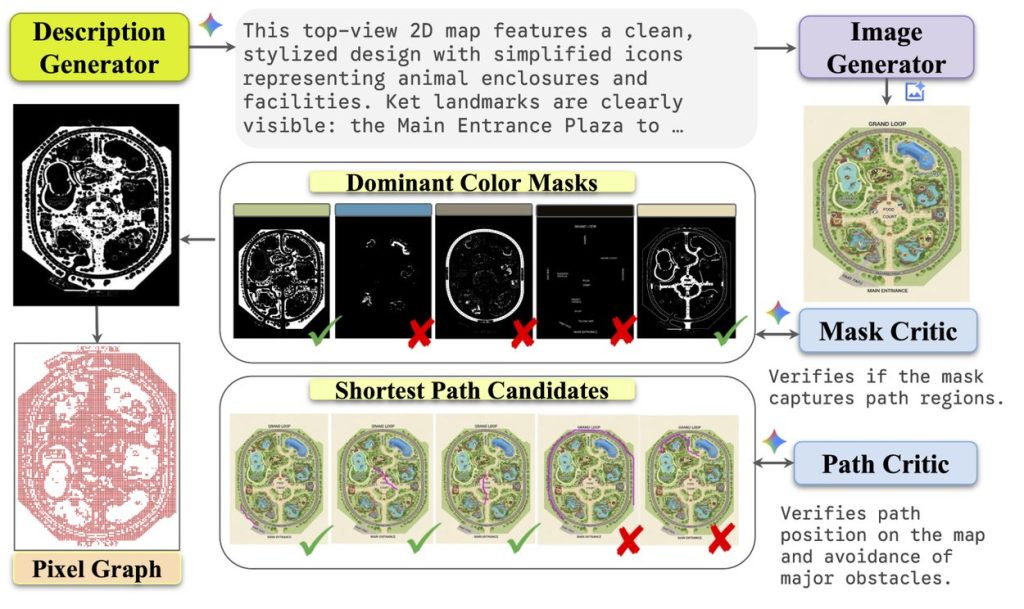
第1段階:多様な地図の生成。 まず大規模言語モデル(LLM)が「動物の生息エリアが連結した動物園の地図」や「中央にフードコートがあるショッピングモール」といった多様なテキストプロンプトを生成します。これをテキストから画像を生成するモデルに渡して、複雑な地図画像を描画します。
第2段階:「マスク批評家」による通路領域の特定。 生成された地図画像に対して、色によるクラスタリングで「歩ける領域」の候補マスク(白黒の二値画像)を作成します。その後、別のMLLMを「マスク批評家(Mask Critic)」として機能させ、歩道や横断歩道などの有効な通路領域が含まれているかを判定します。精度は83%、誤検出率は9%と報告されており、合格したマスクのみが次のステップへ進みます。
第3段階:ナビゲーション可能なグラフの構築。 認証されたマスクを、交差点をノード、道をエッジとするグラフ構造に変換します。これにより、計算機上で最短経路を求めることが可能になります。
第4段階:「経路批評家」による品質保証。 グラフ上でダイクストラ法(最短経路を求める古典的なアルゴリズム)を使って候補経路を生成したのち、さらに別のMLLMを「経路批評家(Path Critic)」として使い、生成された経路が地図上で自然かどうかを最終確認します。精度76%、誤検出率8%でした。
このように、人間の手を借りずにAIモデルがAIモデルを評価するという多重チェックの仕組みで品質を確保している点が、本パイプラインの特徴と言えます。
公開データセットの構成
GitHubおよびHuggingFaceの情報によれば、このパイプラインで生成されたMapTraceデータセットは合計200万件のアノテーション付き経路を含み、総サイズは210GBです。データはParquet形式で提供されており、次の2種類に分かれています。
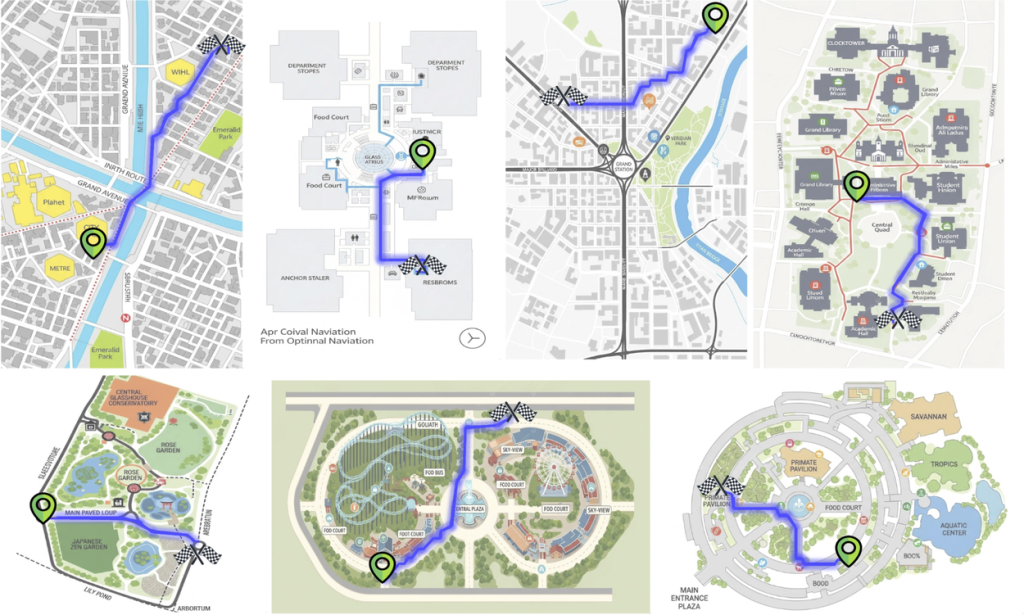
- maptrace_parquet :施設パンフレットや公園・ショッピングモールのような複雑でスタイル化された地図上の経路を含みます。
- floormap_parquet :オフィスビルやキャンパスの図面のような、より構造的なシンプルなフロアマップ上の経路を収録しています。
各データには地図画像のバイトデータ、経路の座標リスト、自然言語のクエリ(「ロビーから会議室Bへの行き方を示してください」など)、および地図の説明テキストが含まれています。
ファインチューニングの実験に使用された23,000件のサブセット(maptrace_20k)も別途公開されており、追加処理なしですぐに学習に使用できます。
性能評価の結果
Googleの研究者らは、MapTraceデータでファインチューニングしたモデルを、実世界の地図で構成されるベンチマークセット「MapBench」で評価しました。MapBenchはモール、都市部、動物園など多様な地図タイプを含む評価指標で、本研究で使用したデータには含まれていない未知の地図です。
評価には2種類の指標が使われました。1つはNDTW(正規化動的時間伸縮法)で、参照経路と生成経路の形状的な一致度を測るもので、値が小さいほど優れています。もう1つは成功率(Success Rate)で、モデルが有効な経路を出力できた割合です。
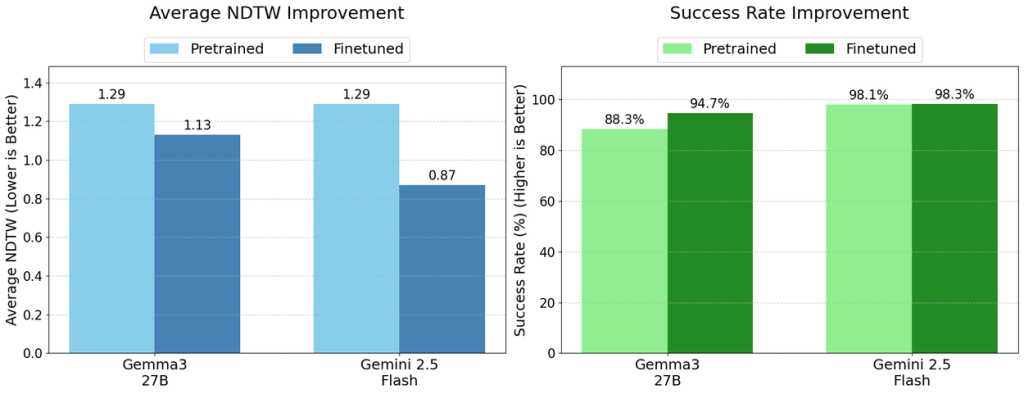
Googleによれば、ファインチューニング後のGemini 2.5 FlashはNDTWが1.29から0.87へと32.5%改善し、ヒューリスティックベースラインを上回る最高性能を達成しました。オープンソースモデルのGemma 3 27Bは成功率が6.4ポイント向上し、NDTWも1.29から1.13へと改善されました。
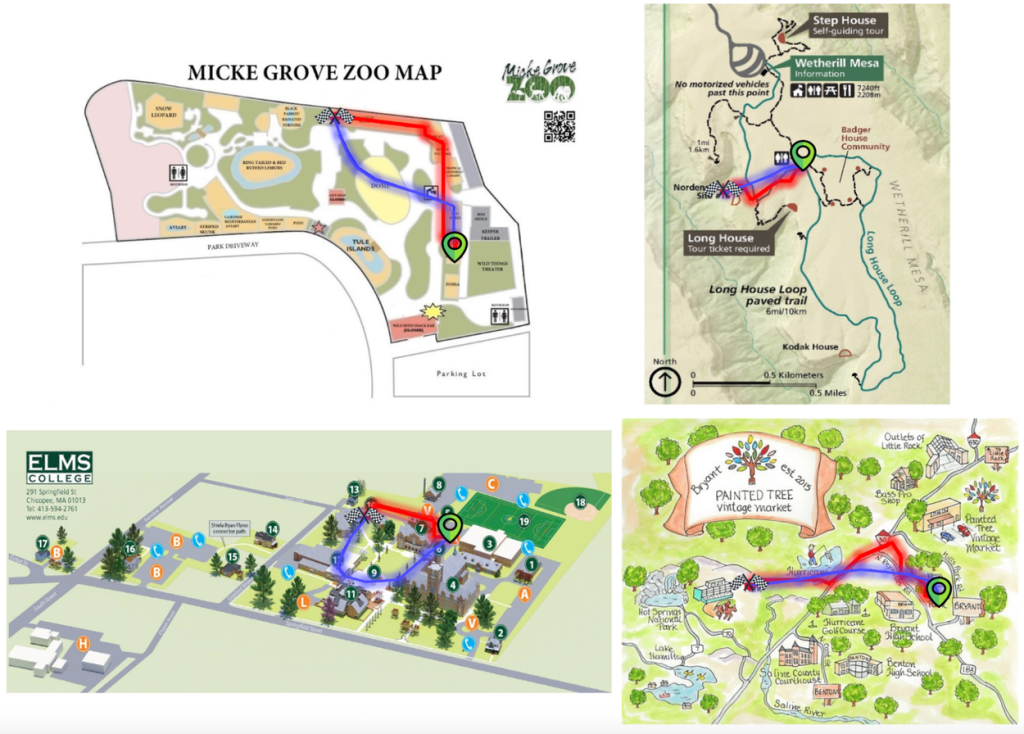
微調整されたモデルは、意図した経路にさらに忠実に従い、通過不可能な領域を回避しています。
NDTW(Normalized Dynamic Time Warping)は、もともと時系列データの比較に使われる手法を経路比較に応用したもので、始点と終点が同じでもサンプリング点の数が異なる経路同士を柔軟に比較できます。経路全体の長さで正規化することで、長い経路と短い経路を公平に評価できるという特徴があります。この指標で約1.3程度のベースラインが0.87まで下がったことは、生成経路の軌跡が参照経路に相当近づいたことを示していると考えられます。
今後の応用可能性
研究チームは本研究を踏まえ、いくつかの応用先を挙げています。衛星画像や地下鉄路線図を見て直感的な経路案内を提供するナビゲーションツール、フロアプランを参照して倉庫や病院・空港などの複雑な屋内環境を自律的に移動できるロボットへの応用、さらには建物内の経路を視覚障害者向けにわかりやすく音声説明するアクセシビリティツールなどが考えられるとしています。これらはいずれも、空間の制約を正しく理解するAIが前提となる領域であり、MapTraceのような研究が基盤技術として貢献できる分野だと思います。
まとめ
今回のMapTrace研究は、細粒度の空間推論という弱点に対し、合成データによる明示的な学習が有効であることを示した成果です。Gemini 2.5 FlashのNDTW32.5%改善という結果は、空間認識能力がMLLMの先天的な限界ではなく、適切な学習で習得できるスキルであることを示しています。データセットとコードの公開により、研究コミュニティへの貢献も期待できます。