はじめに
Google XRチームが2025年2月10日、複数のAIエージェント間の会話をデザイン・シミュレーション・検証できるオープンソースツール「DialogLab」についてGoogleBlogにて報告しました。本稿では、ACM UIST 2025で発表されたこの研究プロトタイプについて、その仕組みと実用可能性を解説します。
参考記事
- タイトル: Beyond one-on-one: Authoring, simulating, and testing dynamic human-ai-group conversations
- 著者: Erzhen Hu, Ruofei Du
- 発行元: Google Research Blog
- 発行日: 2025年2月10日
- URL: https://research.google/blog/beyond-one-on-one-authoring-simulating-and-testing-dynamic-human-ai-group-conversations/
- タイトル: DialogLab: Configuring and Orchestrating Multi-Agent Conversations
- 発行元: GitHub
- URL: https://github.com/ecruhue/DialogLab
要点
- DialogLabは、複数のAIエージェントと人間が参加するグループ会話を設計・シミュレーション・検証できるオープンソースフレームワークである
- 会話の社会的構造(参加者、役割、サブグループ)と時間的な流れ(会話の進行、順番交代ルール)を分離して設計できる
- 14名の評価実験では、人間が介入して制御できる「Human Control」モードが、完全自律型や反応型と比較して、関与度・効果・リアリズムの面で優れていると評価された
- Ready Player Meの3Dアバターを使用し、OpenAI GPTやGoogle Geminiと連携して動作する
- 教育、ゲームデザイン、社会科学研究など、多様な応用が期待される
詳細解説
従来の課題と新しいアプローチ
Googleによれば、従来の会話型AIは1対1のやり取りが中心でしたが、実際の人間のコミュニケーションはチーム会議や家族の食事、教室での授業など、複数人が参加する場面が多く存在します。これらのマルチパーティ会話では、流動的な順番交代、役割の変化、突然の割り込みといった要素が重要になります。
従来、こうした複雑な会話をシミュレートするには、台本による硬直的な制御か、完全に生成AIに任せる予測不可能な方式のいずれかを選ぶ必要がありました。DialogLabは、この2つのアプローチを融合することで、構造的な予測可能性と自発的な即興性を両立させることを目指しています。
DialogLabの基本設計
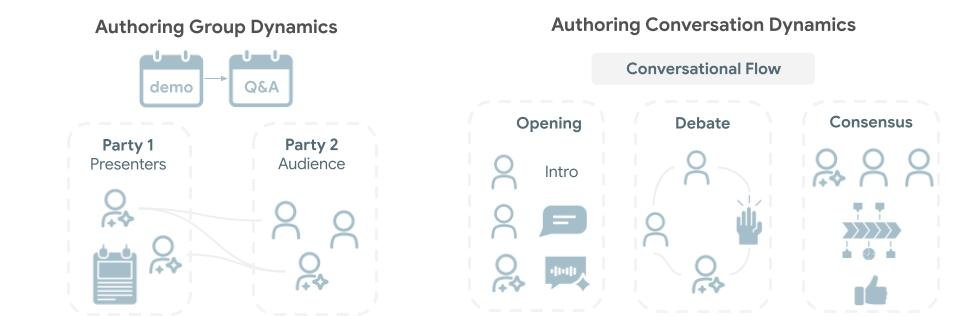
DialogLabのフレームワークは、会話を2つの次元で定義します。
1つ目はグループダイナミクスです。これは会話の社会的構造を表します。最上位の「グループ」(例:カンファレンスの社交イベント)の下に、異なる役割を持つ「パーティ」(例:「発表者」と「聴衆」)があり、さらにその下に個々の参加者(人間またはAI)と共有コンテンツ(プレゼンテーションスライドなど)を表す「エレメント」が配置されます。
2つ目は会話フローダイナミクスです。これは対話が時間とともにどのように展開するかを記述します。会話は「スニペット」と呼ばれる独立した段階に分割され、各スニペットには参加者、会話ターンのシーケンス、特定のインタラクションスタイル(例:協力的、議論的)が定義されます。また、割り込みやバックチャネリング(相槌など)のルールも設定できます。
この設計により、モジュール式の会話デザインが可能になります。例えば、同じ参加者グループを維持しながら、会話の進行段階だけを変更するといった柔軟な編集ができます。
「作成-テスト-検証」のワークフロー
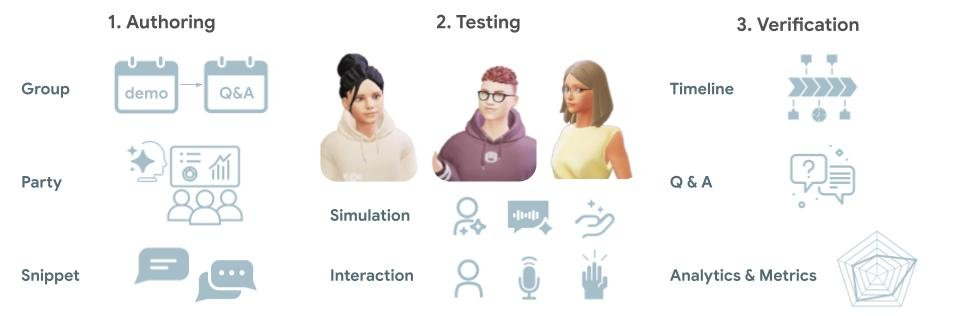
DialogLabは、ビジュアルインターフェースを通じて3段階のワークフローをサポートします。
作成段階では、ドラッグ&ドロップ式のキャンバス上でアバターやコンテンツをライブラリから配置してシーンを構築します。インスペクターパネルで、アバターのペルソナから特定のスニペット内でのインタラクションパターンまで、詳細な設定が可能です。設計を加速するため、自動生成された会話プロンプトも提供され、これを特定の目標に合わせて微調整できます。
テスト段階では、ライブプレビューパネルで会話のトランスクリプトを確認しながら、「Human Control」モードを使用できます。このモードでは、AIが提案する応答を「audit panel」で確認し、編集、承認、却下することができます。これにより、AIの発言を細かくコントロールしながら、迅速な反復開発が可能になります。
検証段階では、検証ダッシュボードが診断ツールとして機能します。長いトランスクリプトを読み解くことなく、ターン交代の分布や感情の流れを視覚化し、会話のダイナミクスを素早く分析できます。
評価実験の結果
Googleの評価実験には、ゲームデザイン、教育、社会科学研究の分野から14名の参加者が関与しました。参加者は、学術的な社交イベントのデザインと、3つの異なる条件でのグループディスカッションのテストを行いました。
3つの条件は以下の通りです。「Human Control」では、ユーザーがエージェントに「トピックを変更」「新しい視点を生成」「質問を深掘り」「感情的な応答を生成」といった指示を出せます。「Autonomous」では、シミュレートされたエージェントが事前定義された順序(ランダムまたは順番)に基づいて自発的に会話に参加し、感情的応答やトピック変更を自動生成します。「Reactive」では、シミュレートされた人間エージェントは他のエージェントから直接言及された時のみ応答し、従来の人間-AIのターン交代動作を模倣します。
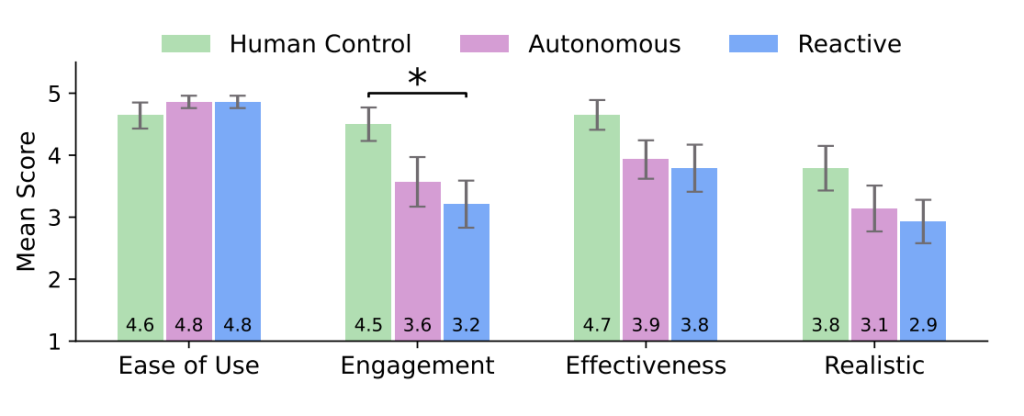
参加者は各条件を5段階のリッカート尺度で評価しました。その結果、Human Controlモードが他の2つの条件と比較して、使いやすさ、関与度、効果、リアリズムのすべての面で有意に高い評価を得ました。特に関与度の面では顕著な差が見られ、参加者はこのモードによって自律性と没入感が高まったと報告しています。
参加者からは、ビジュアルなドラッグ&ドロップインターフェースが直感的で楽しいこと、自動生成プロンプトと細部の調整機能のバランスが優れていること、検証ダッシュボードが会話ダイナミクスを迅速に分析できる有用な診断ツールであることなど、肯定的なフィードバックが得られました。
技術的実装とオープンソース化
DialogLabは、React、Vite、Expressを使用して構築されています。クライアント側はReactベースのUI(Vite使用、開発サーバーはポート5173)で、サーバー側はExpressによるAPIサーバー(ポート3010)です。LLMプロバイダーとしてOpenAI GPTとGoogle Geminiの両方に対応しており、少なくとも1つのAPIキーがあれば動作します。
3Dアバターには、オープンソースの「TalkingHead」ライブラリ(MIT License)とThree.js、そしてReady Player Meで作成されたアバターファイルを使用しています。これらのアバターは音声合成と同期して動くため、よりリアルな会話体験を提供できます。
GitHubで公開されているリポジトリには、クライアントとサーバーのコード、ドキュメント、サンプルシーンが含まれており、研究者や開発者が自由に試すことができます。環境変数ファイルでAPIキーを設定し、サーバーとクライアントをそれぞれ起動すれば、ローカル環境で動作を確認できます。
応用の可能性
Googleは、DialogLabの応用領域として3つの分野を挙げています。
教育とスキル開発では、学生がシミュレートされた聴衆の前でプレゼンテーションの練習をしたり、専門家が難しい会話や面接のリハーサルを行ったりできます。実際の人間を集めることなく、さまざまなシナリオを繰り返し練習できるため、学習効率が向上すると考えられます。
ゲームデザインとストーリーテリングでは、作家やゲーム開発者がより信頼性の高い、動的なNPC(ノンプレイヤーキャラクター)を作成できます。NPCが互いに、そしてプレイヤーと自然な方法でやり取りすることで、よりリアルなゲーム体験を提供できる可能性があります。
社会科学研究では、DialogLabを制御された環境として使用し、グループダイナミクスを研究できます。大人数を集めるという物流上の課題なしに、社会的相互作用に関する仮説を検証できます。
さらに今後の展望として、非言語的なジェスチャーや表情といった、よりリッチなマルチモーダル行動の統合や、「ChatDirector」のようなフォトリアリスティックなアバターと3D環境を使った、より没入型でリアルなシミュレーションの実現が挙げられています。
まとめ
DialogLabは、複数のAIエージェントが参加する会話を設計・シミュレーション・検証できるオープンソースフレームワークです。会話の社会的構造と時間的流れを分離する設計により、柔軟なマルチパーティ会話のデザインが可能になります。評価実験では、人間が介入できるモードが最も効果的と評価され、教育、ゲームデザイン、研究など多様な応用が期待されます。今後、マルチモーダル機能の拡張により、さらに実用的なツールになる可能性があります。