はじめに
Anthropicは2026年11月6日、AIエージェントの「記憶」に関する研究記事を公開しました。作業中に書くメモと、後から作業記録を見返して記憶を整え直す「ドリーミング」を組み合わせ、その効果を複数の実験で調べています。
ポケモン、社内文書、法務文書を題材にした結果を、専門知識がなくても追えるように整理します。
参考記事
- タイトル: The components of agent memory
- 著者: Lance Martin
- 発行元: Anthropic
- 発行日: 2026年11月6日
- URL: https://www.anthropic.com/research/components-of-agent-memory
要点
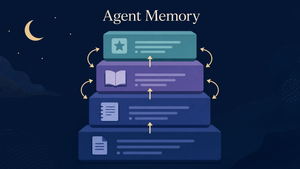
- Anthropicは、エージェントの記憶を作業記録、記憶メモ、wikiなどの記憶表現、毎回読み込む情報の4層で整理している。
- データベース検索の課題では、Claude Opus 5以降のモデルが検証済みのルールを記憶に残し、記憶なしより高い平均報酬を得た。
- 性能の高いモデルでは記憶の目的だけを伝える方が効果的で、「失敗だけを記録」という固定ルールは記憶による伸び幅を縮めた。
- ドリーミングは誤ったメモの修正、wikiの構築、目的に沿った記憶の再編、リンク切れの補修に役立った。
- 記憶を作るタイミング、更新にかかる計算コスト、wikiが効かない課題など、未解決の点も残っている。
詳細解説
記憶とは何か:書く、見返す、整える4層の仕組み
AIエージェント(指示を受けて複数の手順を自律的にこなすAI)は、セッション(一回分の作業の区切り)ごとに作業します。新しいセッションは、前回の内容を知らない状態から始まります。
ここでいう記憶は、セッションをまたいで保存され、後で読み返せる知識です。モデルの重みの変更や、1つの会話の中だけの学習、古いやり取りの要約(コンパクション)は含みません。
研究は人間の脳を手がかりにしています。海馬が体験を素早く記録し、睡眠中などに再生して長期の知識へ統合します。エージェントでも、作業中は記録を残し、手が空いた時間に見返して整理できます。この処理がドリーミングです。ただし脳と違い、計算資源を使って明示的に実行します。
難しいのは、その場では何が大事か分からない点です。記憶は「未来に何が必要か」の予測でもあり、外れることがあります。誤ったメモや古いメモも、後のセッションでは信頼されて読まれます。
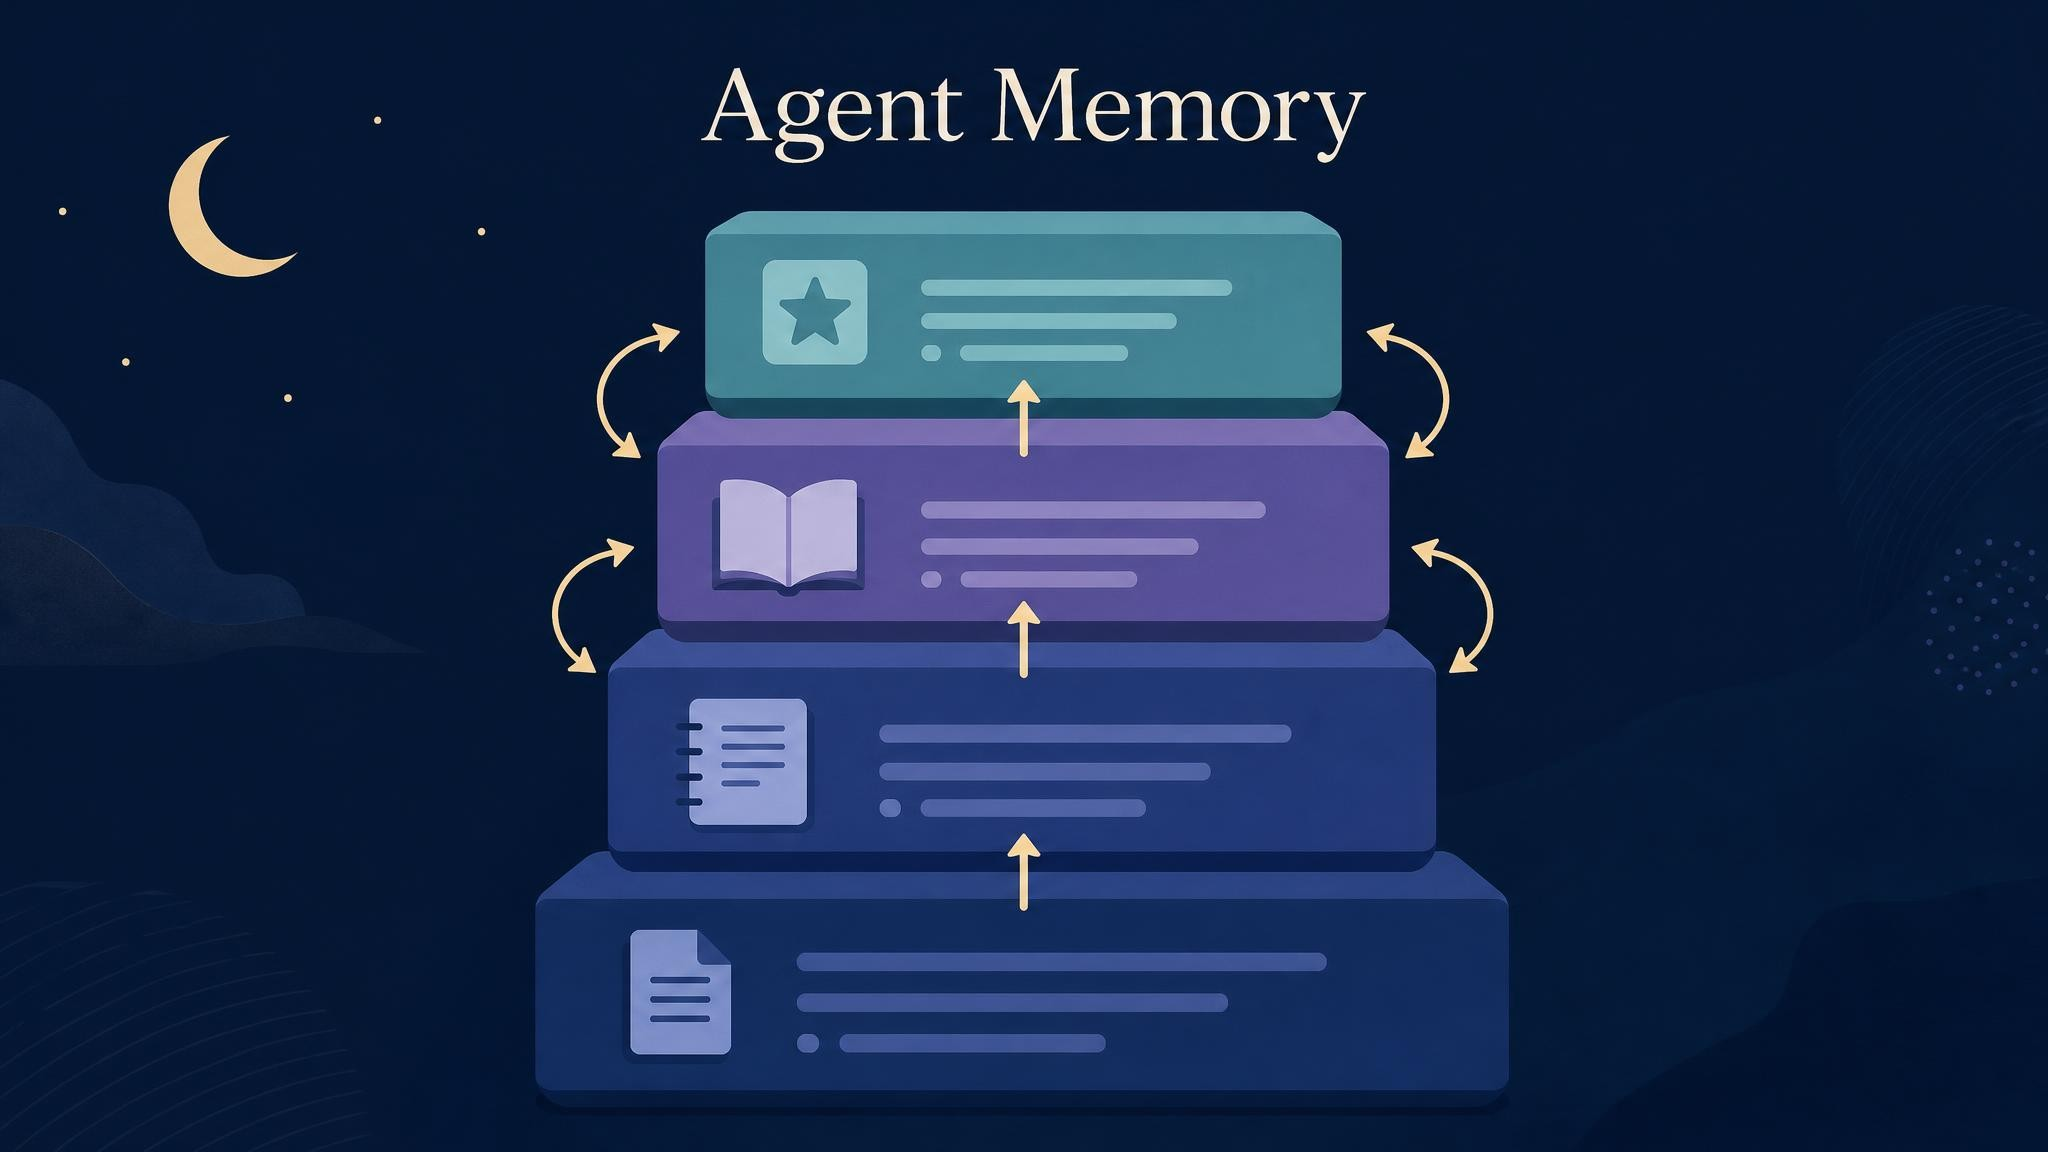
Anthropicは記憶を4層で整理しています。
- トランスクリプト:検索できる作業の記録
- 記憶メモ:Claudeが作業中に重要と判断して書く観察
- 記憶表現:wikiのように、メモを整理して結びつけたもの
- 注入コンテキスト:全セッションの開始時に読み込む情報
ドリーミングは、作業記録をもとに各層を整えます。役割は、メモの誤りの修正、wikiの構築、重要なメモの上位層への昇格、目的に合わせた記憶づくり、セッションを横断した抜けの補完です。
最上位の層は、探さなくても使えるのが利点です。一方でトークン(AIが文章を処理する単位)を消費し、誤りを全セッションに持ち込む危険もあります。指示ファイルが長いほど守られにくい、という注意もClaude Codeのドキュメントにあります。
そのためClaude Codeの自動メモリーは、`MEMORY.md` の最初の200行または25KBだけを毎回読み込みます。この冒頭部分が、何をどこに知っているかを示す索引になります。
記憶の書かせ方:目的は伝え、方法は任せる
記憶の使い方は、ベンチマーク「Continual Learning Bench(CL-Bench)1.0」で調べました。Claudeはデータベースを調べて質問に答え、回答後に正解を知らされ、記憶を書けます。実験基盤は「Claude Managed Agents」で、引き継がれるのは記憶用ディレクトリーだけです。
理想は、誤答を記録し、原因の仮説を立てて検証し、今後のルールにするループです。Claude Sonnet 4.6は仮説止まりで、未検証の推測が散らばりました。Claude Opus 5はこのループを初めて完結させ、Opus 5.5とSonnet 5.5も検証済みのルールを残しました。
30問の平均報酬(記憶なし → 記憶あり)は次のとおりです。
- Claude Opus 5.5:0.655 → 0.838
- Claude Sonnet 5.5:0.644 → 0.833
- Claude Opus 5:0.564 → 0.828
- Claude Opus 4.7:0.383 → 0.700
- Claude Sonnet 5:0.306 → 0.610
- Claude Sonnet 4.6:0.330 → 0.364
ここでは記憶用フォルダーがあることだけを伝えました。それでもOpus 4.7とOpus 5は成績がはっきり上がりました。
一方、「失敗だけを記録する」というルールを与えると、記憶による伸び幅は次のように縮みました。
- Claude Opus 5:−0.234
- Claude Opus 4.7:−0.150
- Claude Sonnet 4.6:−0.020
性能の高いモデルでは、重要さの判断を任せるほうが固定ルールより効果的でした。
逆に古いモデルには、指示による誘導が効きました。Sonnet 4.6は記憶を読まないことが多く、仮説も検証していませんでした。回答前に記憶を読み、仮説を検証するよう指示すると、平均報酬は0.330(記憶なし)、0.364(記憶あり)から0.641へ伸びました。
Sonnet 5は指示なしでも10回中9回は記憶を読みました。Sonnet 4.6が読んだのは半分未満です。最先端モデルには、覚える価値があるときにメモを作るよう簡単に伝え、判断を任せるのが通常の方法です。
何を残すか:ポケモンで見えた量より質
『ポケットモンスター 赤』で、Claude Sonnet 3.7とClaude Fable 5の約1万ステップ時点の記憶を比べました。
Sonnet 3.7は手当たり次第に書き、225フォルダーに413ファイル、977,930文字を残しました。獲得バッジは1個です。細かな記録はすぐ古くなり、探す手間が増えました。約1万ステップ付近で4つ目の「master」記憶用フォルダーを作り始めると、続く17ステップで6ファイルを作って9ファイルを消し、ゲーム内の操作は一度もしていません。
Fable 5は計10ファイル・43,406文字で、バッジを4個獲得しました。所持金や現在地のように画面から読める情報は保存せず、戦略、計画、検証したルールを書き残しました。最上位の `global.md` には、現在の目標やジムの攻略計画を置いています。
たとえばコイキングの捕獲に7回続けて失敗した後、次のように書きました。「3回以上続けて失敗したら、タイミングを変える(メニュー操作の間に『待つ』入力を挟む)。こうした直後に捕獲できた」。Claude Opus 5.5も小さなメモを書き直しながら進め、ゲームをクリアしました。なお、Sonnet 3.7とFable 5の比較は各1回のプレイです。
社内文書のwiki:効く課題と効かない課題
wikiの効果は、Anthropicが5月に買収したStainlessの社内文書で調べました。約35万ファイル、約4億2000万トークンです。Opus 5のエージェントが128回のセッションでwikiを育て、25問で採点しました。
- wikiのみ:2セッション時の13%から、128セッションで48%に上昇
- wiki+検索ツール:54%から61%に上昇
- 検索ツールのみ:53%で横ばい
wikiと検索の併用で、1問あたり約2万トークンも節約できました。wikiは103ページ・766リンクから、222ページ・12,893リンクに育ちました。ドリーミングに使ったトークンは200万から1億2800万まで増やしています。
法務ベンチマーク「Harvey LAB」と企業合併の文書群でも比べました。24問のうち半数以上は複数文書から情報を集める必要があり、判断や計算を要する問いも多く含まれます。こうした項目に限ると、wiki参照が87%、検索のみが73%でした。
効かない場面もありました。1つの文書から検索で拾える採点基準が多い課題では、明確な差はありませんでした。別の課題では、10文書・115KBの資料から203KBのwikiができ、元の1.77倍に膨らみました。要約としてほとんど機能していません。
ドリーミングで誤りを直し、目的に合わせて作り直す
ポケモンの「おつきみやま」では、誤ったメモが行き先を左右しました。Claudeはポケモンセンターの位置を誤って記録し、一方通行の段差を降りて来た道に戻りました。ドリーミングでメモを作業記録と照合すると、誤りに気づいて書き直しました。
3,000回の累積操作までの結果は次のとおりです。
- 記憶+ドリーミング:1,935回目の操作でハナダシティに到着
- 修正前の記憶のまま:段差から3回落ち、ニビシティまで引き返した
- 記憶なし:ハナダシティに到達せず
ドリーミングは、記憶の育て方の方向づけにも使えます。企業買収を想定したLABの課題では、意見書が契約条件の正確さで採点されます。最初のwikiでは複数のエージェントが共有表 `provisions.md` を上書きし合い、条件が抜けました。結果は57項目中41項目(72%)でした。
Claudeが失敗を振り返り、wikiの作り方を書き直しました。契約書ごとに専用ページを作り、各ページは1エージェントだけが書き、条件は原文どおり引用する方式です。改良後は57項目中57項目(100%)を満たしました。
セッション横断の補修もできます。ある課題では、存在しないページ「escrow-agreement」への9本のリンクを、既存の「buyer-form-escrow-agreement」に付け替えました。索引などの3ページも追加し、wikiは38項目・225リンクから41項目・278リンクになりました。
仕事にどう生かすか
- Claude Codeを使う場合:毎回読ませるファイルは短い目次のように保ち、細部は別ファイルへ分けるのが良さそうです。
- エージェントを自分で組む場合:新しいモデルには記憶の場所と目的だけを伝え、細かなルールは決めすぎない。古いモデルには、回答前に記憶を読むことや仮説の検証を明示的に指示すると効果的です。
- 社内文書を扱わせる場合:wikiは情報が散らばる問いや判断を伴う問いで効きます。検索との併用が最も良い結果でした。
- 個人向けアシスタント:Claude Duetのような用途では、手伝う相手を中心に記憶を整理すると役立つ場合が多いようです。
Anthropicはドリーミング入門のクックブックとナレッジwikiのクックブックを公開しています。ドリーミングの料金や提供条件は公表されていません。
まだ分からないこと・限界
- いつ記憶を作るか:作業中に書けばすぐ使えるが、本来の作業から注意がそれる。ドリーミングは裏側で進むが、成果がすぐ使えない場合がある。
- どう最新に保つか:修正には計算資源が要り、全記憶の常時点検は現実的でない可能性がある。
- 検索を土台にする選択肢:wikiの維持には、誤りやハルシネーションをためない管理が要る。
- 未来は予測しきれない:どのモデルも、次に何が起きるかを本当には知り得ない。
いずれも特定の課題と条件での結果で、どの業務でも同じ効果が出るとは限りません。
まとめ
Anthropicの研究は、エージェントの記憶を、作業中のメモと後から整えるドリーミングの組み合わせとして示しました。新しいモデルは残す内容を自分で選べるようになった一方、誤りの修正やwikiの整備では見返す工程が成果を左右しています。AIに記憶を持たせるときは、目的を伝え、定期的に見直す仕組みまで用意するのが良さそうです。