はじめに
OpenAIは 2026年9月30日 、保護された推論を大量に抽出しようとした組織的な「敵対的蒸留」キャンペーンを公表しました。本稿では、侵害の範囲、確認された規模、帰属の留保、モデル提供者に残る課題を整理します。
参考記事
- タイトル: Disrupting a coordinated model distillation campaign
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年9月30日
- URL: https://openai.com/index/disrupting-a-coordinated-model-distillation-campaign
関連記事
要点
- OpenAIは、出力や推論を無許可で別モデルの訓練・改善へ使う敵対的蒸留キャンペーンを検知した。
- 暗号化やデータベースが破られたのではなく、会話操作により保護された推論を露出させようとした。
- 2026年7月24日 から25日には、4,000人超の利用者から約16,000件の試行が集中した。
- 中核はMoonshot AIのKimiに関係する個人とされたが、全実行者が同一主体かは確認されていない。
- OpenAIは 2026年7月28日 までに活動を阻止し、推論保護、監視、業界・政府との情報共有を強化した。
詳細解説
敵対的蒸留とは
モデル蒸留は、高性能モデルの出力を教師データとして小型モデルなどへ能力を移す手法です。許可された範囲なら一般的な開発手法ですが、OpenAIが問題視した敵対的蒸留は、保護された出力や推論を体系的かつ無許可で集め、別モデルを再現・改善・訓練する行為です。
今回の活動は 7月 1, 2026 に始まりました。通常の個別不正利用ではなく、多数のアカウントと共通するプロンプトを使い、モデル能力をまとめて抽出しようとした点が特徴です。
侵害されたもの、されていないもの
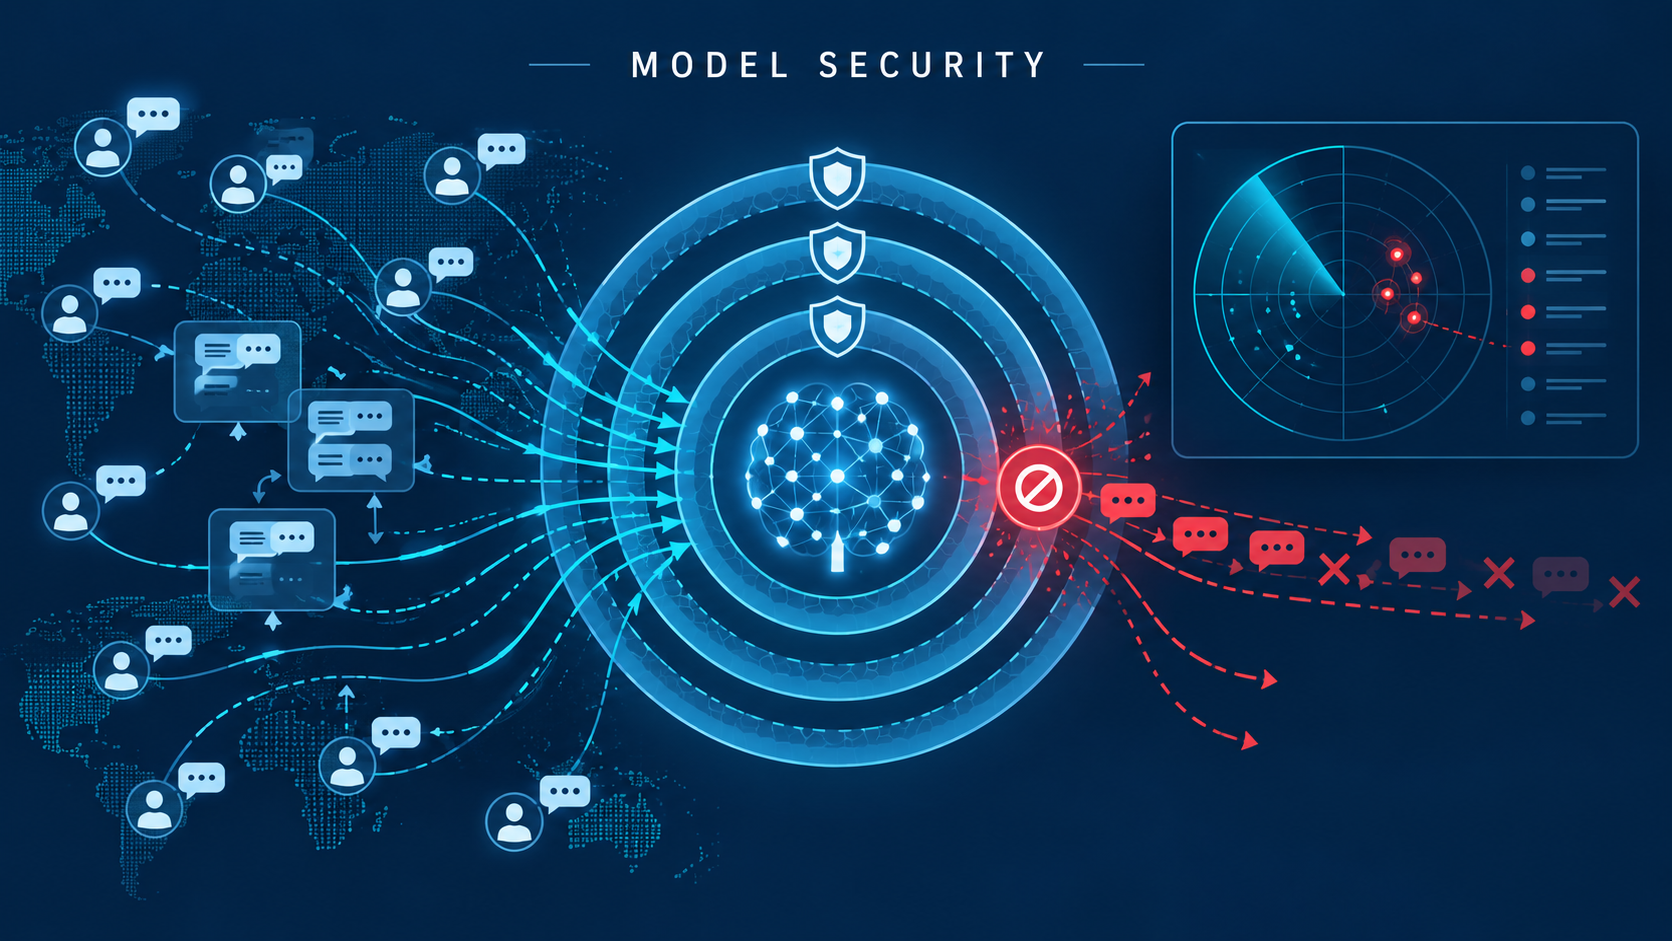
OpenAIの説明では、暗号化を破られたわけではなく、データベースへの侵入や一般ユーザーの会話への直接アクセスも確認されていません。攻撃者はモデルとの対話を操作し、本来は保護される推論過程を応答として表に出させようとしました。
この区別は重要です。サービス全体から個人情報が流出した事件ではなく、モデルの内部能力や推論データを競合モデルへ移すことが主な狙いだったためです。一方、抽出した能力が安全策を伴わず移転されれば、サイバー攻撃や国家安全保障上のリスクにつながります。
保護された推論を露出させた手口
確認された経路の一つでは、ある会話から得た暗号化済みの推論を別の会話へコピーし、復号または転記するよう求めていました。独立研究者からも、モデル間の対話や会話圧縮に関係する脆弱性が報告され、OpenAIは実在する経路だと確認しています。
これは、画面に推論を表示しないだけでは保護が完了しないことを示します。会話履歴の要約、外部ツールの返答、別モデルへの受け渡しを含むシステム全体で、保護情報が再び入力として現れないかを検査する必要があります。
16,000件の試行
活動は 2026年7月24日 から25日に急増し、4,000人超の利用者から約16,000件のリクエストが試みられました。さらに、関連するプロンプトパターンは15,000人超のクラスターへ広がっていました。OpenAIは 2026年7月28日 までに活動を全面的に阻止したとしています。
ただし、16,000件は「成功した抽出」の数ではなく、試行されたリクエストの数です。15,000人超という数字も、全員が同程度に関与したことを意味しません。規模の大きさと、実際に移転した能力の量は分けて読む必要があります。
帰属は限定付き
OpenAIは中核クラスターをMoonshot AIのKimiに関係する個人へ帰属しました。一方、関連するすべての実行者が単一の指揮系統で動いたか、企業全体が関与したかは明らかでないと留保しています。
不正活動の分析では、技術的な共通性、アカウント、インフラ、プロンプトの一致から帰属を絞れても、組織的な意思決定まで断定できない場合があります。本件も「関係者への帰属」と「企業による指示」を同一視しないことが重要です。
OpenAIが講じた対策
OpenAIは関連アカウントの停止・制限、登録時とインフラ面の制御、ネットワーク監視を実施しました。暗号化された推論を別の会話で再生する経路を閉じ、ストリーミング出力を一時的に保持して検査する措置も導入し、第三者サービスとも連携しています。
加えて、ユーザー、ワークスペース、組織、モデルファミリーを横断して隠れた推論の保護を強化しました。個々のアカウントだけでなく、共通パターンをキャンペーンとして検知する方針です。
モデル提供者に求められる対応
OpenAIはFrontier Model Forumや政府機関へ情報を共有し、抽出耐性、キャンペーン検知、執行、組織間連携を強めるとしています。パートナー提供環境でも本体と同等の保護を維持しなければ、保護の弱い経路が狙われます。
企業が外部モデルを採用する際も、通常の情報漏えい対策に加え、出力の大量収集、アカウント分散、会話間のデータ再投入を監視する必要があります。ツールを使うエージェントでは、表示テキストだけでなくツール出力や中間状態も保護対象になります。
まとめ
今回の事例は、モデルの価値が学習済みの重みだけでなく、推論時に生み出す情報にもあることを示しました。被害規模は試行件数と成功件数を分けて捉えつつ、会話、ツール、提携環境を横断した防御が必要です。企業側も大量取得や分散アカウントを継続的に監視する必要があります。