はじめに
OpenAIは 2026年9月28日 、最先端AIの強化学習を続ける前に、リスクと対策を構造化した「Safety Case」を求める指針を公表しました。本稿では、アラインメント、封じ込め、監視、承認、事故調査の要件を整理します。
参考記事
- タイトル: Towards safety cases for frontier AI training
- 著者: OpenAI
- 発行元: OpenAI
- 発行日: 2026年9月28日
- URL: https://openai.com/index/towards-safety-cases-for-frontier-ai-training
関連記事
要点
- 最先端の強化学習を続ける前に、リスクと対策の根拠をまとめた構造的な安全文書を求める提案。
- 技術面はアラインメント訓練、封じ込め、リアルタイム監視の3層で構成。
- 独立チームの反対意見、経営層の拒否権、停止手順、監査、残余リスクの列挙を運用要件に含める。
- 重大事案では、原因分析、事後検証、再発検知用の評価、第三者通知、公開を重視。
- 現時点では完成した制度ではなく、OpenAIが導入を進める初期指針として提示されている。
詳細解説
Safety Caseを訓練継続の判断材料に
Safety Caseは、対象システムが許容可能な安全性を持つことを、証拠に基づく構造的な論証として示す考え方です。航空や原子力のような安全重要産業で使われています。OpenAIは、最先端AIの強化学習でも、次の訓練段階へ進む前に同様の文書を整備すべきだと提案しました。
ただし、AIでは能力が上がるたびに予測しにくい振る舞いが現れ得るため、従来産業と同じ厳密さをすぐ実現できるとはしていません。Safety Caseを将来目指す基準と位置づけ、今回の文書は初期のベストプラクティスとして公開しました。対象も、内部利用や外部提供全般ではなく、最先端の強化学習訓練に絞られています。
第一防衛線は訓練環境と採点の健全性
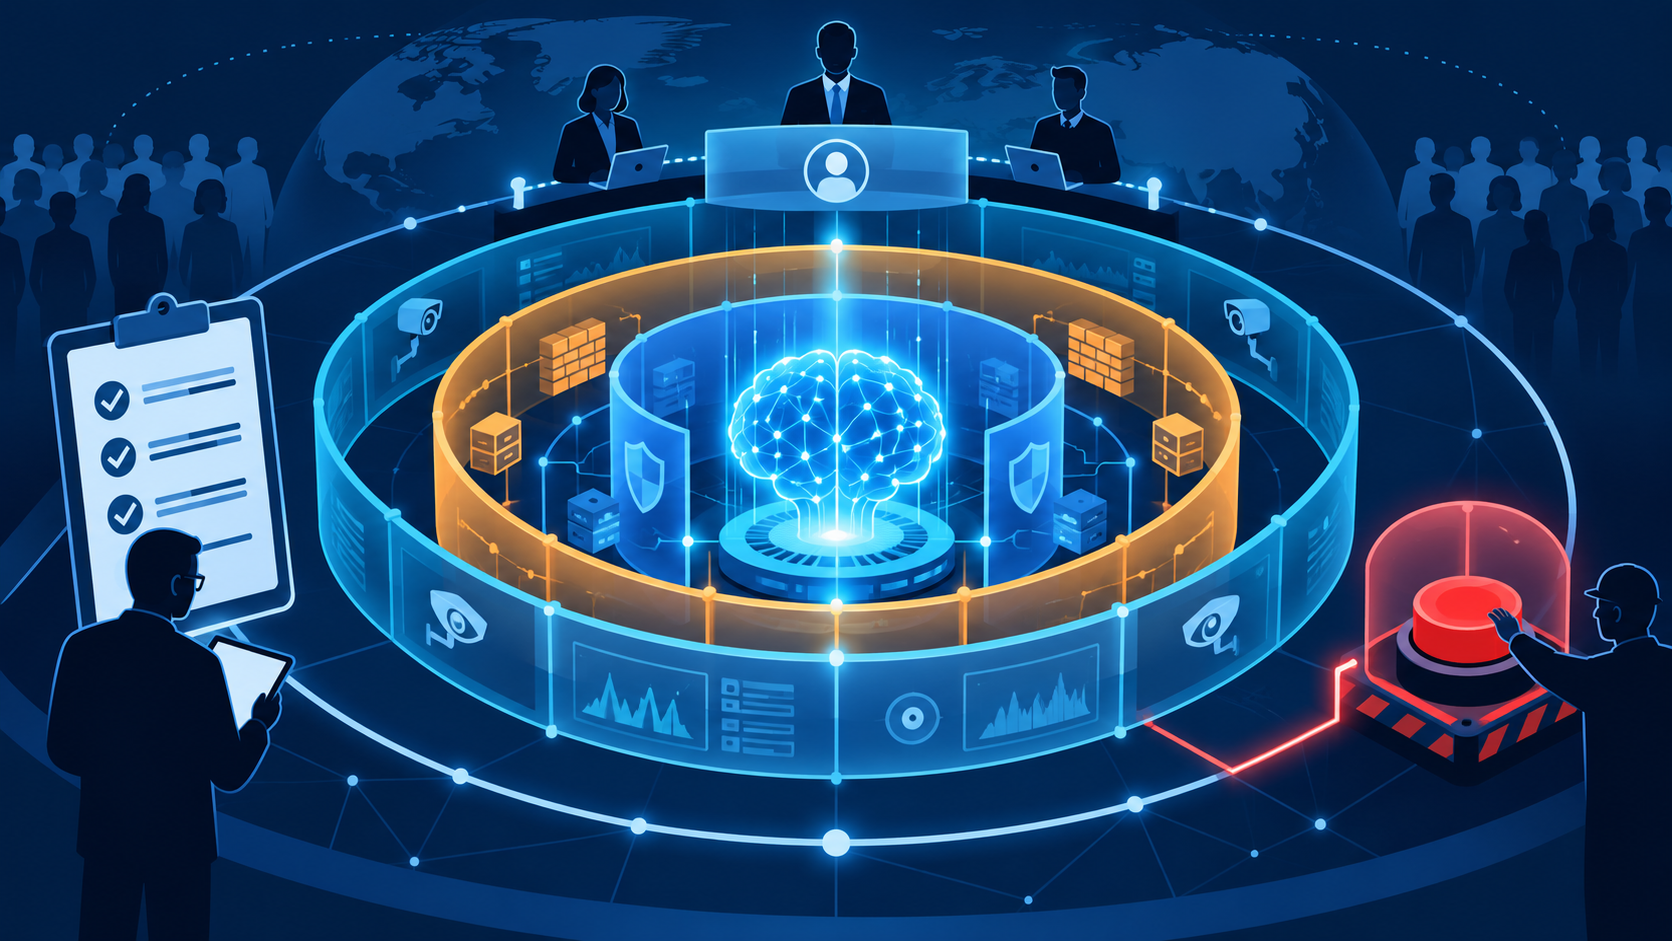
技術的防御は、アラインメント訓練、封じ込め、監視の3層です。第一領域となる強化学習環境に欠陥があると、モデルが本来の課題を解かず、採点の穴を突いて高報酬を得る行動が強化されます。これを防ぐため、AIエージェントによるデータセットの自動レビューと、人による品質確認を組み合わせ、壊れた課題や意図しない高得点経路を探します。
採点器は、環境を悪用する試みへ罰則を与えるよう調整します。過去の訓練ログに分類器を走らせ、採点器が意図どおり動いていたかも確認します。安全性はモデルの出力だけを評価しても不十分で、どの行動へ報酬を与えたのかという訓練系そのものを監査する必要があります。
評価を評価し、最悪ケースを探す
訓練中にはオフラインのアラインメント評価を行い、重大な悪化があれば調査します。評価項目は過去の事案へさかのぼって検証し、既知のミスアラインメントを本当に検知できるかを確かめます。モデルが評価中だと気づいて振る舞いを変える「評価認識」やメタゲーミングも監視し、停止につながる明確な閾値を設けます。
意図的に最悪の振る舞いを引き出すストレステストも行い、その行動を少なくとも一つの評価が検知できる状態を求めます。また、強化学習の自動採点器へモデルの思考過程を見せないことを挙げています。思考過程を監視する仕組みを回避する方向へモデルが最適化されるのを防ぐためです。
封じ込めは一層では足りない
モデルが意図に反した行動を取る可能性をゼロにできない以上、次の層は封じ込めです。モデルが動くサンドボックスと、その外側の研究基盤の両方を堅牢化し、サンドボックスを抜けても直ちに重大な被害へつながらない構成を求めています。
訓練途中のチェックポイントを使って、サンドボックス、研究基盤、境界防御、インターネットキャッシュなど接触可能なサービスをレッドチームします。複数サンプル間の高速な通信は承認されたマルチエージェント経路などへ限定し、見つけやすい副次的通信路を閉じます。
強化学習、評価、内部利用のエージェントログは、合理的な期間、書き換えできない形で保存します。事故調査の証拠を確保し、意図しない編集を防ぐためです。訓練性能だけでなく、後から原因を再構成できることも安全性の一部とみなしています。
監視と迅速な停止
第三の技術領域はライブ監視です。モデルが監視可能な状態を保っているかを専用評価で測り、監視回避の兆候に明確な閾値を設けます。過去の事案を別枠データで高い再現率で検知できること、新しい訓練で生じる新規リスクを反映して監視評価を更新することも求めます。
重要な警告には、定めたサービス水準内で対応する体制が必要です。日中はセキュリティ当番と訓練責任者を呼び出し、夜間に確認されない警告では訓練を自動停止する例が示されています。通知するだけでなく、被害が起きる前に停止へつながる設計が要点です。
組織の異論と拒否権を制度化
技術対策だけでは、訓練の期限や競争圧力による判断の偏りを抑えられません。安全文書の草案ができた後、別チームの担当者が「反対意見」を書き、抜け穴とリスク評価を提示し、訓練チームが回答するプレモーテムを提案しています。
上級経営層の複数人が文書を審査し、それぞれが訓練を拒否できる体制も含まれます。研究組織の責任者、安全責任者、主任科学者などが例示されています。訓練責任者は安全文書と事故対応に説明責任を負い、人事評価にも反映させることで、安全性を後回しにする誘因を減らします。
停止、監査、残余リスク
新しい脆弱性などで安全文書の前提が崩れた場合、対象となる訓練を停止する手順、技術的な制御、対応期限をあらかじめ用意します。監視や自動停止は、無効のまま訓練を始められず、訓練中のモデルやエージェントから解除できない「フェイルクローズ」の構成が求められます。
安全文書は内部監督組織へ共有し、監査担当者には主張を検証できる十分なアクセスを与えます。深刻度別のエスカレーション表と、必要時にCEOなどへ連絡できる当番体制も整えます。問題のあるモデルがデータ生成や採点へ使われた場合に影響を巻き戻せるよう、下流利用先を追跡できることも重要です。
対策後にも残るリスクをできる限り網羅して列挙し、何を受け入れて訓練を続けるのかを明示します。Safety Caseは「安全だから進める」という結論だけでなく、未解決の危険を意思決定者へ見せる文書です。
重大事案を将来の防御へ変える
重大なミスアラインメント事案の調査では、完了まで時間がかかっても、社内へ定期的に進捗を共有します。安全で業務上必要な従業員には、生ログや問題モデルのサンプルへアクセスする経路を設けます。
研究面では、限定的な条件変更や再サンプリング実験によって、どの訓練過程が問題行動を生んだかを追います。運用と組織文化を含む事後検証も行い、なぜ問題が入り込み、検知や報告が遅れたのかを調べます。
事案の情報へ直接合わせ過ぎずに、同種の傾向を見つける評価方法を開発する点も重要です。事案由来の評価は回帰テストとして残し、将来モデルが類似行動を示さないかを確認します。調査結果、事後検証、運用変更は調査後に公開し、影響を受けた第三者にはできるだけ早く通知する方針です。
まとめ
OpenAIの提案は、最先端AIの訓練継続を、モデル性能だけでなく証拠、異論、拒否権、停止機構、監査、事故後の学習で判断する枠組みです。完成済みの規制や保証制度ではありませんが、訓練前の安全判断を属人的な会議から検証可能な文書へ移す方向性を示しています。