はじめに
IBM Think(IBM社の情報発信メディア)が2026年7月8日に公開した記事は、AIの内部構造を「巨大な表計算ソフト」にたとえて解説しています。本稿では、この記事をもとに、大規模言語モデル(LLM)の仕組みと、ブラックボックス性を巡る最新の研究動向を紹介します。
参考記事
- タイトル: What does AI look like?
- 著者: David Zax
- 発行元: IBM Think
- 発行日: 2026年7月8日
- URL: https://www.ibm.com/think/news/what-does-ai-look-like
関連記事
要点
- AIモデルの内部は、パラメータ(重み)と呼ばれる大量の数値が並ぶ巨大な行列(スプレッドシート)の集合体である
- GPT-3は577個の行列、合計1750億個のパラメータで構成され、最初の行列は単語を数値化する「埋め込み」の役割を担う
- 学習(トレーニング)は次の単語の予測誤りを繰り返し修正する過程であり、AIモデルは人間が設計するのではなく育てられるものである
- Anthropicの研究チームは、Claudeの内部から3,000万個の「概念」を抽出しており、モデルの安全性に関わる要素も特定されている
- LLMは1単語ずつ出力を生成する仕組みでありながら、押韻を先読みするなど計画的な振る舞いをする痕跡が確認されている
詳細解説
AIの正体は「巨大な表計算ソフト」
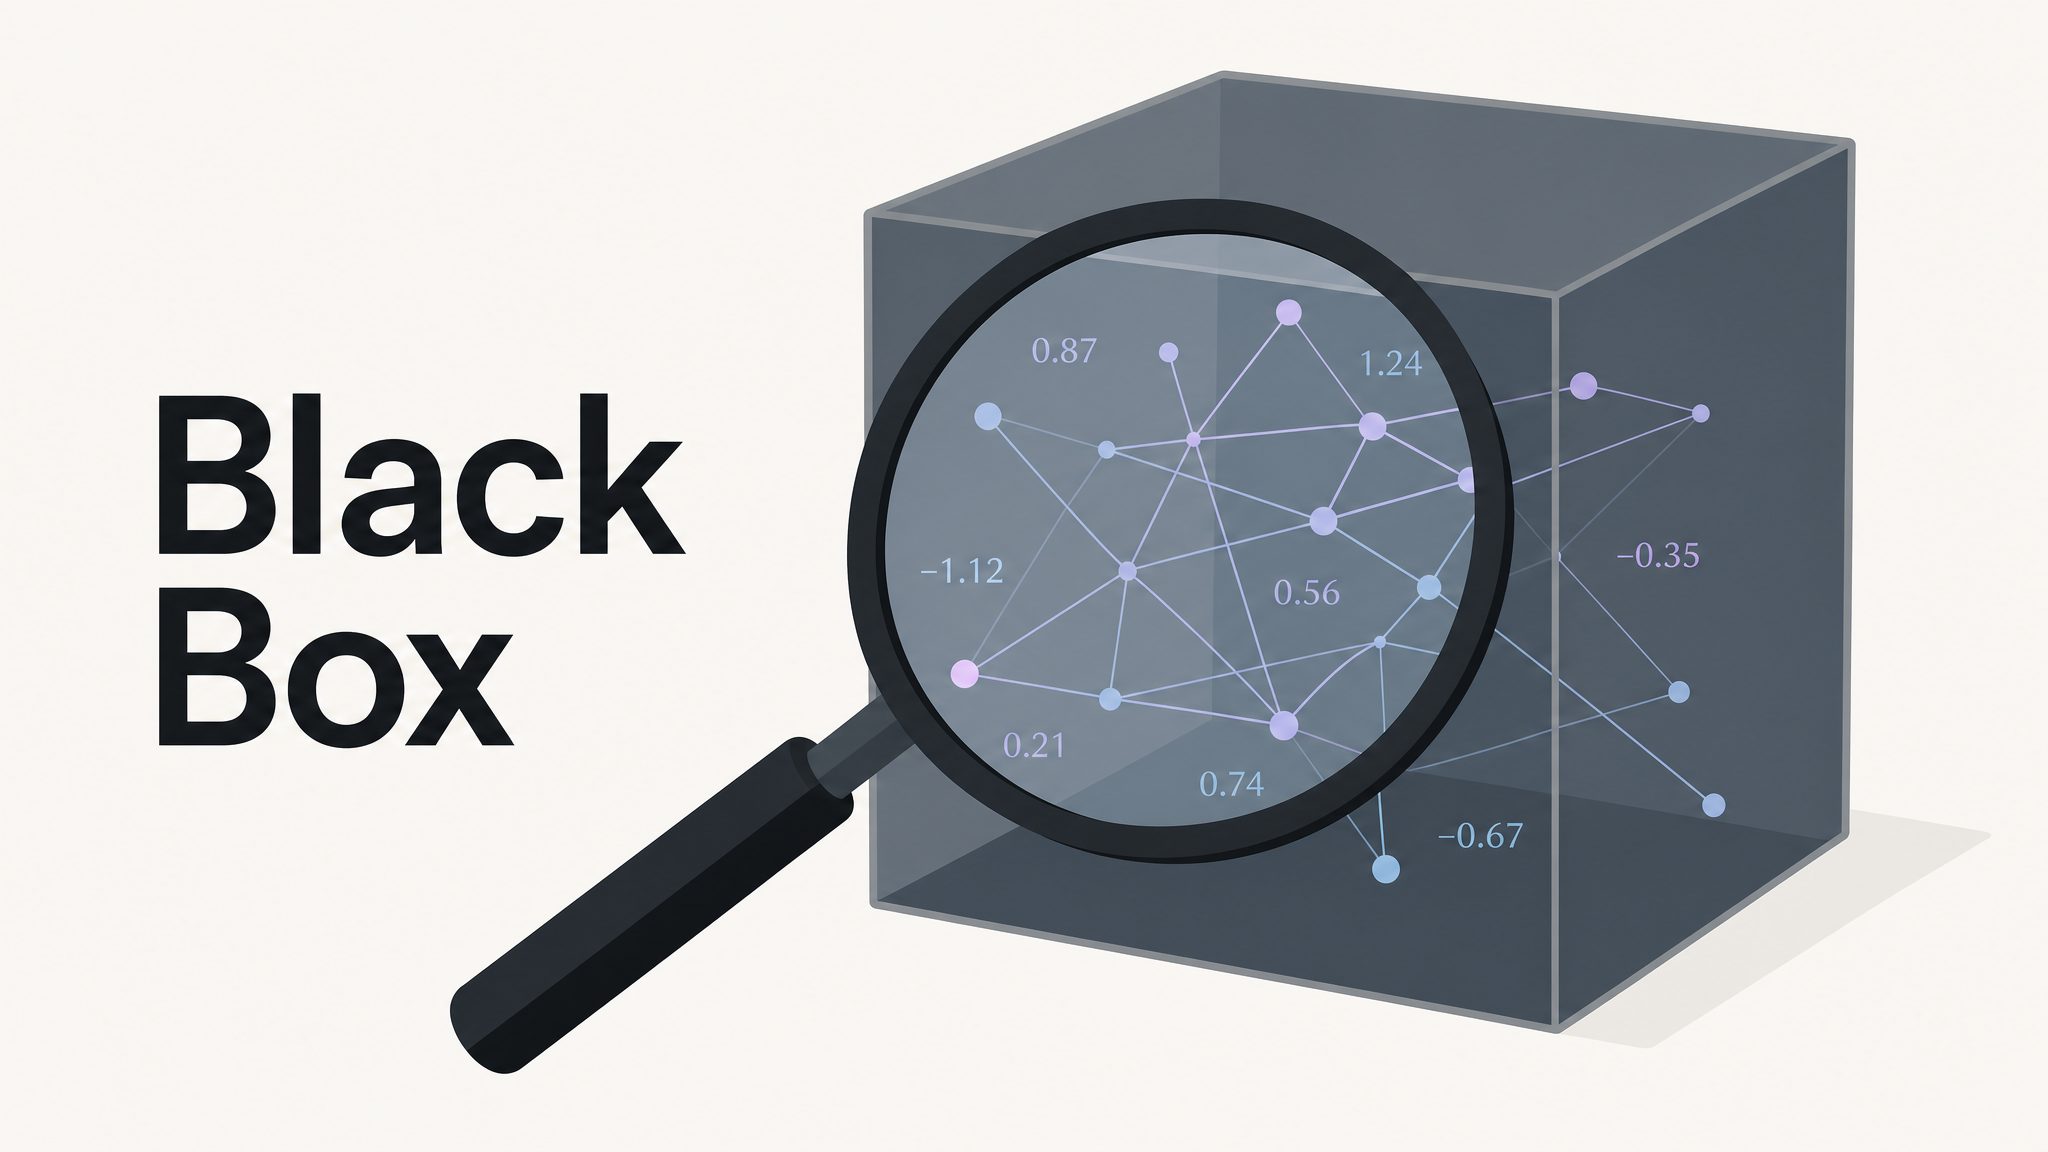
IBM Thinkの記事によれば、ChatGPTやClaudeのような大規模言語モデル(LLM)の内部は、突き詰めると数値がびっしり並んだ行列(スプレッドシート)の集合体だといいます。記事が取り上げているOpenAIのGPT-3の場合、577個の行列があり、各セルには-1.0から1.0程度の小さな数値が入っています。これらの数値は「パラメータ」または「重み」と呼ばれ、合計すると1750億個にのぼるとのことです。
行列という言葉は取っつきにくく感じられるかもしれませんが、要は「大量の数字の表」だと捉えると理解しやすいと思います。実際、モデルのサイズが大きくなるほど表の数や大きさも増えていき、GPT-4は2兆個ものパラメータを持つとうわさされているとのことです。
単語を数値に変換する「大辞典」
577個の行列のうち、最初の1つは特別な役割を持っています。IBM Thinkの記事では、この行列を「Great Dictionary(大辞典)」と呼び、5万を超える単語のそれぞれに12,288個の数値の並び(行)を割り当てていると説明しています。専門用語では「埋め込み(embedding)」と呼ばれる仕組みです。
興味深いのは、これらの数値が人間によって意味ごとに割り振られたものではないという点です。IBM Thinkの記事は、Anthropicの共同創業者Chris Olah氏の「私たちはニューラルネットワークをプログラムしているのではなく、いわば育てている」という趣旨の発言を紹介しており、AIモデルが設計ではなく学習によって形づくられることを示しています。
学習の仕組み:失敗から数値を鍛える
モデルの学習(トレーニング)は、最初はすべての数値がランダムな状態から始まり、次に来る単語を予測させては、正解と照らし合わせて数値を少しずつ修正していく作業だと記事は説明しています。この修正作業は「勾配降下法」と呼ばれる手法で、GPT-3の学習では数十万回にわたって繰り返されたそうです。
この過程を経て、577個の行列は次第に「文の主語か目的語か」「食べ物なのか動物なのか」といった文脈的な意味を捉えられるようになるといいます。ある単語が入力されると、行列を何層も通過するたびに意味がより具体的に絞り込まれていく、というのが記事の説明です。
1単語ずつの生成なのに、先読みしている?
LLMは応答を一気に生成するのではなく、1単語ずつ生成しては、それを新たな入力に加えて再度計算し直すという工程を繰り返しています。IBM Thinkの記事では、この地道な繰り返しが、複数語からなる自然な文章を生み出す仕組みだと紹介されています。
注目すべきは、Anthropicが2025年に発表した研究「Tracing the thoughts of a large language model」を引用し、Claudeに押韻の対句を作らせた際、最後の単語を出力するよりも前の段階から、韻を踏む単語に関連する内部パターンがすでに活性化していたことが確認された点です。1単語ずつしか出力しない仕組みでありながら、ある程度先を見越した振る舞いをしていることになります。
ブラックボックスの中を覗く:解釈可能性研究の進展
AnthropicのCEOであるDario Amodei氏は、AIモデルの内部で何が起きているかを人間が十分に理解できていないという課題をかねてより指摘しています。IBM Thinkの記事によれば、Anthropicの研究チームは2024年以降、Claudeの内部から自動的に「概念」を抽出する手法を確立し、これまでに3,000万個の概念を特定したとされています。
抽出された概念の中には、モデルがフィッシングメールを書く意欲に関わるものなど、安全性に直結する要素も含まれているといいます。こうした研究分野は「解釈可能性(interpretability)」と呼ばれ、AIの性能向上と同じくらい重要な取り組みだとAmodei氏は位置づけています。この考え方は、Anthropicが提言する透明性フレームワークの内容とも通じるところがあるように思います。
まとめ
AIは「ブラックボックス」と言われがちですが、IBM Thinkの記事が示すように、内部は巨大な数値の集合体であり、その仕組みを解き明かす研究は着実に進んでいます。LLMがなぜ思わぬ振る舞いをするのか気になる方は、ChatGPTがチェスで敗れた理由を探った過去記事でも整理していますので、あわせてご覧いただければと思います。