はじめに
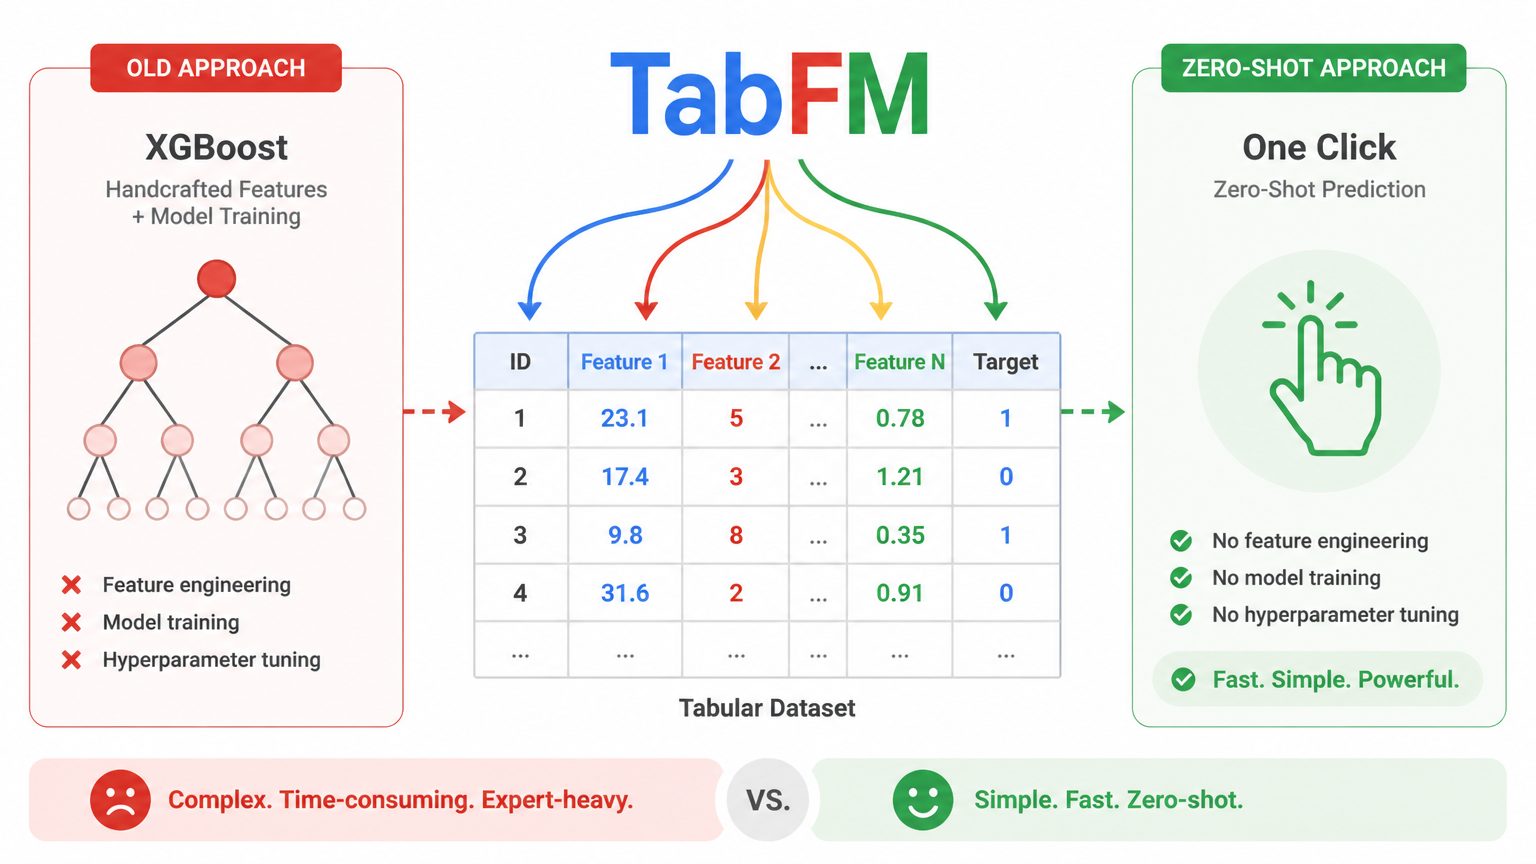
GoogleのWeihao KongとAbhimanyu Dasが2026年6月30日、表形式データ(テーブルデータ)向けの基盤モデル「TabFM」をGoogle Researchブログで発表しました。機械学習の在り来たりな訓練・チューニング作業を不要にし、ゼロショットで高精度な予測を実現するという本モデルの仕組みと性能について解説します。
参考記事
- タイトル: Introducing TabFM: A zero-shot foundation model for tabular data
- 著者: Weihao Kong、Abhimanyu Das(Research Scientists, Google Research)
- 発行元: Google Research Blog
- 発行日: 2026年6月30日
- URL: https://research.google/blog/introducing-tabfm-a-zero-shot-foundation-model-for-tabular-data/
関連記事
要点
- TabFMは、表形式データの分類・回帰タスクをゼロショットで実行できる基盤モデルであり、従来のXGBoostなど木構造アルゴリズムが必要としていたハイパーパラメータ調整と特徴量エンジニアリングを不要にする
- 技術的には「In-Context Learning(文脈内学習)」として定型化し、TabPFNとTabICLの長所を組み合わせたハイブリッドアーキテクチャを採用している
- 数億規模の合成データセット(構造的因果モデルで生成)で事前学習しており、未知の実世界テーブルへの汎化性能を実現している
- 38件の分類データセットと13件の回帰データセットを対象としたTabArenaベンチマークで、重量級のチューニング済み競合モデルを上回るEloスコアを記録した
- Google BigQueryへの統合が予定されており、AI.PREDICT というSQL文で機械学習の専門知識なしに高度な予測が実行できるようになる
詳細解説
表形式データ予測の課題——なぜXGBoostでは不十分か
表形式データ(スプレッドシートやデータベーステーブルのような行と列で構成されたデータ)は、企業のデータインフラの根幹を担い、顧客離脱予測や金融不正検知など幅広い業務予測に使われています。これまでXGBoost、AdaBoost、ランダムフォレストといった木構造ベースの教師あり学習アルゴリズムがこの分野を牽引してきました。
しかし、こうした従来手法にはデプロイのボトルネックが存在します。XGBoostを新しいデータセットに適用する際は、単に .fit() を呼ぶだけでは不十分で、データサイエンティストが膨大な時間をかけてハイパーパラメータを最適化し、ドメイン固有の特徴量エンジニアリングを施す必要があります。このプロセスは、モデルを一から作り直す度に繰り返さなければならず、実務上の大きなコストになっていました。
一方、大規模言語モデル(LLM)の台頭がもたらした「ゼロショット予測」の概念は、この状況を変える可能性を示しています。事前学習済みモデルが、重みを更新することなくプロンプト内の例示と指示だけで新タスクに対応する In-Context Learning(ICL)という手法です。TabFMはこのICLの考え方を表形式データに適用した基盤モデルです。
TabFMのアーキテクチャ——3つの中核機構
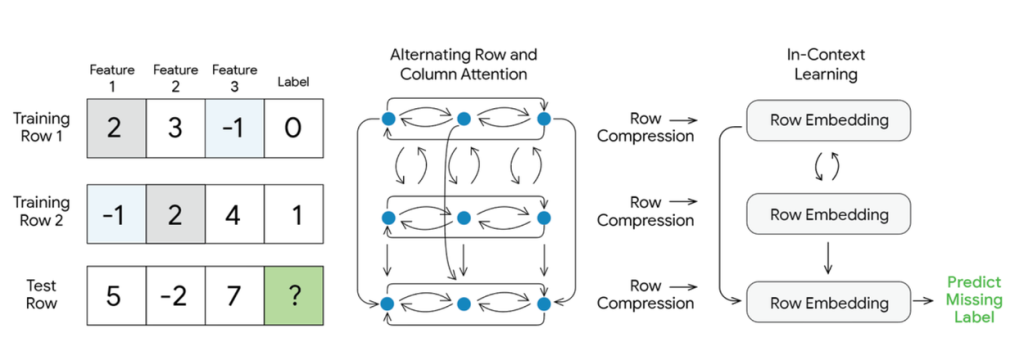
自然言語テキストとは異なり、表形式データは2次元かつ本質的に順序を持たない構造をしています。行や列の並びを入れ替えてもデータの意味は変わらないため、通常の言語モデルで扱うことが難しいという特性があります。TabFMはこの課題に対応するため、TabPFNとTabICLのアーキテクチャを組み合わせたハイブリッド設計を採用しています。
具体的には3つの機構が連動します。まず 交互の行・列アテンション によって生の表データを処理します。特徴(列)と事例(行)の2次元にわたって交互にアテンションを適用することで、手作業による特徴量エンジニアリングなしに複雑な特徴間の相互作用を学習します。次に 行圧縮 によって、各行のクロスアテンション済み情報を1つの密なベクトルに圧縮します。最後に In-Context Learning として、この圧縮された行ベクトルのシーケンスに対してTransformerが動作し、予測を行います。生の非圧縮グリッドではなく圧縮済みベクトルに対してアテンションを計算することで、大規模データセットでも計算コストを抑えることができます。
合成データによる大規模事前学習
基盤モデルを構築するには大量の多様なデータが必要ですが、表形式機械学習の領域には高品質な大規模データセットが乏しいという問題があります。産業用テーブルは独自スキーマや機密情報を含み、オープンソースとして公開されにくいためです。
TabFMはこの制約を回避するために、数億規模の合成データセットで完全に事前学習されています。これらのデータセットは構造的因果モデル(SCM)を用いて動的に生成されており、実世界の表形式データに見られる多様な分布と複雑な特徴量関係を幅広くカバーしています。合成データは任意の大きさで生成できるため、事前学習の規模を担保できる唯一の現実的な選択肢でもあります。
TabArenaベンチマークでの性能評価
TabFMの性能評価には TabArena という生きたベンチマークシステムが使われています。TabArenaはモデル同士の1対1の勝率に基づくEloスコアを算出する形式で、分類38件・回帰13件(サンプル数700〜15万件)の多様なデータセットで評価されました。
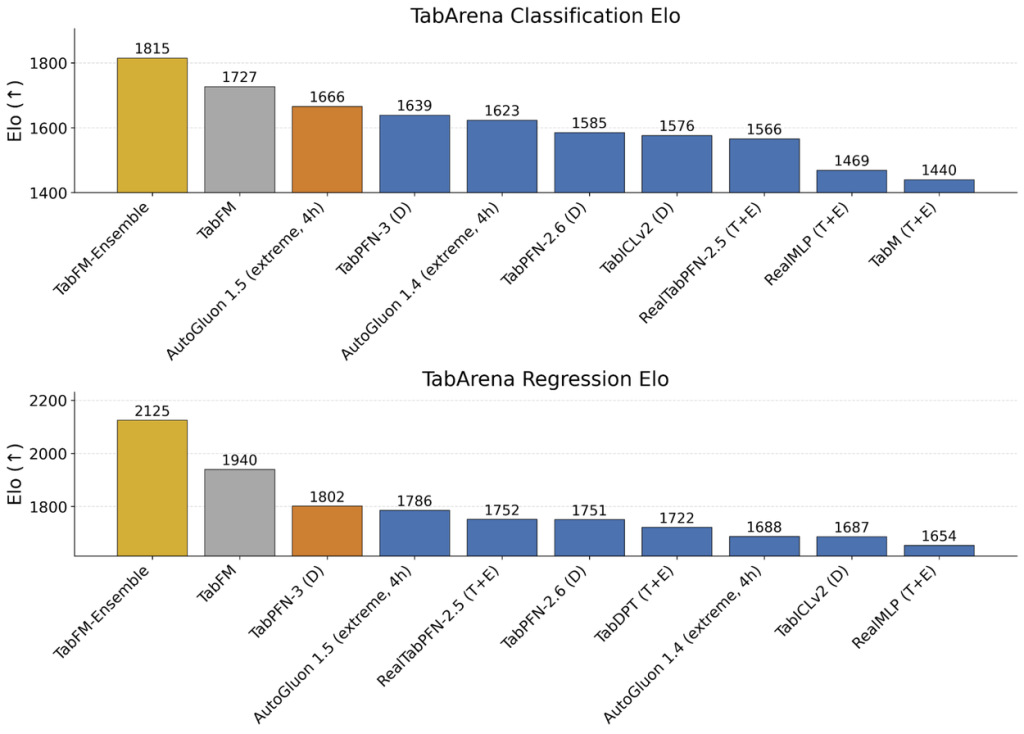
評価は2つの構成で実施されました。TabFM(標準設定)はチューニングなしの単一フォワードパスで予測を生成します。TabFM-Ensembleはクロス特徴量とSVD(特異値分解)特徴量を追加し、32通りのアンサンブルの最適な重みを非負最小二乗法で計算します(分類タスクではPlattスケーリングによるキャリブレーションも追加)。
Google Researchによれば、どちらの構成も重量級のチューニング済み競合モデルを含む上位10モデルの中で高いEloスコアを記録しています。単一フォワードパスで高精度が出る点は、実運用での導入障壁を下げる意味で注目に値すると思います。詳細なベンチマーク結果はGitHubで公開されています。
BigQueryへの統合——SQL一行で予測実行
TabFMは今後数週間のうちにGoogle BigQueryへ統合される予定です。これが実現すると、ユーザーは AI.PREDICT というSQL文を記述するだけで、高度な回帰・分類予測をBigQuery上で実行できるようになります。機械学習の専門知識を持たないデータアナリストやビジネスユーザーにとっても、企業データに対する予測分析がより身近なものになると考えられます。
まとめ
TabFMは、表形式データの予測タスクをICLとして定式化することで、従来の教師あり学習が抱えていた反復的な訓練・調整コストを解消するアプローチです。BigQueryとの統合が完了した際の実用性は、特に機械学習の専門家を持たない組織にとって注目したいところです。表形式データの活用に関心がある方は、GoogleのNotebookLMが追加した表形式整理機能の記事もあわせてご覧いただければと思います。