はじめに
NVIDIAが2026年6月17日、Google DeepMindのオープンモデル「DiffusionGemma」を最適化し、GeForce RTX GPUやDGX Sparkなどのローカル環境で高速動作させる取り組みを発表しました。従来のLLMとは異なる「拡散」方式でテキストを生成するこのモデルの仕組みと、NVIDIA環境での性能について解説します。
参考記事
- タイトル: NVIDIA、ローカル AI の実現に向けて Google DeepMind の DiffusionGemma を高速化
- 著者: Michael Fukuyama
- 発行元: NVIDIA 公式ブログ(日本語版)
- 発行日: 2026年6月17日
- URL: https://blogs.nvidia.co.jp/blog/rtx-ai-garage-local-gemma-diffusion/
関連記事
要点
- DiffusionGemmaは、テキストをトークン1つずつではなく最大256トークンを並列にノイズ除去する拡散方式で生成する実験的オープンモデルである
- Gemma 4(260億パラメータのMoEモデル)をベースに拡散ヘッドを組み合わせて構築されており、Apache 2.0ライセンスで公開されている
- NVIDIAの最適化により、同等の自己回帰モデルと比較してシングルユーザー環境で最大4倍近い速度を実現している
- NVIDIA H100で毎秒1,000トークン、DGX Sparkで毎秒150トークンの推論速度を記録している
- Hugging Face Transformers・vLLM・Unslothでリリース初日からサポートされており、クラウド不要でローカル実行が可能である
詳細解説
拡散方式とはどのようなテキスト生成か
現在主流の大規模言語モデル(LLM)は「自己回帰型」と呼ばれる方式をとっており、テキストを1トークン(単語や記号などの最小単位)ずつ順番に生成します。この逐次処理は、モデルが対話中にタイピングしているように見える理由の一つです。
DiffusionGemmaはこれとは異なる「拡散(Diffusion)」方式を採用しています。拡散モデルはもともと画像生成の分野で広く使われてきた手法で、ノイズから出発して対象物を段階的に精緻化していくアプローチです。DiffusionGemmaはこれをテキスト生成に応用し、最大256トークンのブロック全体を一度に並列でノイズ除去しながらテキストを出力します。Gemma 4の260億パラメータのエキスパート混合(MoE)アーキテクチャに拡散ヘッドを組み合わせた構造で、1ステップあたりアクティブになるのは38億パラメータです。
なぜNVIDIA GPUで効果的に動作するのか
従来の自己回帰型LLMでシングルユーザー処理を行うと、1トークンずつ逐次的にメモリアクセスが発生するため、「メモリ律速」の状態になりやすいとNVIDIAは説明しています。つまり、GPUが持つ大量の並列演算能力を十分に活用できないまま、メモリ帯域幅の待機に時間を費やすことになります。
これに対してDiffusionGemmaは、256トークンのブロックをTransformerで並列処理するため「演算律速」のワークロードとなります。この特性はNVIDIA GPUが最も得意とする処理形態であり、Tensor コアと CUDAソフトウェアスタックの特性をそのまま生かすことができます。この構造的な相性の良さが、大きな速度向上につながっていると考えられます。
各ハードウェアでの実測パフォーマンス
NVIDIAの発表によれば、DiffusionGemmaは以下の推論速度を達成しています。
- NVIDIA H100 Tensor コア GPU: 毎秒1,000トークン
- NVIDIA DGX Spark: 毎秒150トークン
- DGX Station: 毎秒最大800トークン(クラス最高水準)
これらの数値は、同一のシングルユーザー環境で動作する同等の自己回帰モデルと比べて最大4倍近い速度に相当します。DGX SparkはNVIDIA GB10 Grace Blackwell Superchipと128GBの統合メモリを搭載したデスクサイド型のパーソナルAIスーパーコンピューターで、ローカルでのプロトタイピングやエージェントワークフローに対応できる環境です。GeForce RTX GPUについてはllama.cppのサポートが近日予定されており、より広範なコンシューマー向け利用も視野に入れていることがわかります。
利用開始の方法とライセンス
DiffusionGemmaはApache 2.0ライセンスのオープンウェイトモデルとして公開されており、商用利用も含めた幅広い用途に対応しています。Hugging Face Transformers、vLLM、Unslothで既にサポートされており、GeForce RTX 5090やDGX SparkであればHugging Faceから直接利用を始めることが可能です。より高スループットが必要な場合はvLLMが選択肢となります。ファインチューニングにはUnslothやNVIDIA NeMoフレームワークが利用できます。また、build.nvidia.comではNVIDIAがホストするAPIを通じた無料テストも提供されています。
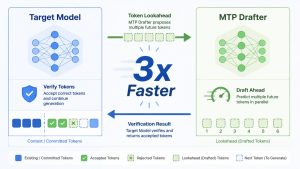
Gemma 4の推論を高速化するMTPドラフターを使ったSpeculative Decodingの手法については、過去記事でも整理していますので、あわせてご覧いただければと思います。
まとめ
DiffusionGemmaは、画像生成で実績ある拡散方式をテキスト生成に応用した実験的モデルであり、NVIDIAのGPUアーキテクチャとの相性の良さから、ローカル環境でも高速なテキスト生成が期待できます。「実験的」という位置づけではあるものの、オープンウェイトかつローカル動作という特性は、プライバシーやコスト面で魅力的な選択肢になると思います。今後の品質向上と対応ハードウェアの拡大に注目したいところです。