はじめに
Metaが2026年4月8日、最先端AIの開発・評価プロセスを定めた「Advanced AI Scaling Framework」の改訂版を公開しました。あわせて、同社の新モデル「Muse Spark」に関する安全性評価レポートの公開も予告しています。本稿では、この発表内容をもとに、同フレームワークの概要と安全性への新アプローチを解説します。
参考記事
- タイトル: Scaling How We Build and Test Our Most Advanced AI
- 著者: Meta AI
- 発行元: Meta AI Blog
- 発行日: 2026年4月8日
- URL: https://ai.meta.com/blog/scaling-how-we-build-test-advanced-ai/
要点
- Metaは従来の「Frontier AI Framework」を大幅に強化した「Advanced AI Scaling Framework」を公開した
- 新フレームワークは化学・生物兵器リスク、サイバーセキュリティ、制御喪失リスクの3領域を重点評価対象として追加または強化した
- 新モデル「Muse Spark」向けに「Safety & Preparedness Report(安全性・準備状況レポート)」を導入し、評価結果を透明性をもって公開する方針を打ち出した
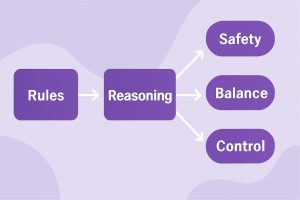
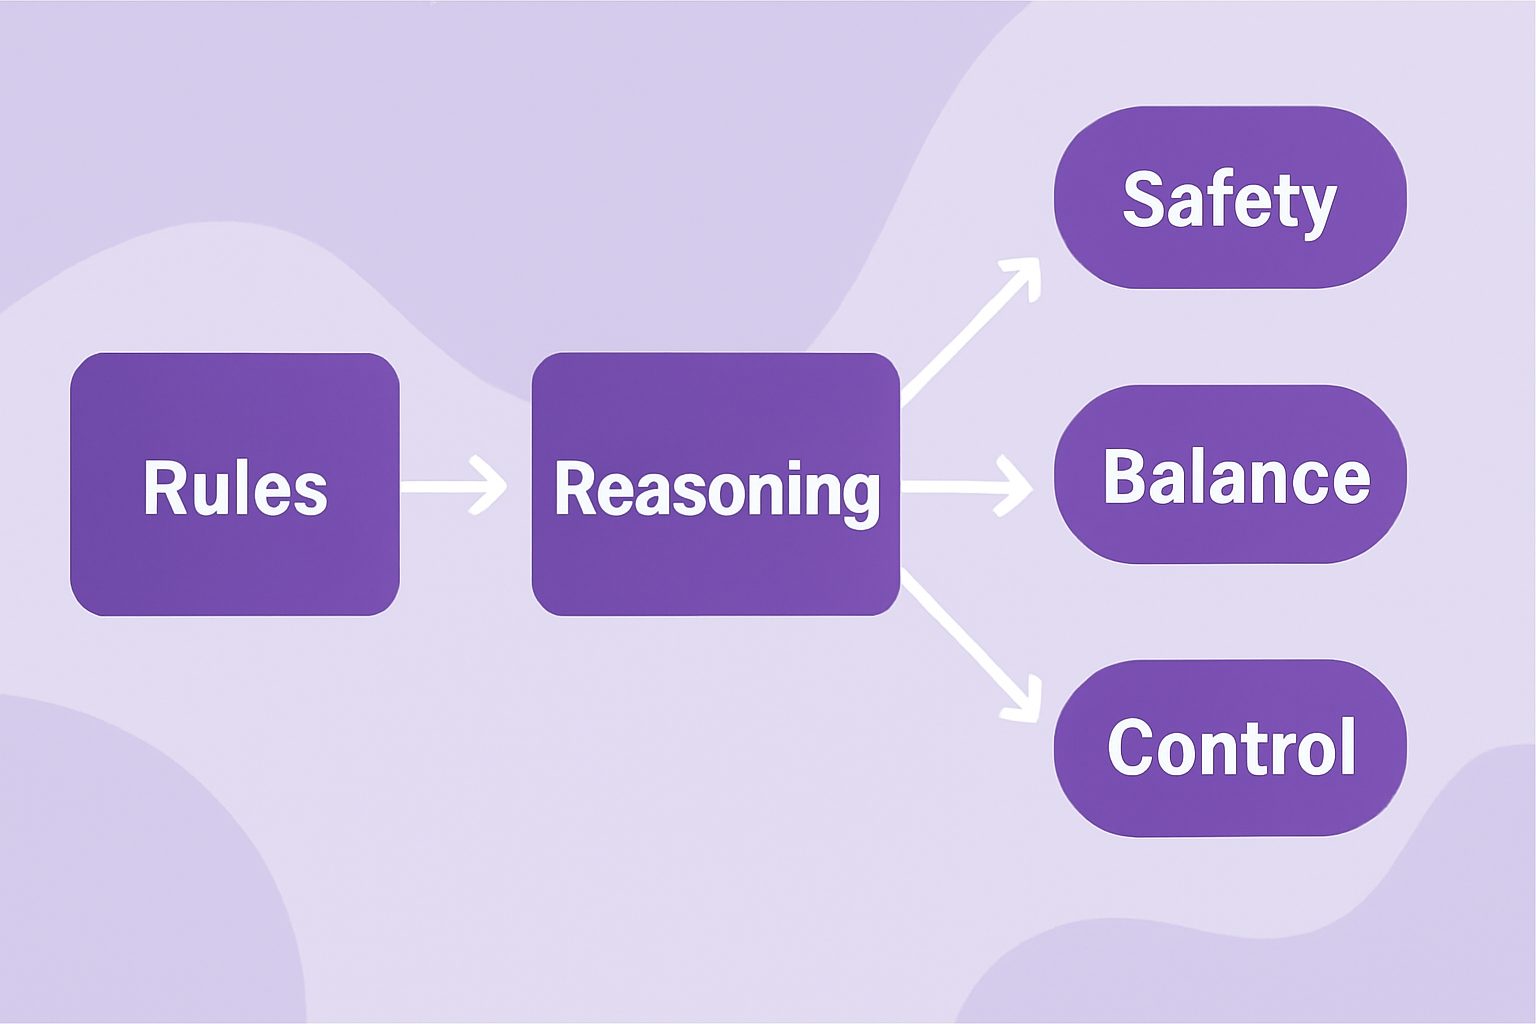
- 従来のルールベースの安全訓練から、モデルが安全である「理由」を理解する推論ベースの訓練へと移行した
- 安全性評価はデプロイ前後の両フェーズで実施し、本番環境でも自動モニタリングが継続される
詳細解説
Advanced AI Scaling Frameworkとは
Metaはこれまで「Frontier AI Framework」と呼ばれる社内の安全性指針を運用してきましたが、今回その大幅な改訂版として「Advanced AI Scaling Framework v2」を公開しました。
新フレームワークの主な変更点は3点です。
第一に、評価対象リスクの拡充で、化学・生物リスクやサイバーセキュリティに加え、制御喪失リスク(Loss of Control) という新たな評価領域が設けられました。制御喪失リスクとは、AIモデルが高い自律性を付与された際に、人間の意図から外れた行動を取る可能性を指します。AIエージェントの活用が広がるにつれ、業界全体でこの領域への注目が高まっており、Metaもその評価を正式に組み込んだ形です。
第二に、デプロイ意思決定プロセスの強化です。モデルはセーフガード適用前と適用後の両段階で評価され、実際の動作環境で保護機能が機能することを確認してからのみ公開されます。オープンなモデル、限定APIアクセス、クローズドモデルのいずれにもこの基準が適用されます。
第三に、「Safety & Preparedness Report(安全性・準備状況レポート)」の導入です。リスク評価の内容、評価結果、デプロイ判断の根拠、現時点での課題などを外部に公開することで、透明性の向上を図ります。
Muse Sparkに対する安全性評価の内容
Metaの新モデル「Muse Spark」は、高度な推論能力を持つことを特徴とします。Metaによれば、このモデルに対して数千のシナリオを用いた多層的な評価が実施されました。
評価は、サイバーセキュリティや化学・生物兵器といった深刻なリスク領域だけでなく、暴力、児童安全、犯罪行為への悪用防止、そしてイデオロギー的バランス(特定の思想的立場への偏りがないこと) の観点にも及びました。Metaは、評価の結果としてMuse Sparkがイデオロギー的バイアスを避ける点で最前線水準にあることを確認したと述べています。
また、モデルが制御困難なレベルで自律的に行動する能力を持つかどうかについても検証が行われ、現時点ではそのリスクに相当する自律能力は備えていないと確認されたとしています。本番環境のトラフィックについても、自動モニタリングシステムによって予期しない問題を素早く検知できる体制が整えられています。
「ルール」から「理由の理解」へ——安全訓練の新アプローチ
今回の発表で特に注目に値するのが、安全性訓練の手法そのものの転換です。
従来のアプローチでは、「特定の質問には答えない」「信頼できる情報源に誘導する」といったシナリオを個別に学習させる方式が主流でした。これは一定の効果を上げてきた一方、想定外の新しい状況への対応が難しいという課題がありました。
Metaによれば、Muse Sparkではモデルの推論能力を活かし、コンテンツ安全性、会話の安全性、応答品質、異なる視点への対応といったガイドラインを「検証可能な原則」に翻訳した上で、なぜそれが安全なのかという理由ごとモデルに学習させる方式を採用しました。ルールを覚えるのではなく、その背後にある考え方を理解させることで、ルールベースのシステムが対処しきれなかった新しい状況にも対応できるようになると考えられます。
ただし、この新手法が人間の監視を不要にするわけではない点は強調されています。Metaは「この取り組みは人間の監視を置き換えるものではなく、むしろそれを高める」と述べており、設計・検証・追加ガードレールの実装という形で人間の関与が維持されます。
透明性と継続的な取り組み
今回のフレームワーク更新とSafety & Preparedness Reportの導入は、AI安全性に関する外部への説明責任を高めようとする姿勢の表れと言えます。評価で発見した問題点、評価の限界、そしてその改善方法まで含めて公開する方針は、安全性をめぐる業界全体の議論を前進させる一歩として評価できるかもしれません。
一方で、公開されるレポートの詳細な内容はまだ示されておらず、透明性の実質的な水準については今後の公開を待って判断する必要があると思います。
まとめ
MetaはAdvanced AI Scaling Frameworkの改訂を通じて、最先端モデルの安全性評価体制を体系化し、その内容を外部に公開する姿勢を明確にしました。特に、推論能力を活かして「理由」ごと安全性を学習させる訓練手法の転換は、今後のAI安全性研究においても注目される取り組みだと思います。Muse Sparkの詳細なSafety & Preparedness Reportの公開が今後予定されており、その内容が業界標準にどのような影響を与えるかが気になるところです。