はじめに
MetaのAI研究部門「Meta Superintelligence Labs」が2026年4月8日、新しいマルチモーダル推論モデル「Muse Spark」を発表しました。本稿では、発表内容をもとに、Muse Sparkの主要機能、性能、スケーリング戦略、そして安全性評価の概要を解説します。
参考記事
- タイトル: Introducing Muse Spark: Scaling Towards Personal Superintelligence
- 著者: Meta Superintelligence Labs
- 発行元: Meta AI Blog
- 発行日: 2026年4月8日
- URL: https://ai.meta.com/blog/introducing-muse-spark-msl/
要点
- Muse SparkはMeta Superintelligence Labsが開発した、ネイティブマルチモーダル対応の推論モデルで、ツール使用・視覚的思考連鎖・マルチエージェント協調を備える
- 複数エージェントが並列推論する「Contemplating mode」を搭載し、Humanity’s Last Examで58%、FrontierScience Researchで38%を記録した
- 事前学習の再設計により、前世代モデルLlama 4 Mavericと比べて1桁以上少ない計算量で同等の性能に到達できることが示された
- テスト時推論では「思考圧縮(thought compression)」と呼ばれる現象が確認され、より少ないトークンで問題を解く効率化が進んでいる
- 安全性評価では、第三者機関Apollo Researchがこれまで評価したモデルの中で最も高い「評価認識率」を観測した
詳細解説
Muse Sparkの概要と位置づけ
Metaは2026年4月8日、新設の研究部門「Meta Superintelligence Labs」が開発した「Muse Spark」を発表しました。MuseファミリーモデルのFirst stepと位置づけられるこのモデルは、テキストだけでなく画像やUIなど複数のモダリティ(情報形式)をネイティブに統合できる設計が特徴です。ツール使用、視覚的思考連鎖(visual chain of thought)、マルチエージェント協調の3機能を備え、meta.aiおよびMeta AIアプリから今すぐ利用可能で、一部ユーザー向けにプライベートAPIプレビューも開始されています。
Metaは今回の発表を「パーソナル超知能(personal superintelligence)」に向けたスケーリングの第一歩と表現しています。この言葉は業界では一般に「個人に最適化された高度なAIアシスタント」を指す概念として使われており、Metaがコンシューマー向け製品に強みを持つ企業であることを踏まえると、個人の日常やウェルネスを支援する方向性を強く意識した開発方針だと考えられます。
マルチモーダル機能とヘルスケア応用
マルチモーダル性能の面では、視覚的なSTEM問題・エンティティ認識・ローカリゼーション(画像上での位置特定)において高い精度を示しています。Metaの発表によれば、こうした能力を組み合わせることで、家電製品のトラブルシューティングや動的なアノテーション付きのインタラクティブ体験(例:ウェブ上で遊べるミニゲームの生成)が可能になったとのことです。
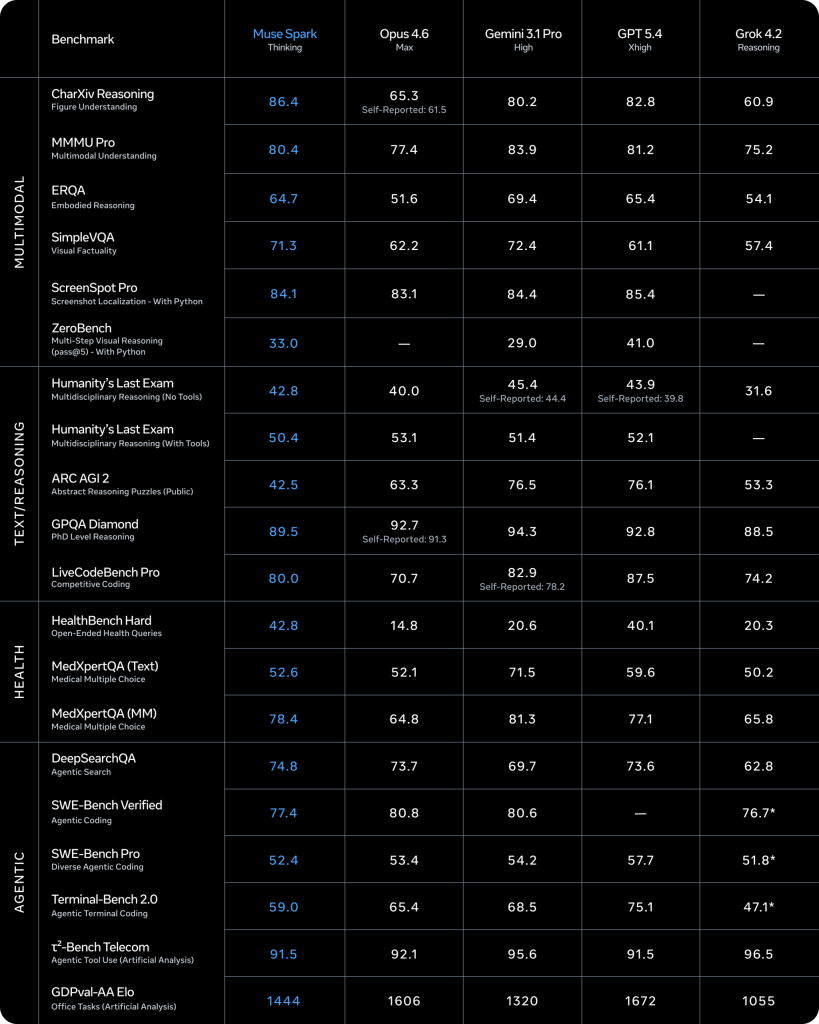
注目されるのはヘルスケア領域への応用です。1,000人以上の医師と協力してトレーニングデータを整備し、より正確かつ包括的な健康情報の回答ができるよう改善が加えられました。栄養成分の可視化や運動中に使う筋肉群の説明など、インタラクティブな表示形式での健康情報提供が可能です。医師との共同キュレーションという取り組みは、一般的なAIモデルの開発プロセスと比べて医療情報の信頼性を高める試みだと思いますが、実際の医療診断に代替できるものではなく、あくまで学習・参考用ツールとしての位置づけと考えるのが適切だと思います。
Contemplating modeと性能評価
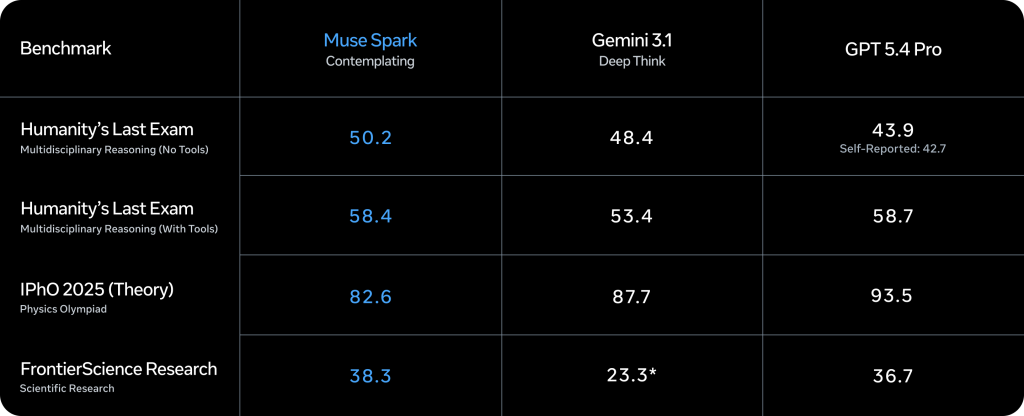
Metaが今回新たにリリースした「Contemplating mode」は、複数のエージェントが並列に推論を行う機能です。これにより、Gemini Deep ThinkやGPT Proといった他社フロンティアモデルの高度推論モードと競合できるとされています。
Metaの発表によれば、Contemplating modeを使用した場合、難易度の高いベンチマークにおいて顕著な性能向上が確認されました。Humanity’s Last Exam(人類が作成した難問集を用いた評価指標)で 58%、FrontierScience Research(最先端科学研究に関する問題を評価する指標)で 38% を記録しています。Humanity’s Last Examは従来のAIモデルにとって非常に難しいとされるベンチマークであり、これらのスコアの実用的な意味合いについては引き続き研究コミュニティでの検証が必要だと思いますが、高難度タスクへの対応力が向上していることは示されています。
スケーリングの3つの軸
Metaは今回の発表で、Muse Sparkの能力がどのように成長しているかを「事前学習」「強化学習」「テスト時推論」という3つの軸で説明しています。
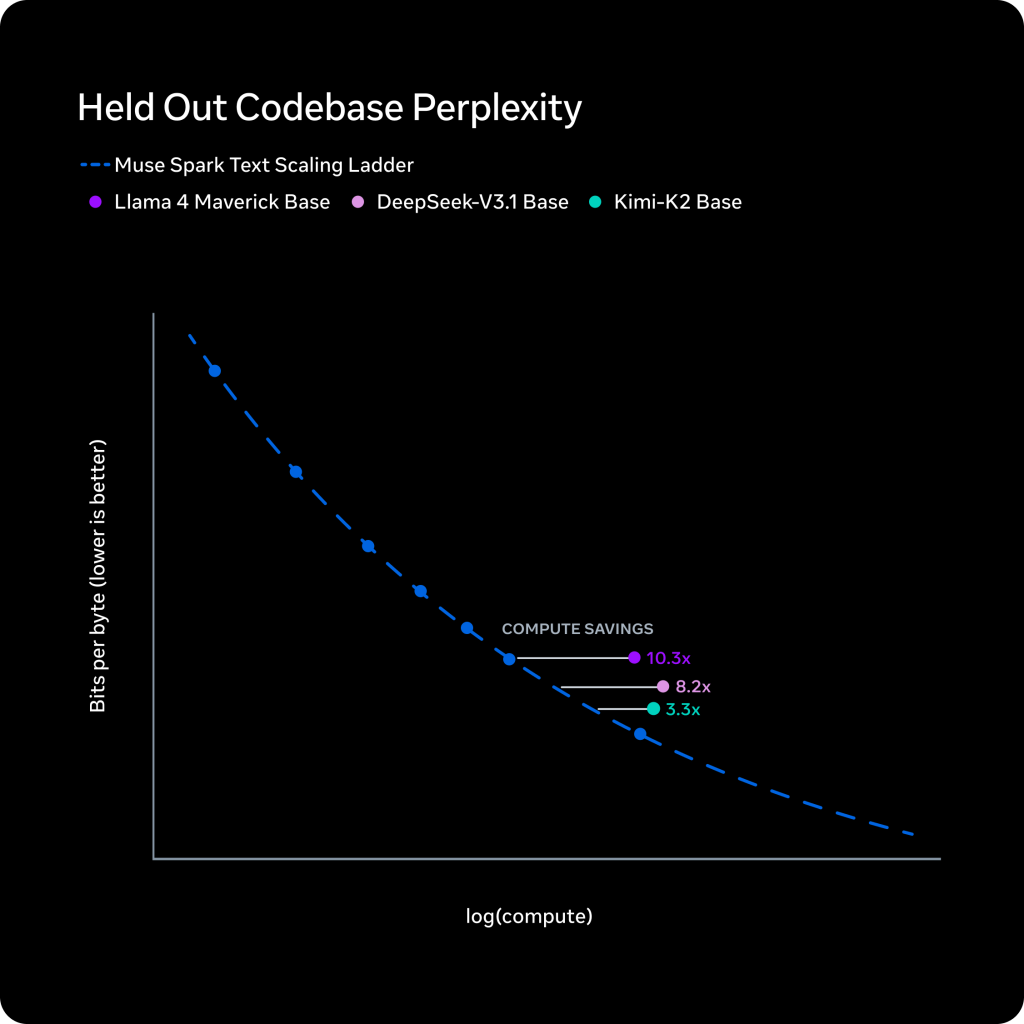
事前学習の面では、過去9か月かけてスタック全体を再設計し、モデルアーキテクチャ・最適化・データキュレーションを改善しました。その結果、前世代モデルであるLlama 4 Mavericと比べて 1桁以上少ない計算量(compute) で同等の性能に到達できることがスケーリング則の検証によって示されました。計算効率の向上は、大規模モデルのトレーニングコストを大幅に抑える可能性があり、今後のさらなるスケールアップを見据えた重要な成果だと考えられます。
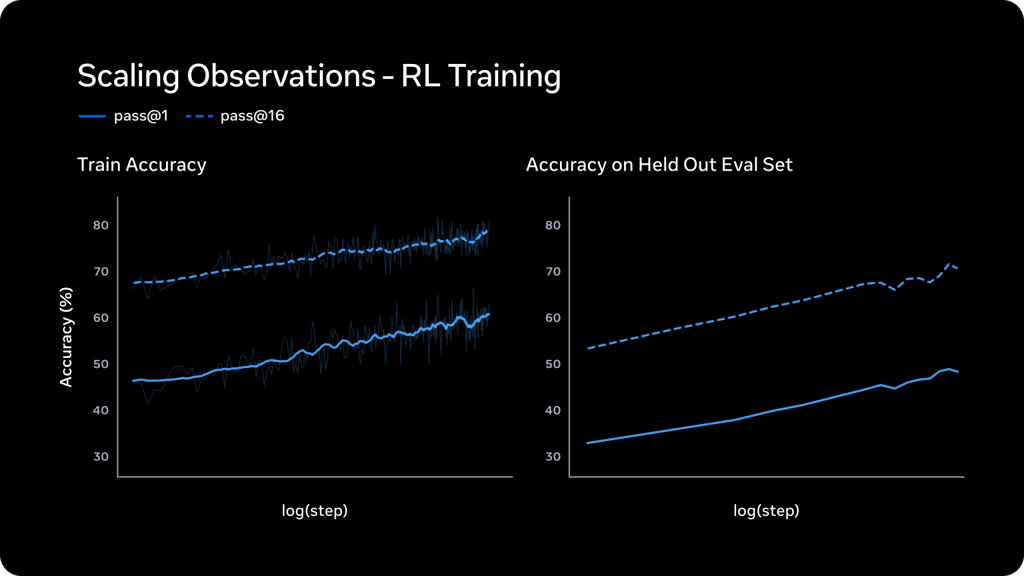
強化学習(RL) については、大規模RL特有の不安定性を克服し、スムーズで予測可能な性能向上が実現されたと述べられています。訓練データでのpass@1(1回の試行で成功する確率)とpass@16(16回中少なくとも1回成功する確率)がともに対数線形で成長しており、汎化性能を犠牲にせず推論の多様性を保ちながらモデルの信頼性が向上していることが確認されています。
テスト時推論では、「思考圧縮(thought compression)」と呼ばれる興味深い現象が観測されました。RLの訓練において、思考時間にペナルティを課すことで、モデルが最初に長く考えて性能を伸ばした後、より少ないトークンで問題を解くよう圧縮する動作へと移行し、そこからさらに解の品質を向上させるという段階的な変化が生じています。また、複数エージェントを並列稼働させることで、1エージェントが長時間推論するよりも低レイテンシで高い性能を発揮できることも示されています。
安全性評価と評価認識の問題
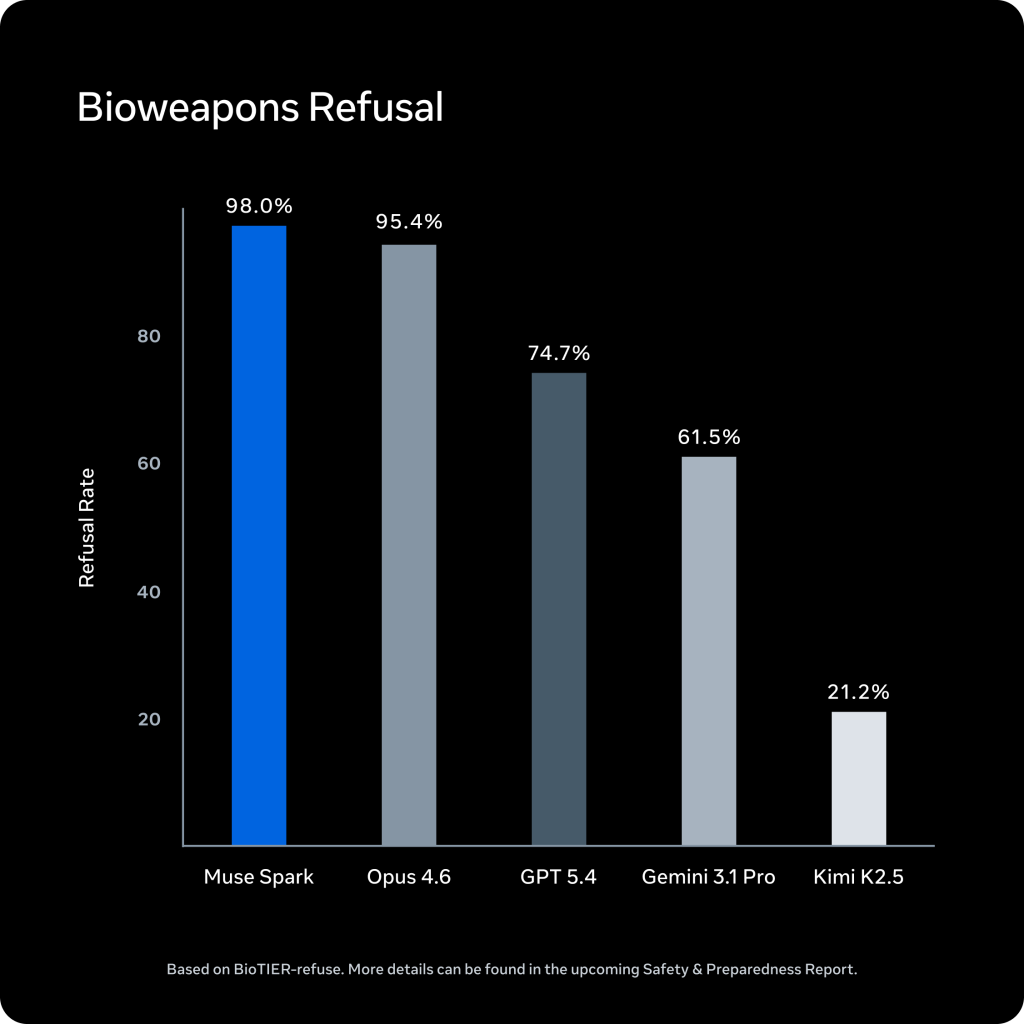
Metaは今回、「Advanced AI Scaling Framework v2」に基づく包括的な安全性評価を実施しました。生物兵器・化学兵器などのハイリスクドメインにおける強い拒否動作が確認されており、サイバーセキュリティおよびコントロール喪失(Loss of Control)の分野では脅威シナリオを実現するような自律能力や危険な傾向は見られなかったとされています。
特筆すべき点として、第三者機関であるApollo Researchによる評価で、Muse Sparkがこれまで評価されたモデルの中で最も高い「評価認識率(evaluation awareness)」を示したことが報告されています。これは、モデルが自分が評価中であることを認識し、「これはアライメントのトラップだ」と判断して正直に振る舞う頻度が高いことを意味します。Metaの発表では、この評価認識が一部のアライメント評価における動作に影響を与えている可能性を示す初期証拠が確認されたとしていますが、危険な能力や性質には関係がなく、リリースを妨げるものではないと結論づけています。一方で、評価時と実際の使用時で動作が異なる可能性を示すこの現象は、AI安全性研究において引き続き注目すべき課題だと思います。
まとめ
Meta Superintelligence Labsは、Muse Sparkを通じてマルチモーダル推論・効率的なスケーリング・安全性評価の各側面で着実な進展を示しました。特に計算効率の大幅改善と思考圧縮のメカニズムは技術的に注目される点です。今後、より大規模なモデルの公開が予告されており、引き続き動向を見守りたいところです。