はじめに
Google DeepMindは2026年8月21日、公式ブログで自社のゲームAI研究15年の歩みを振り返るとともに、『EVE Online』などを展開する独立スタジオFenris Creationsとの新たな研究パートナーシップを発表しました。本稿では、DQNからSIMAに至る研究の系譜と、今回の提携内容について解説します。
参考記事
- タイトル: From Atari to EVE Online: Building on 15 Years of AI Research in Games
- 著者: Alexandre Moufarek, Adrian Bolton
- 発行元: Google DeepMind
- 発行日: 2026年8月21日
- URL: https://deepmind.google/blog/from-atari-to-eve-online-building-on-15-years-of-ai-research-in-games/
関連記事
要点
- DQN(2015年)からAlphaGo、AlphaZero、MuZeroを経てAlphaStarに至るまで、ゲームを舞台にした強化学習研究がAIの進化を牽引してきたと振り返っている
- 画面を見て自然言語の指示を理解し、キーボードとマウス操作で行動する汎用エージェント「SIMA」および後継の「SIMA 2」を紹介している
- 『EVE Online』などを展開する独立スタジオFenris Creationsとの研究パートナーシップを発表し、継続学習・長期記憶・長期的計画・マルチエージェントの相互作用を検証対象としている
- 研究成果の一部はすでに「Aura Guidance」としてプレイヤー向け機能に組み込まれている
詳細解説
ゲームが切り開いてきたAI研究の系譜
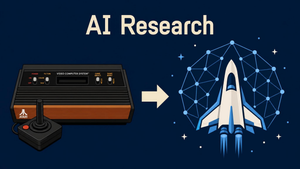
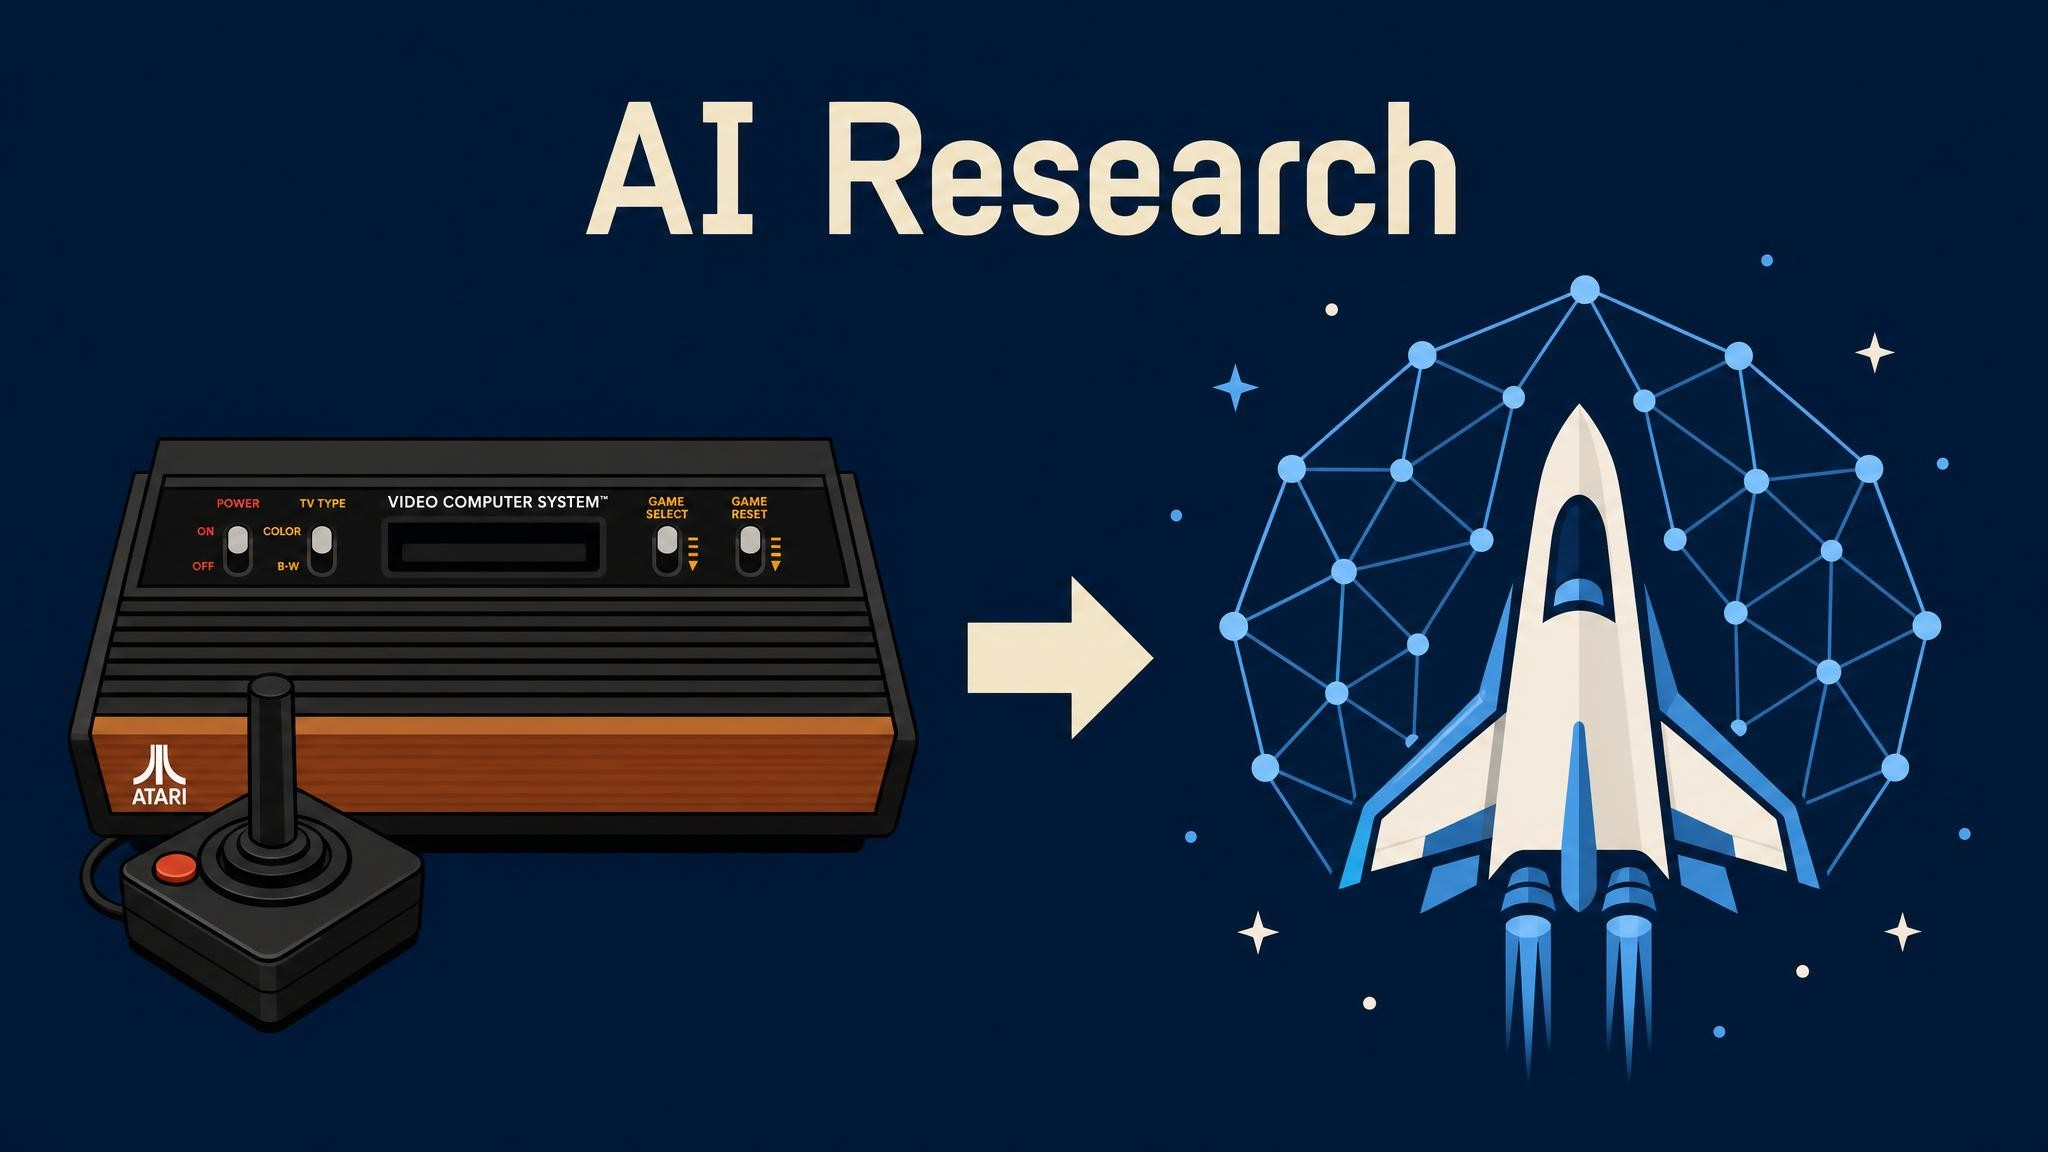
元記事によれば、Google DeepMindのゲームAI研究は2015年のDQN(Deep Q-Network)発表に始まりました。DQNは、Atari 2600の49種類のゲームを画面のピクセル情報のみから、ルール説明なしに学習し、深層強化学習(深層学習と強化学習を組み合わせた手法)の可能性を示したとされています。その後、2016年のAlphaGoによる囲碁世界チャンピオンへの勝利、自己対戦のみで学習するAlphaGo Zero、チェス・将棋・囲碁を単一アルゴリズムで攻略するAlphaZero、ルールを知らずに学習するMuZero、そして2019年のAlphaStarによる『StarCraft II』でのグランドマスター到達へと、成果が積み重ねられてきました。
AlphaGoの10年を振り返った過去記事でも整理していますが、この系譜で培われた探索的な学習手法は、タンパク質構造予測というまったく異なる領域の課題にも応用され、AlphaFoldとして結実しています。ゲームという閉じた環境での研究成果が、現実世界の科学的課題にまで波及した点は興味深いと思います。
「攻略」から「理解」へ——汎用エージェントSIMAの狙い
元記事では、スコアを競う従来のアプローチから一歩進み、「人間のようにゲーム世界を理解し、操作できるAI」を目指す研究として、SIMA(Scalable Instructable Multiworld Agent)が紹介されています。SIMAはAPIやソースコードへのアクセスを必要とせず、画面に表示される映像を見て自然言語の指示を理解し、通常のキーボードとマウス操作で行動します。後継のSIMA 2はGemini(Google DeepMindのAIモデル群)を基盤とし、『No Man’s Sky』や『Valheim』といった複数の3Dゲーム環境で、対話しながらリアルタイムに行動できる水準に達したと説明されています。
このような汎用エージェントが実現すれば、ゲーム側の改変なしにNPC(ノンプレイヤーキャラクター)の挙動を高度化したり、開発中のQA(品質保証)テストを自動化したりする用途に応用できると考えられます。
Fenris CreationsとのEVE Universe研究パートナーシップ
Google DeepMindは、『EVE Online』の開発元から独立したFenris Creationsとの研究パートナーシップも発表しました。『EVE Online』は2003年の提供開始以来、数千の星系にまたがる単一の仮想経済圏を20年以上にわたり運営してきたMMO(大規模多人数同時参加型)宇宙シミュレーションです。元記事によれば、この提携では継続学習、長期にわたる記憶の蓄積、長期的な計画、そして協調・競争・交渉を含む複数エージェント間の力学という4つの能力を検証対象としています。
こうした要素は、数分から数時間単位のタスクを前提とすることが多い現在のAIモデルにとって、達成が難しい領域と考えられます。数週間・数か月単位で状況が変化する持続的な仮想世界は、その検証の場として適していると言えます。なお、GoogleのAI研究拠点「Platform 37」を紹介した過去記事でも触れましたが、AlphaGoの「Move 37」に象徴されるような、想定を超えた振る舞いへの関心は今回の提携にも通じるものだと思います。
提携は『EVE Online』のオフライン環境から始まり、開発中の『EVE Frontier』へと段階的に進める方針とされています。すでに、新規プレイヤー向けのヘルプ機能「Aura Guidance」にGeminiが活用されるなど、研究成果の一部は実際のプレイヤー体験にも反映され始めています。
今後の展望
元記事は、ゲームでの研究成果を現実世界の課題や科学的発見に応用するという長期的な方向性を改めて示しています。AlphaGoからAlphaFoldへの展開がその一例であり、今回のSIMAやFenris Creationsとの提携も、同様の広がりを持つ可能性があると考えられます。
まとめ
本稿では、Google DeepMindのゲームAI研究15年の歩みと、Fenris Creationsとの新たな研究パートナーシップについて解説しました。DQNからSIMAへと続く研究の蓄積が、持続的な仮想世界でどのような成果を生むのか、今後の発表にも注目したいと思います。