はじめに
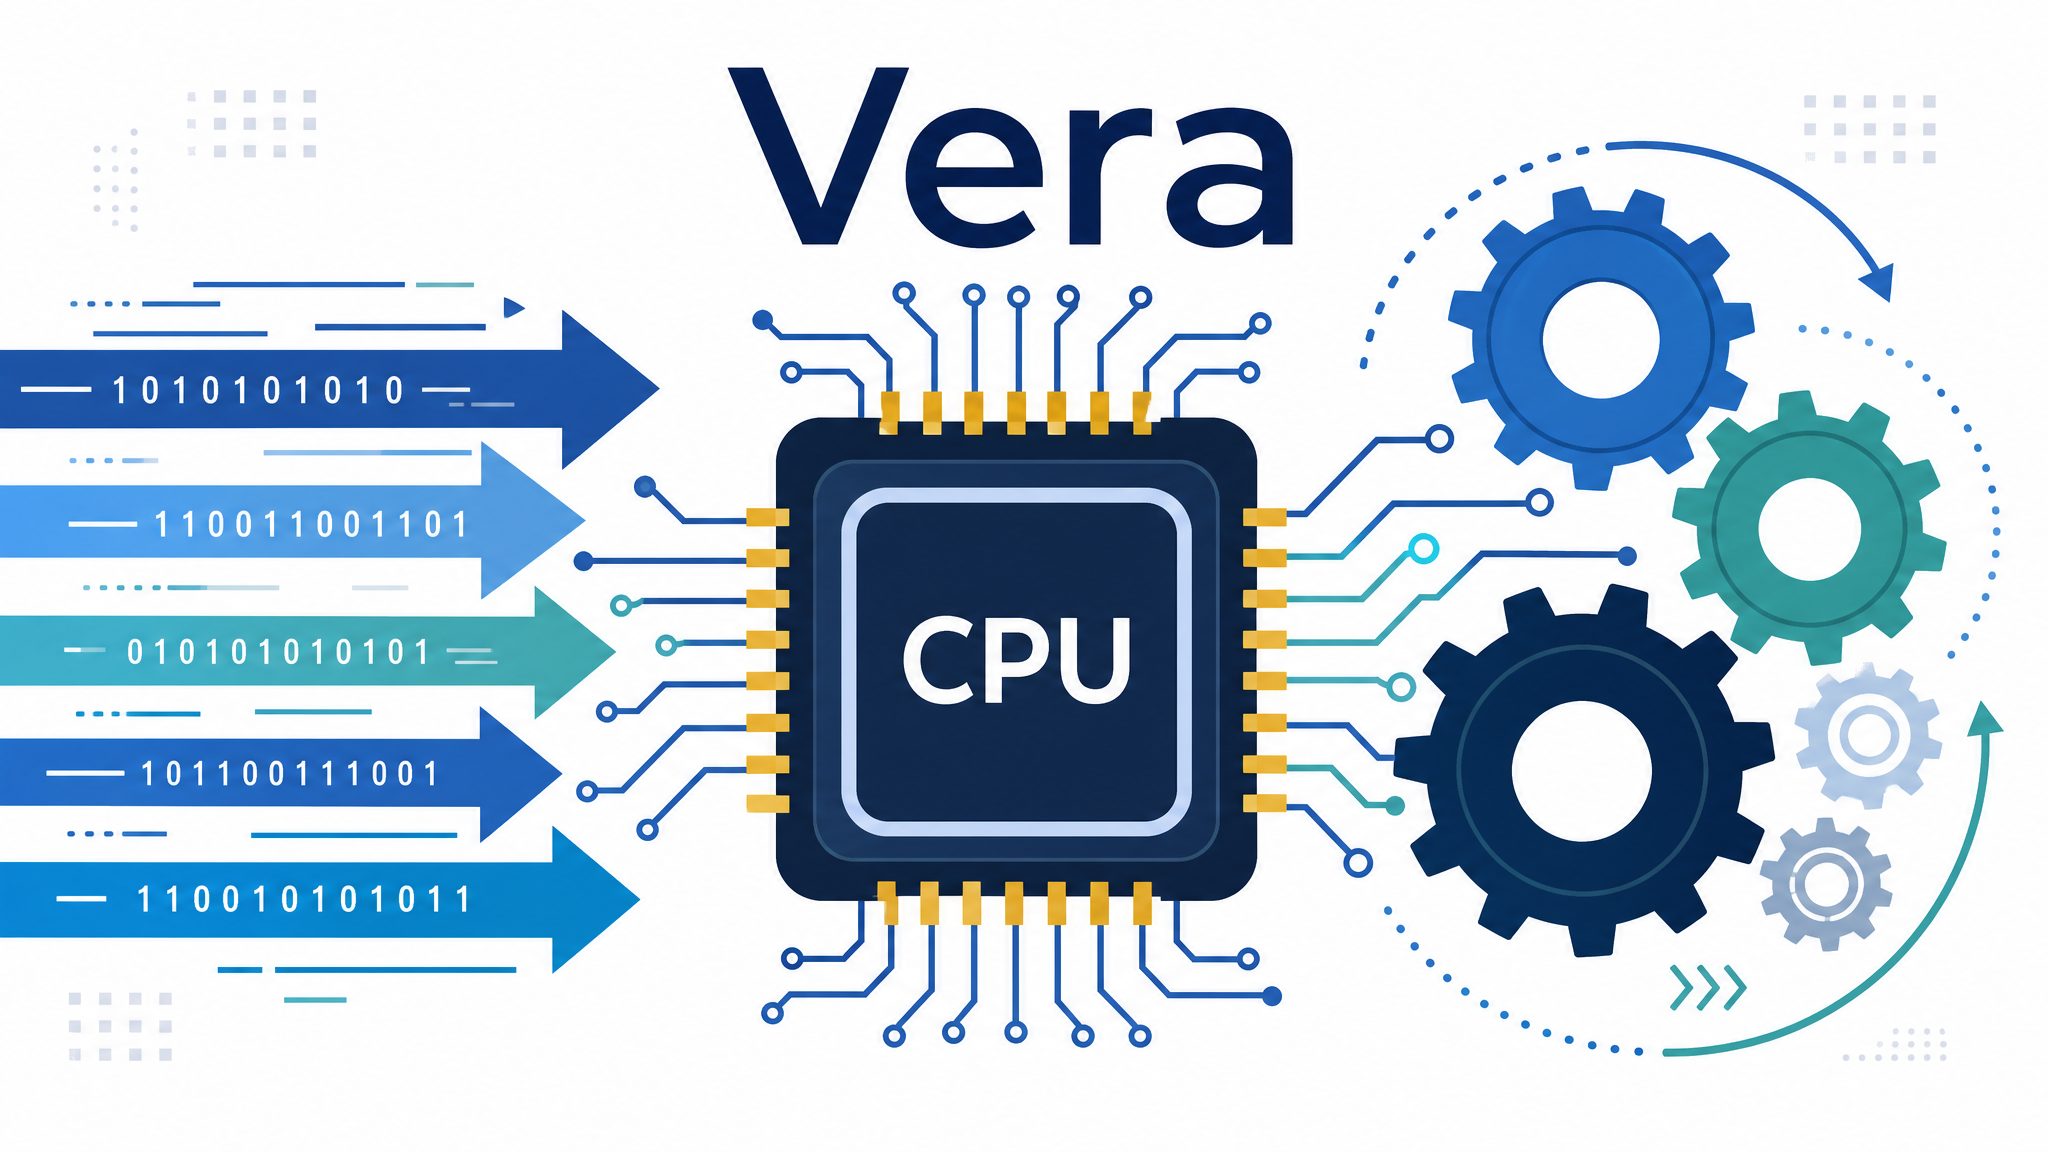
NVIDIAは2026年7月7日、AIエージェント時代に向けた新しいCPU「Vera」についてのブログ記事を公開しました。本稿では、Veraが提唱する「Max Single-Threaded CPU at Scale」という設計思想と、Perplexityなど採用企業の検証結果について解説します。
参考記事
- タイトル: AI Innovators Adopt NVIDIA Vera — Why Max Single-Threaded CPU at Scale Matters
- 著者: Ian Buck
- 発行元: NVIDIA Blog
- 発行日: 2026年7月7日
- URL: https://blogs.nvidia.com/blog/nvidia-vera-max-single-threaded-cpu-at-scale/
関連記事
要点
- NVIDIA Veraは、AIエージェントのループ処理(ツール呼び出し・コード実行・データ処理など)に最適化された「Max Single-Threaded CPU at Scale」という新しいカテゴリのCPUである
- Veraはカスタムコア「Olympus」を搭載し、従来モデルのGraceと比較して1サイクルあたりの命令処理数(IPC)が50%向上している
- 最大1.2TB/sのLPDDR5Xメモリ帯域幅と3.4TB/sのコア間帯域幅により、88基すべてのコアが性能を落とすことなく稼働できる設計である
- Perplexityが実際のコーディングワークロードでVeraを検証し、x86と比較して約1.5倍高速な処理を確認したと報告している
- NVIDIAは次世代CPU「Rosa」と新コア「Rigel」の開発も進めており、CPUロードマップを継続する方針である
詳細解説
なぜ「単一スレッド性能」がAIエージェントに重要なのか
NVIDIAによれば、AIエージェントは一度のリクエストで完結するのではなく、推論・ツール実行・結果の受け取り・次の判断というループを繰り返しながら動作します。このループの中でCPUは、ツール呼び出しやコード実行、データ処理、KVキャッシュ(モデルが過去の計算結果を再利用する仕組み)の管理など、モデルの指示を実際に処理する役割を担っています。
従来のデータセンター向けCPUは、コスト効率を重視してコア数を増やす方向で進化してきました。しかし、コア数を増やしても個々のエージェントループの1ステップを高速化することはできません。むしろ、コア数を優先した設計ではリソースの奪い合いによって各コアの性能が低下する場合があると考えられます。エージェントの各ステップは前のステップの結果に依存するため、コアあたりの処理速度がループ全体の進行速度を左右すると言えます。
NVIDIA Veraの技術的な特徴
NVIDIAは、この課題に対応する新しいCPUのカテゴリとして「Max Single-Threaded CPU at Scale」を提唱しており、その第一弾となるのがVeraです。Veraにはカスタムコア「Olympus」が搭載されており、NVIDIAによれば従来のGraceと比較して1サイクルあたりの命令処理数(IPC、CPUが1回の動作でどれだけ多くの命令を処理できるかを示す指標)が50%向上しているとのことです。
さらに、最大1.2TB/sのLPDDR5Xメモリ帯域幅を40ワット未満の消費電力で実現しており、モノリシック(単一チップで構成される)な設計により3.4TB/sのコア間帯域幅を確保しています。これにより、88基あるコアすべてが性能を落とすことなく稼働できる点が特徴です。複数の小さなチップを組み合わせるチップレット構成のCPUでは、各コアが利用できるメモリ性能に制約が生じる課題があるとされていますが、Veraはこの点を回避する設計を採用していると考えられます。
なお、Veraは2026年1月のCESで発表されたVera Rubinプラットフォームの一部であり、GPUを搭載する基盤としても機能します。
実測性能とPerplexityの採用事例
NVIDIAによれば、負荷のかかったエージェント処理を想定したワークロードにおいて、Veraはx86と比較して1.8倍のコアあたり持続性能を記録したとのことです。Perplexityが実際に行ったコーディングワークロードの検証では、リポジトリのクローンとテストスイートの実行という一連の作業がx86と比べて約1.5倍高速に完了し、複数のサンドボックスの起動も最大1.9倍高速だったと報告されています。Perplexityは、今後の本番システムへのVeraの導入を検討しているとのことです。
このほか、データ処理の領域でもStarburstとの検証で大規模SQL分析が3倍高速化し、Redpandaとのリアルタイムストリーミング処理では最大6倍のレイテンシ低減が確認されたとNVIDIAは説明しています。エージェントは推論だけでなく、データの検索・フィルタリング・移動といった処理も頻繁に行うため、こうした周辺処理の高速化も実用上の効果につながると考えられます。
今後の展望——次世代CPU「Rosa」
NVIDIAは、次世代CPU「Rosa」とその新コア「Rigel」の開発も進めていると発表しています。RigelはArm v9.2アーキテクチャに基づく次世代コアで、同じシリコン面積を保ちながらOlympusよりも高い性能を実現するとされています。命令供給の改善やL2キャッシュの拡大、メモリ処理の効率化などが主な改善点として挙げられています。
AIエージェントが今後さらに普及していく中で、こうしたCPU側の性能向上が、GPUの稼働率を高めながらエージェント処理全体のコストパフォーマンスを改善する一因になると考えられます。
まとめ
NVIDIA Veraは、AIエージェントのループ処理という新しい負荷特性に合わせて設計されたCPUであり、Perplexityなどの採用事例からもその効果がうかがえます。エージェントの仕組み自体について詳しく知りたい方は、過去記事でも整理していますので、あわせてご覧いただければと思います。